Como Citar Base de Dados e Dataset nas Normas ABNT: Guia Completo
Aprenda como citar bases de dados e datasets nas normas ABNT. Guia completo com exemplos de referências, citações no texto, DOI, IBGE, DATASUS, Banco Mundial, Zenodo, SciELO Data, Kaggle, GitHub, APIs e orientações para documentar dados utilizados em TCCs e pesquisas científicas.
Como Citar Base de Dados e Dataset nas Normas ABNT: Guia Completo
Usar dados do IBGE, DATASUS, Banco Mundial, SciELO Data, Zenodo, Kaggle, GitHub ou de um repositório científico pode parecer simples: localizar a informação, baixar o arquivo e utilizá-lo no TCC. A dificuldade aparece quando chega o momento de responder a uma pergunta aparentemente básica: como citar uma base de dados ou um dataset nas normas ABNT?
Atualizado em Outubro de 2026
Por Equipe Editorial do TCC&Monografia
A resposta exige mais cuidado do que copiar o endereço da página em que os dados foram encontrados.
Antes de montar a referência, é necessário identificar qual objeto foi efetivamente utilizado. Uma base de dados inteira não é necessariamente a mesma coisa que um dataset específico. Um dataset não é necessariamente a mesma coisa que um arquivo CSV. A página de um repositório não é o próprio conjunto de dados. E um artigo que descreve determinado conjunto também não deve ser confundido com os dados disponibilizados separadamente.
Essa distinção é fundamental porque pesquisas acadêmicas atuais podem utilizar dados de maneiras muito diferentes. O estudante pode:
- consultar uma tabela do IBGE;
- baixar microdados de uma pesquisa;
- gerar uma tabulação no DATASUS;
- utilizar um indicador do Banco Mundial;
- baixar um dataset com DOI;
- obter arquivos depositados no Zenodo ou SciELO Data;
- usar um conjunto encontrado no Kaggle;
- recuperar dados por API;
- utilizar arquivos CSV, XLSX, JSON ou outros formatos;
- combinar diferentes bases;
- criar um dataset derivado;
- analisar dados coletados pelo próprio pesquisador.
Cada situação pode exigir uma combinação diferente de identificação bibliográfica e documentação metodológica.
Resumo rápido
Para citar base de dados ou dataset corretamente, comece identificando o objeto que realmente forneceu os dados. Depois, registre os metadados disponíveis, como responsável, título, data, versão, instituição ou repositório, DOI ou outro identificador e informações de disponibilidade e acesso.
Não tente colocar toda a metodologia dentro da referência. Utilize a referência para identificar o recurso e a metodologia para explicar como os dados foram selecionados, filtrados, transformados e analisados.
Ao longo deste guia, você aprenderá como lidar tanto com situações relativamente simples quanto com cenários avançados envolvendo versionamento, APIs, datasets dinâmicos, microdados, bases combinadas, dados derivados e reprodutibilidade.
O objetivo não é oferecer uma fórmula artificialmente única para qualquer conjunto de dados. O objetivo é mostrar como identificar corretamente o recurso e documentar seu uso de maneira coerente.
Como citar base de dados e dataset nas normas ABNT?
Em termos práticos, uma referência de dataset deve ser construída a partir dos elementos bibliográficos realmente disponíveis para o recurso utilizado.
Dependendo do conjunto, esses elementos podem incluir:
- autor pessoal ou instituição responsável;
- título do dataset;
- versão;
- data;
- repositório ou instituição responsável pela disponibilização;
- DOI, Handle ou outro identificador persistente;
- endereço eletrônico;
- informações de acesso, quando pertinentes.
Um modelo estrutural didático pode ser representado assim:
RESPONSÁVEL. Título do conjunto de dados. Versão, quando pertinente. Repositório ou instituição, data. Identificador persistente e/ou informações de disponibilidade e acesso, conforme o recurso.
Esse modelo não deve ser tratado como fórmula universal.
Uma tabela consultada no SIDRA, por exemplo, possui características diferentes de um dataset depositado no Zenodo com DOI e controle formal de versões. Da mesma forma, uma consulta ao DATASUS não deve ser documentada exatamente como um arquivo estático disponibilizado por um repositório científico.
Atenção
Antes de copiar qualquer modelo de referência, descubra exatamente o que você utilizou. Grande parte dos erros na citação de dados começa quando o pesquisador tenta formatar a referência antes de identificar o objeto.
Uma regra prática acompanhará todo este guia:
A referência identifica o objeto. A citação atribui a informação. A metodologia explica como os dados foram utilizados.
Essa separação evita referências excessivamente longas e, ao mesmo tempo, metodologias vagas.
Quais fontes de dados aparecem com frequência em TCCs e pesquisas?
Estudantes e pesquisadores podem trabalhar com dados provenientes de diferentes ambientes. Entre os mais frequentes estão:
- IBGE;
- SIDRA;
- DATASUS;
- TABNET;
- Banco Mundial;
- portais governamentais;
- repositórios institucionais;
- Zenodo;
- SciELO Data;
- Figshare;
- Dryad;
- OSF;
- Dataverse;
- Kaggle;
- GitHub;
- APIs públicas;
- datasets disponibilizados junto a artigos científicos.
Mas o nome da plataforma, instituição ou portal não responde sozinho à pergunta bibliográfica.
Se você encontrou um conjunto no Kaggle, por exemplo, ainda precisa verificar quem produziu os dados. Se encontrou um dataset no Zenodo, deve consultar os criadores e os metadados do registro específico. Se utilizou o DATASUS, pode ser necessário identificar qual sistema de informação originou os dados.
Portanto:
onde você encontrou os dados não é necessariamente quem produziu os dados.
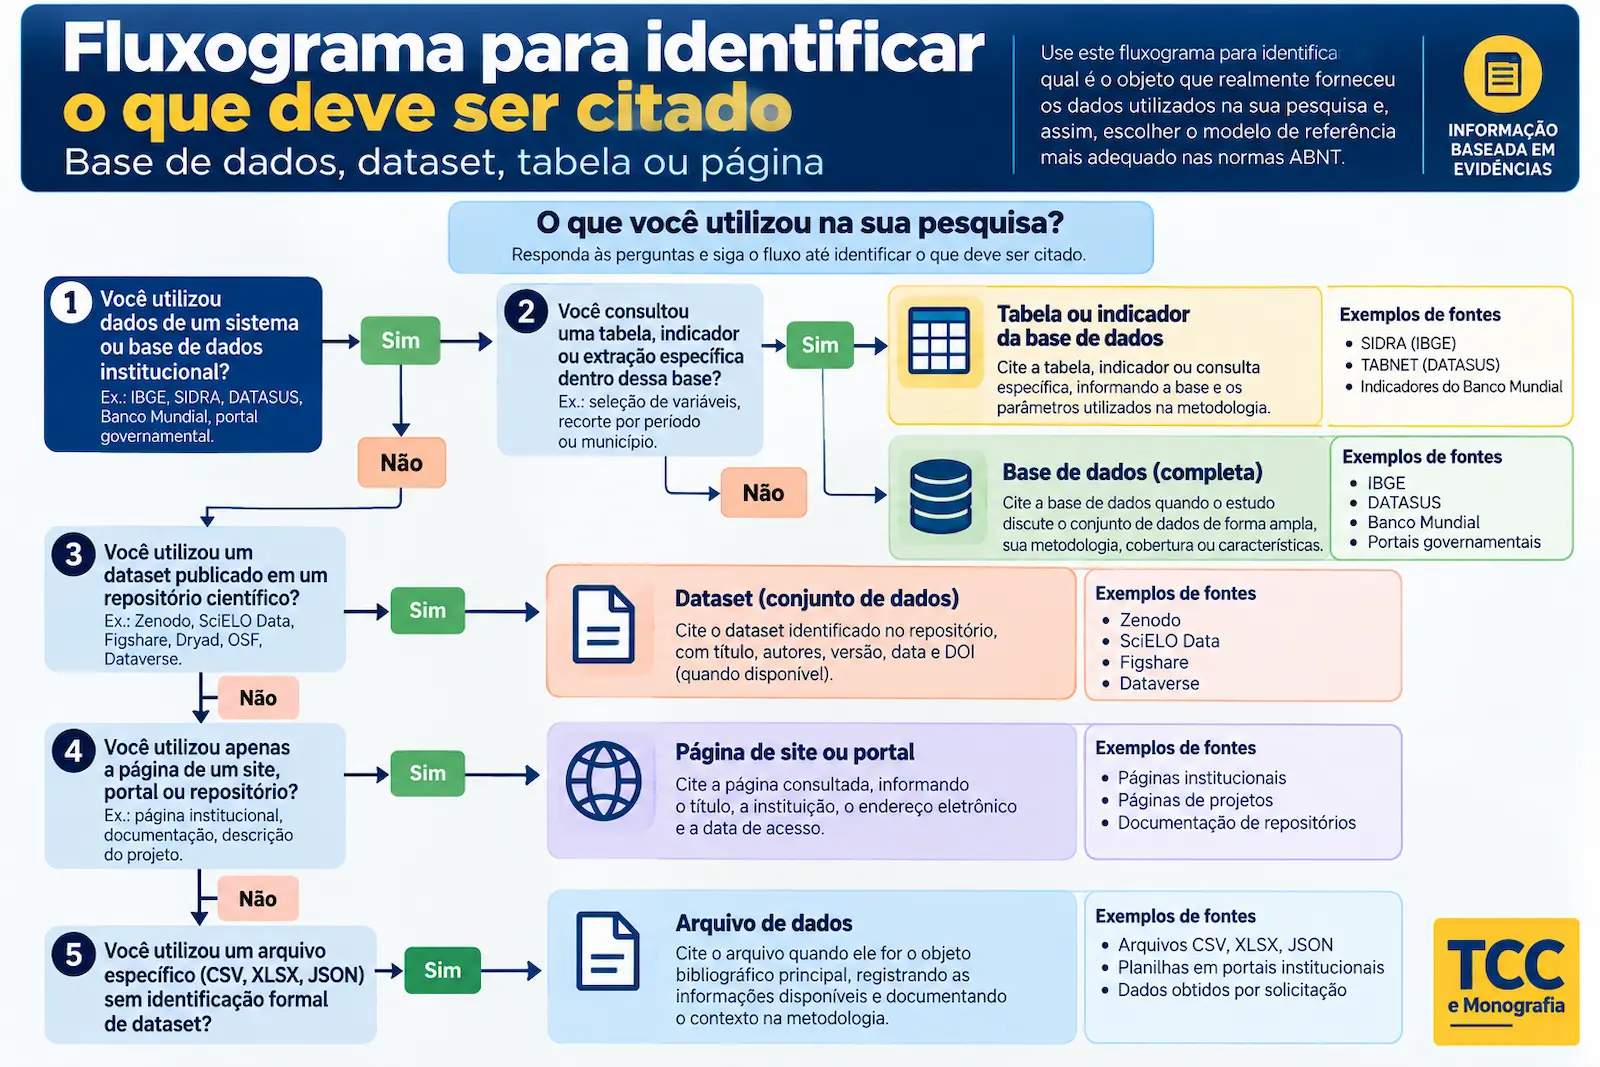
Neste guia você vai aprender
- Base de dados e dataset são a mesma coisa?
- O que a ABNT diz sobre bases de dados e datasets?
- Quando uma base de dados precisa ser citada?
- Antes de citar: identifique exatamente o que foi utilizado
- Quais dados devem ser registrados antes de citar um dataset?
- Como montar a referência de um dataset?
- Como citar base de dados ou dataset no texto?
- Como citar dataset com DOI?
- Como citar dataset do Zenodo?
- Como citar dataset do SciELO Data?
- Como citar dados do IBGE?
- Como citar dados do DATASUS?
- Como citar dados do Banco Mundial?
- Como citar dataset do Kaggle?
- Como citar datasets de repositórios institucionais?
- Como citar tabela criada a partir de uma base de dados?
- Como citar gráfico criado a partir de um dataset?
- Como citar dados obtidos por API?
- Como citar dataset atualizado continuamente?
- Qual versão do dataset deve ser citada?
- Como citar dataset sem DOI?
- Dados públicos precisam ser citados?
- Como documentar dados coletados pelo próprio pesquisador?
- Como citar dados restritos, confidenciais ou sensíveis?
- Devo citar o dataset ou o artigo que o descreve?
- Dataset, software, repositório e artigo: qual é a diferença?
- Como descrever o dataset na metodologia do TCC?
- Por que a referência não substitui a metodologia?
- Como citar dados secundários?
- Como citar apenas parte de um dataset?
- Como lidar com CSV, Excel, JSON e outros formatos?
- Como citar dataset disponibilizado no GitHub?
- Como citar dados obtidos pela combinação de diferentes bases?
- Como documentar um dataset derivado?
- Exemplos práticos de citação de bases de dados e datasets
- Erros comuns ao citar base de dados e dataset
- Passo a passo definitivo
- Matriz de decisão: o que devo citar?
- Checklist final
- Perguntas frequentes
- Conclusão
Base de dados e dataset são a mesma coisa?
Os termos são frequentemente usados como sinônimos em conversas informais, mas podem representar níveis diferentes de organização dos dados.
Entender essa diferença ajuda a escolher corretamente o objeto que será citado.
O que é uma base de dados?
Uma base de dados pode ser entendida, de maneira ampla, como uma estrutura organizada que reúne informações e permite armazenamento, consulta, atualização, recuperação ou processamento.
Ela pode conter:
- diversas tabelas;
- múltiplas séries históricas;
- registros de diferentes períodos;
- dados provenientes de diferentes sistemas;
- múltiplos conjuntos disponíveis para extração.
Um portal estatístico, por exemplo, pode disponibilizar centenas ou milhares de tabelas e séries.
Dizer apenas que o pesquisador “utilizou a base” pode ser pouco específico quando somente uma parcela foi efetivamente analisada.
O que é um dataset?
Um dataset, ou conjunto de dados, normalmente corresponde a um conjunto delimitado de informações organizado para determinado uso, pesquisa, análise ou compartilhamento.
Ele pode conter:
- uma ou várias tabelas;
- arquivos CSV;
- planilhas;
- imagens;
- dados geográficos;
- textos;
- registros experimentais;
- arquivos de diferentes formatos;
- documentação auxiliar.
Em repositórios científicos, um dataset pode possuir:
- título próprio;
- autores ou criadores;
- data;
- versão;
- descrição;
- licença;
- arquivos;
- DOI ou outro identificador persistente.
Nesse cenário, o dataset funciona como um objeto de pesquisa identificável e citável.
O que é um repositório de dados?
Um repositório é o ambiente utilizado para depositar, organizar, preservar e disponibilizar objetos de pesquisa.
Ele pode hospedar muitos datasets produzidos por diferentes pessoas e instituições.
Por isso:
repositório ≠ dataset.
Zenodo, SciELO Data, Figshare, Dryad e diferentes instalações de Dataverse podem funcionar como ambientes de disponibilização, enquanto o objeto citado é um conjunto específico armazenado nesses ambientes.
O que é um arquivo de dados?
Um arquivo pode ser apenas uma parte de um dataset.
Imagine um conjunto com:
dados_2024.csv;dicionario_variaveis.xlsx;readme.txt;metodologia.pdf.
O dataset é o conjunto organizado. Cada arquivo exerce uma função dentro dele.
Isso não impede que um arquivo específico precise ser identificado na metodologia quando somente ele foi utilizado.
O que é uma tabela extraída de uma base?
Uma tabela pode representar apenas uma consulta ou recorte produzido a partir de uma base mais ampla.
Por exemplo, o estudante pode acessar um sistema estatístico e selecionar:
- uma variável;
- um período;
- um estado;
- determinadas categorias.
O resultado dessa operação pode ser uma tabela que não existia previamente exatamente naquele formato.
Nesse caso, é importante documentar tanto a fonte quanto os filtros que produziram o resultado.
Comparação rápida
| Objeto | O que representa | Exemplo de função |
|---|---|---|
| Base de dados | Estrutura ampla de informações | Armazenar e permitir consultas |
| Dataset | Conjunto delimitado de dados | Objeto utilizado ou compartilhado para análise |
| Repositório | Ambiente de depósito e preservação | Hospedar datasets |
| Arquivo | Componente físico ou digital | Armazenar parte dos dados |
| Tabela | Organização ou recorte de informações | Apresentar resultados de uma consulta |
| API | Interface de acesso programático | Permitir recuperação estruturada dos dados |
Visão do especialista
A pergunta mais importante não é “qual desses termos é universalmente correto?”, mas qual objeto possui a granularidade adequada para representar aquilo que efetivamente entrou na análise.
O que a ABNT diz sobre bases de dados e datasets?
Para compreender a citação de dados em trabalhos acadêmicos, é importante separar as funções desempenhadas pelas diferentes normas e pelas boas práticas contemporâneas de gestão de dados.
Entre as normas particularmente relevantes para este tema estão:
- ABNT NBR 6023 — relacionada à elaboração de referências;
- ABNT NBR 10520 — relacionada às citações em documentos;
- ABNT NBR 14724 — relacionada à apresentação de trabalhos acadêmicos.
Essas normas não devem ser tratadas como se todas regulassem exatamente a mesma etapa do processo.
Referência e citação não são a mesma coisa
A referência identifica bibliograficamente a fonte.
A citação estabelece a relação entre uma informação utilizada no texto e sua fonte.
Em um TCC que reutiliza dados, ainda existe uma terceira dimensão:
a metodologia.
Ela explica como os dados foram:
- obtidos;
- selecionados;
- filtrados;
- tratados;
- combinados;
- analisados.
Portanto, uma referência bibliográfica correta não elimina a necessidade de documentação metodológica.
ABNT e boas práticas de citação de dados
O ecossistema contemporâneo de pesquisa também utiliza recomendações relacionadas a:
- identificadores persistentes;
- versionamento;
- proveniência;
- reprodutibilidade;
- preservação;
- ciência aberta.
Essas recomendações podem ser extremamente úteis para melhorar a qualidade da documentação.
Entretanto, é necessário evitar um erro editorial importante:
uma boa prática científica não se transforma automaticamente em exigência universal da ABNT.
Da mesma forma, uma orientação de determinado repositório não deve ser apresentada automaticamente como regra da ABNT.
Quatro níveis que precisam permanecer separados
| Nível | Função |
|---|---|
| Normas ABNT | Orientar referências, citações e apresentação conforme o escopo de cada norma |
| Metadados do recurso | Informar autoria, título, versão, identificadores e outros elementos do objeto |
| Regras institucionais | Definir procedimentos adotados pela universidade, curso ou periódico |
| Boas práticas científicas | Melhorar identificação, transparência, proveniência e reprodutibilidade |
Essa distinção será mantida em todo o artigo.
Atenção
Não trate afirmações como “todo dataset precisa obrigatoriamente de DOI”, “todo conjunto deve ter versão” ou “toda base precisa de snapshot” como regras universais da ABNT. Esses elementos podem ser extremamente úteis e, em determinados contextos, necessários, mas sua aplicação depende do objeto, dos metadados, da instituição e das exigências da pesquisa.
Princípios de citação de dados e ciência aberta
Iniciativas internacionais de citação de dados defendem que conjuntos utilizados em pesquisas sejam tratados como produtos identificáveis e citáveis, permitindo reconhecimento, localização e verificação.
Entre os princípios frequentemente associados às boas práticas de citação de dados estão:
- importância dos dados como produtos de pesquisa;
- crédito e atribuição;
- identificação única;
- acesso;
- persistência;
- especificidade;
- verificabilidade.
Esses princípios são particularmente úteis quando um trabalho reutiliza datasets depositados em repositórios científicos.
Mas devem ser apresentados corretamente:
eles complementam a discussão sobre documentação e reprodutibilidade; não substituem as normas ABNT.
O que isso muda na prática?
Na prática, o estudante não deve procurar apenas “um modelo pronto”.
Ele precisa realizar uma sequência de decisões:
- identificar o objeto utilizado;
- recuperar seus metadados;
- verificar quem responde pelo recurso;
- registrar versão ou estado quando pertinente;
- verificar identificadores;
- documentar disponibilidade e acesso;
- construir a referência;
- fazer a citação;
- explicar o uso dos dados na metodologia.
Essa sequência evita tanto erros bibliográficos quanto falhas metodológicas.
Quando uma base de dados precisa ser citada?
Uma base ou conjunto de dados deve ser adequadamente identificado quando exerce função relevante como fonte de informação, evidência ou material analítico no trabalho.
Isso ocorre, por exemplo, quando o pesquisador:
- utiliza números extraídos da base;
- calcula indicadores a partir dos dados;
- produz tabelas;
- produz gráficos;
- realiza análise estatística;
- treina ou avalia modelos;
- compara regiões ou períodos;
- reutiliza microdados;
- combina informações provenientes de diferentes fontes;
- constrói uma base derivada.
Dados públicos também devem ser identificados
O fato de um conjunto ser público não elimina a necessidade de reconhecer sua origem.
Da mesma forma, o fato de os dados serem gratuitos não significa que não exista autoria, responsabilidade institucional, documentação ou licença.
Se os dados contribuíram materialmente para o trabalho, sua proveniência deve permanecer identificável.
Consultar uma página é diferente de reutilizar dados
Imagine duas situações.
Situação A: você acessa uma página do IBGE apenas para compreender como determinada pesquisa é realizada.
Situação B: você baixa os microdados dessa pesquisa e calcula seus próprios resultados.
As duas situações envolvem o IBGE, mas os objetos e usos são diferentes.
No segundo caso, a documentação metodológica ganha importância muito maior, porque o resultado depende diretamente do processamento realizado pelo pesquisador.
O dataset deve aparecer somente na lista de referências?
Não necessariamente.
Dependendo de sua função, ele pode aparecer:
- na metodologia;
- em citações no corpo do texto;
- na fonte de tabelas;
- na fonte de gráficos;
- na lista de referências;
- em apêndices ou documentação suplementar, quando pertinente.
O importante é que essas diferentes ocorrências sejam coerentes entre si.
Boa prática
Se um dataset foi importante o suficiente para produzir resultados do TCC, registre seus metadados no momento em que começar a utilizá-lo. Não espere a revisão bibliográfica final para tentar reconstruir autoria, versão, DOI, arquivos e data de extração.
Antes de citar: identifique exatamente o que foi utilizado
Essa é uma das etapas mais importantes de todo o processo.
Antes de construir a referência, pergunte:
Qual objeto entrou efetivamente na minha análise?
A resposta pode ser muito mais específica do que o nome do site visitado.
Você utilizou a base inteira?
Em muitos casos, não.
Uma grande base pode conter:
- décadas de dados;
- milhares de localidades;
- centenas de variáveis;
- diversos arquivos;
- várias pesquisas.
Seu TCC pode utilizar apenas:
- um período de cinco anos;
- uma região;
- quatro variáveis;
- um arquivo;
- uma tabela específica.
A referência identifica a fonte. A metodologia descreve esse recorte.
Você utilizou um dataset formalmente publicado?
Quando o conjunto possui registro próprio, procure:
- título;
- criadores;
- versão;
- data;
- DOI;
- licença;
- repositório;
- arquivos;
- documentação relacionada.
Esses metadados ajudam a construir uma referência muito mais precisa do que citar apenas a página inicial do repositório.
Você utilizou uma tabela gerada por consulta?
Nesse caso, preserve:
- nome ou número da tabela;
- variáveis;
- classificações;
- período;
- território;
- filtros;
- data da consulta, quando relevante.
Essas informações podem ser fundamentais para reconstruir o resultado.
Você utilizou microdados?
Microdados exigem atenção adicional porque normalmente precisam ser processados antes de produzir resultados.
Documente, conforme a pesquisa:
- edição;
- arquivos;
- variáveis;
- filtros;
- pesos amostrais;
- tratamentos;
- software;
- procedimentos analíticos.
Você utilizou uma API?
Se os dados foram obtidos programaticamente, identifique:
- a fonte dos dados;
- a API utilizada;
- versão da API, quando pertinente;
- endpoint;
- parâmetros;
- data da extração;
- formato da resposta;
- eventuais limites ou paginação.
Nem todos esses elementos precisam aparecer na referência. Muitos pertencem à metodologia.
Você utilizou um arquivo baixado de outra plataforma?
Se um arquivo encontrado no Kaggle, GitHub ou outro ambiente reproduz dados originados em outra instituição, investigue a proveniência.
O caminho pode ser:
produtor original → dataset → transformação → plataforma de redistribuição → seu trabalho.
Citar apenas a última plataforma pode ocultar etapas importantes.
Erro comum
Confundir local de download com fonte dos dados. Antes de referenciar um arquivo encontrado em uma plataforma, verifique sua origem e se houve transformações realizadas por terceiros.
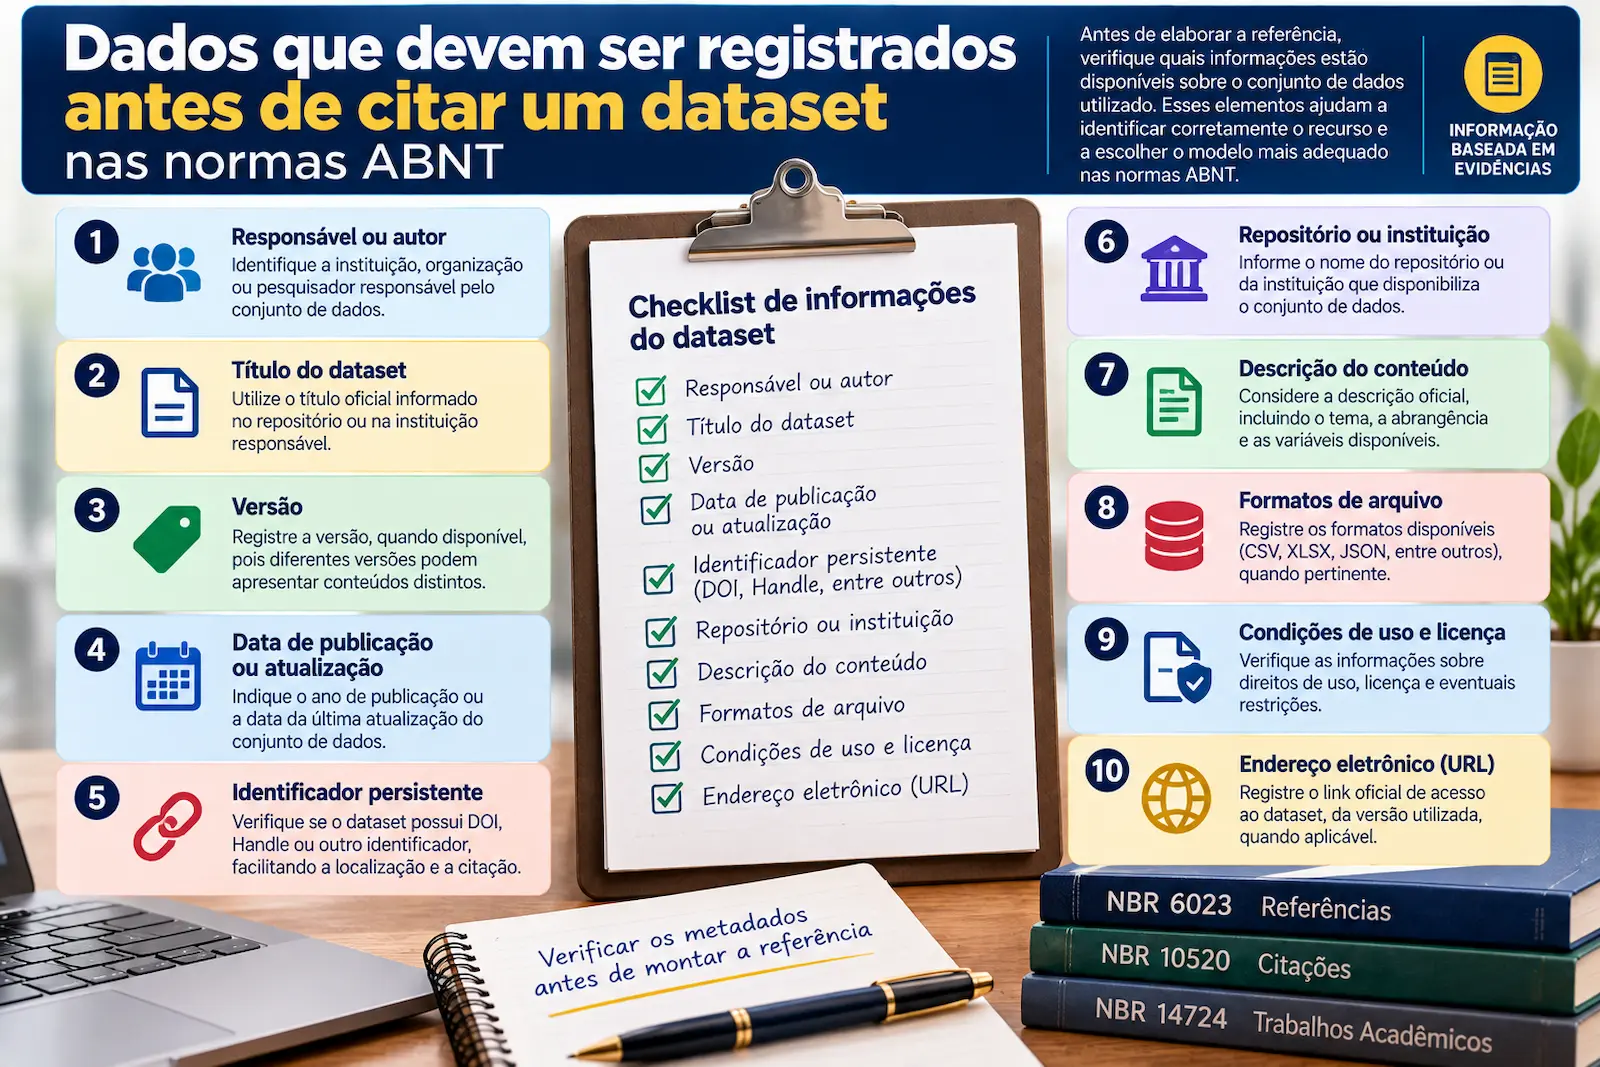
Quais dados devem ser registrados antes de citar um dataset?
Uma estratégia eficiente é criar uma pequena ficha para cada conjunto utilizado.
Isso evita que informações importantes sejam perdidas durante meses de pesquisa.
1. Responsável
Registre quem aparece como:
- autor;
- creator;
- instituição responsável;
- organização;
- publisher;
- contributor;
- mantenedor.
Esses papéis não são necessariamente equivalentes.
Não escolha automaticamente o nome mais conhecido da página.
2. Título
Registre o título oficial do recurso.
Não substitua automaticamente o título do dataset pelo:
- nome do arquivo;
- nome do projeto;
- nome do artigo;
- nome da página;
- nome do repositório.
3. Data
Verifique que tipo de data está sendo exibida.
Pode ser:
- criação;
- publicação;
- depósito;
- release;
- atualização;
- extração;
- acesso.
Não trate datas com funções diferentes como se fossem equivalentes.
4. Versão
Quando houver versionamento, registre a versão utilizada.
Essa informação pode ser essencial quando o conjunto sofre correções ou atualizações.
5. Identificador
Procure:
- DOI;
- Handle;
- ARK;
- identificador institucional;
- outro identificador persistente.
Abra o identificador e confirme qual objeto ele representa.
6. Repositório ou sistema
Registre o ambiente em que o objeto está disponibilizado quando pertinente.
Mas mantenha a distinção:
repositório não é automaticamente autor.
7. URL ou página persistente
Prefira, quando disponível, uma página estável que identifique o recurso.
Evite depender de URLs temporárias de download, sessão ou autenticação.
8. Data de obtenção dos dados
Registre quando os dados efetivamente utilizados foram obtidos, especialmente em bases dinâmicas.
Essa informação pode ser diferente da data em que você voltou à página para consultar a documentação.
9. Arquivos utilizados
Se o dataset contém muitos arquivos, registre quais participaram da análise.
Isso é especialmente útil quando diferentes arquivos representam:
- anos;
- regiões;
- módulos;
- tipos de registro;
- etapas do estudo.
10. Recorte
Registre:
- período;
- território;
- população;
- amostra;
- categorias;
- unidades de observação.
11. Variáveis
Identifique as variáveis que realmente entraram na análise.
Em datasets extensos, essa informação é muito mais útil do que simplesmente afirmar que “a base foi utilizada”.
12. Filtros e critérios
Documente critérios de:
- inclusão;
- exclusão;
- seleção;
- limpeza;
- tratamento de valores ausentes.
13. Transformações
Registre operações como:
- recodificação;
- normalização;
- padronização;
- agregação;
- deflação;
- conversão de unidades;
- criação de variáveis;
- junção de bases.
14. Software e scripts
Quando relevantes para a análise, registre:
- software;
- versão;
- pacotes;
- bibliotecas;
- scripts;
- parâmetros.
Se a ferramenta precisar ser tratada como objeto citável, consulte também Como Citar Software nas Normas ABNT.
15. Licença e restrições
Registre as condições de reutilização quando disponíveis.
Dados acessíveis publicamente podem continuar sujeitos a requisitos de atribuição ou outras condições.
16. Documentação associada
Salve ou identifique:
- README;
- codebook;
- dicionário de dados;
- manual;
- metodologia;
- notas técnicas;
- histórico de versões.
Esses documentos podem ser indispensáveis para interpretar corretamente os dados.
Visão do especialista
Os metadados bibliográficos respondem principalmente “qual é o objeto?”. Os dados metodológicos respondem “como esse objeto entrou na pesquisa?”. Registrar ambos desde o início reduz drasticamente o risco de inconsistências no TCC.
Metadados bibliográficos e dados metodológicos: qual é a diferença?
Essa distinção merece ser reforçada porque resolve uma grande quantidade de dúvidas.
| Metadados bibliográficos | Dados metodológicos |
|---|---|
| Responsável | Período analisado |
| Título | População ou território |
| Data | Variáveis selecionadas |
| Versão | Filtros |
| DOI ou identificador | Critérios de exclusão |
| Repositório | Tratamento de ausentes |
| Disponibilidade | Transformações |
| Informações de acesso pertinentes | Software e procedimentos analíticos |
Em termos simples:
A referência responde “qual conjunto de dados?”. A metodologia responde “como esses dados entraram na pesquisa?”.
Essa separação será especialmente importante nos próximos capítulos, quando passaremos da identificação do objeto para a construção da referência, a citação no texto, o uso de DOI e os diferentes tipos de repositório.
Em resumo
Antes de formatar qualquer referência de base de dados ou dataset, identifique o objeto efetivamente utilizado e registre seus metadados. Não confunda base, dataset, repositório, arquivo, tabela, API ou artigo. A precisão dessa primeira etapa determina a qualidade de todo o restante da documentação acadêmica.
Antes da referência: entenda a identidade bibliográfica dos dados
Uma das maiores dificuldades ao citar dados em trabalhos acadêmicos é que aquilo que o pesquisador chama informalmente de “base de dados” pode corresponder, na prática, a objetos bastante diferentes.
Imagine três pesquisas.
Na primeira, o estudante entra em um sistema estatístico, seleciona município, período e variável e exporta uma tabela.
Na segunda, baixa de um repositório científico um conjunto de arquivos publicado por pesquisadores, com título, autores, versão e DOI.
Na terceira, executa um script que consulta diariamente uma API e recebe registros atualizados em formato JSON.
Nos três casos existem dados digitais. Entretanto, a identidade do objeto utilizado, sua estabilidade, seus metadados e a maneira pela qual ele pode ser recuperado são diferentes.
É por isso que a referência não deve começar por uma fórmula pronta.
Visão do especialista
Antes de perguntar “como formatar?”, pergunte “o que exatamente estou tentando identificar?”. Em fontes de dados, essa pergunta costuma resolver problemas que nenhuma fórmula pronta consegue resolver sozinha.
Uma mesma pesquisa pode envolver vários objetos relacionados
Considere um dataset científico disponibilizado em um repositório.
Ao redor dele podem existir:
- uma página de apresentação;
- um registro bibliográfico;
- um DOI;
- várias versões;
- arquivos CSV;
- um dicionário de dados;
- um README;
- scripts;
- um artigo científico associado;
- uma licença;
- documentação metodológica.
Esses elementos fazem parte do mesmo ecossistema, mas não são necessariamente o mesmo objeto.
Se o pesquisador reutilizou os registros do dataset, o conjunto de dados é central.
Se utilizou uma definição encontrada no artigo associado, o artigo exerce outra função.
Se interpretou códigos com auxílio do dicionário de dados, essa documentação também participou do trabalho.
Se reproduziu o processamento com determinado software, existe ainda outro objeto potencialmente citável.
Portanto, uma pesquisa pode precisar reconhecer mais de uma fonte sem que isso represente duplicação indevida.
Objeto citável e ambiente de acesso não devem ser confundidos
Outro problema frequente ocorre quando o pesquisador identifica a fonte apenas pelo lugar onde a encontrou.
Por exemplo:
“Encontrei no Kaggle.”
Essa informação, isoladamente, não responde:
- quem produziu os dados;
- se o publicador do Kaggle é o produtor original;
- se o conjunto foi transformado;
- se existe fonte institucional anterior;
- qual versão foi utilizada.
O mesmo raciocínio vale para GitHub, Zenodo, SciELO Data, Dataverse e outros ambientes.
O local de hospedagem é uma informação importante, mas não substitui automaticamente a identidade intelectual ou institucional do objeto.
O arquivo baixado também pode não ser o objeto bibliográfico principal
Suponha que um dataset chamado hipoteticamente “Indicadores municipais de desenvolvimento” possua dez arquivos.
Você utiliza apenas:
municipios_2025.csv
Isso não significa necessariamente que a referência deva começar pelo nome desse arquivo.
O CSV pode ser apenas um componente de um dataset maior.
Nesse caso, uma solução coerente pode ser:
- identificar o dataset na referência;
- informar na metodologia qual arquivo foi utilizado;
- descrever as variáveis e o recorte selecionados.
Por outro lado, alguns repositórios atribuem identidade, metadados ou identificadores próprios a arquivos específicos.
Por isso, a granularidade precisa ser verificada no recurso real.
Atenção
Não existe uma regra segundo a qual “sempre se cita o dataset inteiro” ou “sempre se cita o arquivo”. A decisão depende da identidade do objeto e da função que ele exerceu na pesquisa.
Granularidade: qual nível dos dados deve ser identificado?
A ideia de granularidade é especialmente útil para entender referências de dados.
Ela responde a uma pergunta simples:
Em qual nível preciso identificar o recurso para que o leitor consiga compreender aquilo que realmente utilizei?
Uma estrutura de dados pode conter vários níveis:
instituição → sistema → pesquisa → dataset → versão → arquivo → variável → registro.
Nem todos precisam virar referências independentes.
Mas o pesquisador precisa compreender em qual nível está trabalhando.
Granularidade ampla
Em alguns casos, o objeto utilizado é uma base ou coleção ampla.
Isso pode ocorrer quando o estudo discute a própria base, sua metodologia, cobertura ou características gerais.
Granularidade intermediária
Em muitas pesquisas quantitativas, o objeto mais adequado pode ser uma pesquisa, dataset, edição ou versão específica.
Esse nível costuma oferecer informações suficientes para identificar o conjunto efetivamente utilizado.
Granularidade fina
Em outros casos, a reprodução depende de um componente muito específico:
- arquivo individual;
- release;
- commit;
- snapshot;
- tabela;
- consulta;
- resposta de API.
Nessas situações, a documentação metodológica precisa alcançar um nível mais fino.
Granularidade excessiva também pode prejudicar
Detalhamento não significa necessariamente qualidade.
Uma referência que tenta listar:
- todas as variáveis;
- todos os filtros;
- todos os parâmetros;
- todos os arquivos;
- todas as transformações,
pode se tornar ilegível e ainda misturar funções bibliográficas e metodológicas.
O objetivo é alcançar especificidade suficiente, e não acumular informações indiscriminadamente.
Boa prática
Use a referência para identificar o objeto e a metodologia para explicar o caminho percorrido dentro desse objeto. Essa divisão costuma produzir documentação mais clara do que tentar concentrar tudo em uma única referência.
Metadados bibliográficos e dados metodológicos: não misture as funções
Quando o pesquisador começa a documentar uma fonte de dados, é comum reunir dezenas de informações.
Nem todas pertencem à referência.
Uma distinção útil é separar metadados que identificam o objeto de informações que descrevem o uso realizado pelo pesquisador.
Informações que ajudam a identificar o objeto
Dependendo do recurso, podem incluir:
- autor ou criador;
- instituição responsável;
- título;
- data;
- versão;
- edição;
- repositório;
- DOI;
- Handle;
- outro identificador persistente;
- endereço estável.
Informações que explicam como o objeto foi utilizado
Podem incluir:
- data de extração;
- período analisado;
- território;
- população;
- variáveis selecionadas;
- filtros;
- critérios de inclusão;
- critérios de exclusão;
- tratamento de valores ausentes;
- remoção de duplicidades;
- transformações;
- junções;
- cálculos;
- software utilizado.
Essa separação não é absolutamente rígida.
Algumas informações podem aparecer em mais de uma camada dependendo do objeto e do padrão adotado.
A versão, por exemplo, pode integrar a própria identidade bibliográfica e também ser reiterada na metodologia por ser decisiva para a reprodução.
A data de extração pode adquirir importância especial em uma base dinâmica.
O ponto principal é compreender a função de cada informação.
Metadados bibliográficos ajudam a responder “qual objeto?”. Informações metodológicas ajudam a responder “o que foi feito com ele?”.
Quatro camadas que precisam permanecer coerentes
Uma pesquisa baseada em dados pode apresentar documentação em pelo menos quatro lugares diferentes:
- lista de referências;
- citações no texto;
- metodologia;
- fontes de tabelas e gráficos.
O problema surge quando essas camadas contam histórias diferentes.
Camada 1 — Referência
A referência identifica o objeto utilizado.
Ela ajuda o leitor a localizar ou reconhecer a fonte.
Camada 2 — Citação
A citação estabelece a atribuição no corpo do texto.
Ela indica de onde veio determinado dado, informação, definição ou afirmação.
Camada 3 — Metodologia
A metodologia descreve o percurso analítico.
Ela pode explicar:
- como os dados foram obtidos;
- quando foram extraídos;
- qual população foi selecionada;
- quais variáveis foram utilizadas;
- quais registros foram excluídos;
- quais transformações foram realizadas;
- como ocorreu a análise.
Camada 4 — Fonte de tabelas e gráficos
Essa indicação conecta os números apresentados visualmente às suas origens.
Quando o pesquisador transforma dados externos em uma tabela própria, uma formulação estrutural possível é:
Fonte: elaboração própria a partir de dados de [fonte].
Assim, fica claro que a organização visual é do autor do trabalho, mas os dados possuem origem externa.
Exemplo de incoerência entre as quatro camadas
Imagine a seguinte situação:
- a referência aponta para a versão 4 de um dataset;
- a metodologia informa que a extração ocorreu quando a versão 3 estava disponível;
- o arquivo realmente utilizado pertence à versão 2;
- a tabela indica apenas “Fonte: elaboração própria”.
Cada elemento pode parecer aceitável isoladamente, mas o conjunto apresenta uma quebra de rastreabilidade.
O leitor já não consegue saber qual versão produziu os resultados.
Erro comum
Revisar somente a formatação da referência e não conferir se ela corresponde ao dataset, versão e arquivos efetivamente utilizados.
Rastreabilidade e reprodutibilidade não são exatamente a mesma coisa
Esses conceitos aparecem frequentemente juntos, mas é útil distingui-los.
Rastreabilidade
Em termos práticos, significa conseguir acompanhar o percurso dos dados.
Por exemplo:
IBGE → pesquisa → microdados → arquivo → variáveis selecionadas → limpeza → base analítica → tabela do TCC.
O leitor consegue entender de onde o resultado veio.
Reprodutibilidade
Vai além da identificação da origem e envolve a possibilidade de repetir procedimentos suficientes para chegar aos mesmos resultados ou verificar o processo, conforme a natureza da pesquisa.
Isso pode depender de:
- dados acessíveis;
- versão correta;
- scripts;
- parâmetros;
- software;
- ambiente computacional;
- decisões metodológicas.
Nem toda pesquisa permite reprodução integral.
Dados sensíveis, restrições contratuais, confidencialidade e limitações técnicas podem impedir o compartilhamento dos registros.
Ainda assim, a documentação pode preservar rastreabilidade dentro dos limites permitidos.
Atenção
Não apresente reprodutibilidade completa como exigência universal da ABNT. Ela pertence a uma discussão metodológica e científica mais ampla e pode ser incentivada por periódicos, repositórios, financiadores ou instituições.
Por que bases dinâmicas exigem cuidado adicional?
Uma fonte estática e uma fonte continuamente atualizada apresentam problemas documentais diferentes.
Se um dataset publicado em repositório permanece imutável e possui DOI específico, o objeto pode ser relativamente fácil de situar.
Já uma base atualizada diariamente pode apresentar valores diferentes quando consultada novamente.
Nesse cenário, registrar apenas o endereço da página pode não ser suficiente para reconstruir aquilo que foi analisado.
Elementos que podem ajudar a situar uma base dinâmica
Dependendo do sistema:
- data de extração;
- horário, quando materialmente relevante;
- período consultado;
- parâmetros;
- versão da API;
- release;
- snapshot;
- arquivo exportado;
- código da consulta.
Essas informações não precisam ser empilhadas mecanicamente dentro da referência.
Elas podem ser distribuídas entre referência, metodologia, scripts e documentação complementar.
O arquivo preservado pode funcionar como evidência do estado analisado
Quando permitido, guardar a extração original utilizada na pesquisa pode ser uma prática valiosa.
Por exemplo:
extracao_api_2026-09-15.json
Esse arquivo não substitui a referência da fonte.
Ele preserva o estado dos registros recebidos naquele momento.
A proveniência não termina quando os dados são baixados
Outro ponto frequentemente perdido durante a escrita acadêmica é que a origem dos dados continua relevante depois do download.
Considere este fluxo:
Fonte A + Fonte B → padronização → junção → exclusões → cálculo de indicador → base analítica.
A base analítica pode ter sido criada integralmente pelo pesquisador.
Entretanto, os registros que a compõem continuam tendo origem nas fontes A e B.
É inadequado transformar essa situação simplesmente em:
Fonte: elaboração própria.
sem qualquer reconhecimento da proveniência externa.
“Elaboração própria” descreve a elaboração, não necessariamente a origem
Essa distinção é especialmente importante em:
- tabelas;
- gráficos;
- mapas;
- indicadores calculados;
- bases combinadas;
- modelos estatísticos;
- datasets derivados.
O pesquisador pode ter produzido o resultado visual ou analítico, mas os dados subjacentes continuam tendo uma história.
Dataset derivado não apaga dataset original
Imagine que um pesquisador:
- baixe microdados de uma fonte pública;
- selecione determinada população;
- exclua registros incompletos;
- crie três variáveis;
- agregue os registros por município;
- publique o resultado como novo dataset.
Esse novo conjunto pode adquirir identidade própria.
Mesmo assim, sua documentação deve preservar a ligação com a fonte original.
Esse encadeamento ajuda o leitor a distinguir:
- dados observados originalmente;
- decisões tomadas pelo pesquisador;
- variáveis derivadas;
- produto final.
Teste de identificação: você já sabe o que precisa citar?
Antes de avançar para a montagem da referência, responda às perguntas abaixo.
1. Qual é o objeto?
Consigo dizer claramente se utilizei uma base, dataset, tabela, microdados, arquivo, API ou outro recurso?
2. Quem responde pelo objeto?
Identifiquei os criadores ou a instituição responsável sem confundi-los com a plataforma?
3. O objeto possui título próprio?
Estou utilizando o título oficial ou apenas o nome do arquivo salvo?
4. Existe versão ou estado identificável?
Consigo determinar qual estado dos dados participou da análise?
5. Existe identificador?
Verifiquei DOI, Handle, código institucional ou outro identificador disponível?
6. Onde o objeto está disponibilizado?
Sei diferenciar fonte, repositório e ambiente de acesso?
7. Utilizei o objeto inteiro?
Ou selecionei apenas arquivos, variáveis, períodos, regiões ou registros?
8. Transformei os dados?
Consigo listar as transformações que afetam os resultados?
9. Combinei diferentes fontes?
A proveniência de cada uma continua preservada?
10. Outra pessoa conseguiria compreender o percurso?
Se a resposta for não, ainda existe uma lacuna documental.
Em resumo
Antes de montar a referência de uma base de dados ou dataset, identifique sua identidade, granularidade, responsabilidade, versão, identificadores e proveniência. Em seguida, separe aquilo que identifica bibliograficamente o objeto daquilo que explica seu uso metodológico. Essa etapa evita referências aparentemente completas, mas desconectadas dos dados que realmente produziram os resultados da pesquisa.
Como montar a referência de um dataset nas normas ABNT?
Depois de identificar corretamente o objeto utilizado e registrar seus metadados, é possível começar a construir a referência.
Essa ordem é importante.
Quando o estudante começa procurando um modelo pronto e tenta encaixar qualquer recurso dentro dele, aumenta o risco de:
- atribuir autoria à plataforma errada;
- confundir dataset com artigo;
- usar o título do arquivo como título do conjunto;
- informar uma versão que não foi utilizada;
- copiar o DOI de outro objeto;
- transformar detalhes metodológicos em elementos bibliográficos.
Por isso, o processo mais seguro é:
identificar o objeto → recuperar os metadados → compreender a função de cada elemento → montar a referência.
Existe um único modelo ABNT para qualquer dataset?
Não é adequado tratar todos os conjuntos de dados como se possuíssem exatamente a mesma estrutura.
Compare estes cenários:
- um dataset publicado no Zenodo com autores, versão e DOI;
- uma tabela extraída do SIDRA;
- microdados de uma pesquisa do IBGE;
- uma consulta realizada no DATASUS;
- uma série histórica do Banco Mundial;
- um arquivo encontrado em repositório institucional;
- uma base obtida por API;
- dados coletados pelo próprio pesquisador.
Todos envolvem dados, mas não necessariamente possuem os mesmos elementos bibliográficos.
Atenção
O objetivo não é obrigar qualquer fonte de dados a caber em uma fórmula rígida. A referência deve representar adequadamente o objeto efetivamente utilizado, com base nos elementos disponíveis e nas normas e orientações aplicáveis ao trabalho.
Estrutura didática de uma referência de dataset
Quando o dataset funciona como um objeto formalmente publicado, uma estrutura didática pode ser representada assim:
RESPONSÁVEL. Título do dataset. Versão, quando pertinente. Repositório ou instituição, data. Identificador persistente e/ou informações de disponibilidade e acesso, conforme o recurso.
Considere o modelo como uma ferramenta para compreender os componentes da referência, e não como uma frase que deve ser copiada literalmente para qualquer conjunto.
Quais elementos podem aparecer?
| Elemento | O que verificar |
|---|---|
| Responsável | Autor pessoal, autores ou instituição responsável |
| Título | Título oficial do dataset ou recurso |
| Versão | Versão efetivamente utilizada, quando existente e pertinente |
| Data | Data associada à publicação ou ao recurso |
| Repositório/instituição | Ambiente responsável pela disponibilização |
| Identificador | DOI, Handle ou outro identificador persistente |
| Disponibilidade | Endereço eletrônico ou página persistente, conforme necessário |
| Acesso | Informação pertinente ao recurso eletrônico e ao padrão adotado |
Quem deve aparecer como autor de um dataset?
A autoria é uma das partes que mais geram erros.
Em muitos repositórios, a página apresenta vários nomes e instituições com funções diferentes.
Podem existir campos como:
- creator;
- author;
- contributor;
- publisher;
- maintainer;
- funder;
- hosting institution.
Esses papéis não devem ser tratados automaticamente como equivalentes.
Dataset com autor pessoal
Quando pesquisadores aparecem claramente como criadores ou responsáveis pelo conjunto, esses nomes orientam a identificação da autoria.
Exemplo estrutural:
SOBRENOME, Nome. Título do dataset. Versão. Repositório, data. DOI: [identificador].
Com vários responsáveis, a forma de representação deve seguir o padrão bibliográfico adotado para a referência.
Dataset com autoria institucional
Alguns conjuntos são produzidos e publicados sob responsabilidade de uma organização.
Exemplo estrutural:
INSTITUIÇÃO RESPONSÁVEL. Título do conjunto de dados. [demais elementos pertinentes].
Isso é comum em:
- institutos de estatística;
- órgãos governamentais;
- organizações internacionais;
- universidades;
- institutos de pesquisa;
- projetos institucionais.
O repositório deve ser tratado como autor?
Não automaticamente.
O fato de um conjunto estar depositado no Zenodo, SciELO Data, Figshare, Dryad ou outro repositório não significa que o repositório produziu os dados.
Da mesma forma, um arquivo no GitHub não transforma o GitHub em autor.
O procedimento correto é verificar os metadados do objeto.
Erro comum
Encontrar um dataset no Zenodo e iniciar a referência com “ZENODO” sem verificar os criadores do registro. O Zenodo pode ser o ambiente de depósito, enquanto a responsabilidade pelo conjunto pertence a pesquisadores ou instituições específicas.
E se a autoria não estiver clara?
Não invente um autor.
Antes de concluir que o conjunto não possui responsabilidade identificável, consulte:
- metadados completos;
- README;
- documentação;
- página do projeto;
- registro do DOI;
- arquivo de citação;
- instituição responsável.
Em ambientes computacionais, arquivos como CITATION.cff também podem fornecer informações úteis sobre como os responsáveis desejam que o recurso seja identificado.
Qual título deve ser usado na referência?
Use o título oficial do objeto que está sendo citado.
Essa orientação parece simples, mas é importante porque uma mesma página pode apresentar simultaneamente:
- nome do projeto;
- título do artigo;
- título do dataset;
- nome do repositório;
- nome de arquivos;
- descrição do recurso.
O título escolhido deve corresponder ao objeto efetivamente utilizado.
Nome do arquivo é o título do dataset?
Não necessariamente.
Um conjunto denominado:
Indicadores socioeconômicos municipais
pode conter arquivos como:
dados.csv;municipios.xlsx;variaveis.csv;README.md.
Esses nomes ajudam a identificar os componentes, mas não substituem automaticamente o título do dataset.
E se apenas um arquivo foi utilizado?
Você pode identificar o conjunto na referência e registrar o arquivo efetivamente utilizado na metodologia.
Quando um arquivo possui identidade própria, metadados independentes ou identificador persistente específico, pode ser necessário avaliar uma granularidade bibliográfica mais detalhada.
Qual data deve ser usada na referência do dataset?
Um recurso digital pode apresentar diversas datas.
Entre elas:
- data de criação;
- data de publicação;
- data de depósito;
- data de release;
- data de atualização;
- data da versão;
- data de acesso;
- data de extração.
Essas informações não possuem necessariamente a mesma função.
Data de publicação
Indica quando o recurso ou versão foi formalmente disponibilizado, conforme os metadados da fonte.
Data de atualização
Pode indicar que o registro ou conjunto sofreu alterações.
É importante verificar se a atualização corresponde a:
- mudança apenas nos metadados;
- correção de documentação;
- adição de arquivos;
- alteração dos dados;
- nova versão.
Data de acesso
Indica quando determinado recurso eletrônico foi consultado, conforme a necessidade e o padrão adotado para a referência.
Data de extração
Indica quando os dados que efetivamente participaram da análise foram obtidos.
Essa informação é particularmente importante em bases dinâmicas.
Na prática
Você pode consultar a documentação de uma base em maio, extrair os dados em junho e voltar ao portal em agosto para conferir uma definição. A data de extração dos dados analisados continua sendo junho. Não trate automaticamente todas essas datas como se fossem a mesma coisa.
Como informar a versão do dataset?
Quando o conjunto possui versionamento explícito, registre a versão efetivamente utilizada quando essa informação for pertinente à identificação do objeto.
Exemplos de formas que podem aparecer nos metadados:
- v1;
- v1.2;
- Version 2;
- Release 2026-01;
- 2026 edition;
- revision 3.
Não converta arbitrariamente uma designação em outra.
Se a fonte informa “Release 3”, não transforme automaticamente em “versão 3.0”.
Por que a versão importa?
Porque versões diferentes podem conter:
- novos registros;
- correções;
- mudanças em variáveis;
- alterações na codificação;
- arquivos adicionais;
- exclusões;
- documentação revisada.
Se o resultado do TCC foi produzido com uma versão específica, a documentação deve evitar criar a impressão de que outra versão foi utilizada.
DOI, Handle e outros identificadores: qual utilizar?
Identificadores persistentes ajudam a localizar um objeto mesmo quando páginas e estruturas de sites mudam.
O DOI é um dos exemplos mais conhecidos, mas não é o único.
Um dataset pode utilizar:
- DOI;
- Handle;
- ARK;
- identificador do repositório;
- identificador institucional;
- URL persistente.
O DOI é sempre obrigatório?
Não.
Nem todo conjunto possui DOI.
Além disso, a existência de DOI não elimina a necessidade de identificar corretamente:
- responsáveis;
- título;
- data;
- versão;
- natureza do recurso.
O DOI melhora a identificação persistente, mas não substitui os demais metadados.
Um DOI torna o dataset confiável?
Não automaticamente.
O DOI ajuda a identificar e localizar persistentemente o objeto.
A qualidade dos dados precisa ser avaliada por outros critérios, como:
- procedência;
- método de coleta;
- documentação;
- consistência;
- adequação à pergunta de pesquisa;
- limitações;
- controle de qualidade.
Atenção
Persistência não é sinônimo de qualidade. Um identificador persistente ajuda a localizar o objeto; ele não certifica automaticamente que os dados são metodologicamente adequados ao seu TCC.
Devo colocar URL na referência do dataset?
A resposta depende do objeto, do identificador disponível, da forma de disponibilização e do padrão aplicado à referência.
Em recursos digitais, pode existir:
- landing page do dataset;
- DOI;
- Handle;
- URL do repositório;
- URL direta do arquivo;
- URL temporária de download.
Esses endereços não possuem a mesma estabilidade.
Prefira páginas que identifiquem o objeto
Quando possível, uma landing page persistente é geralmente mais informativa do que um link direto para um arquivo.
A página do objeto pode fornecer:
- autoria;
- título;
- versão;
- data;
- DOI;
- licença;
- documentação;
- arquivos disponíveis.
Evite URLs temporárias
Links gerados por:
- sessão;
- token;
- autenticação;
- download temporário;
- redirecionamento transitório
podem deixar de funcionar rapidamente.
Quando houver uma página estável do recurso, ela tende a ser mais adequada para sua identificação.
Como citar base de dados ou dataset no texto?
Depois de montar a referência, o estudante também precisa estabelecer a relação entre a fonte e as informações utilizadas no corpo do trabalho.
A citação pode aparecer de maneira narrativa ou parentética, de acordo com o sistema adotado.
Exemplo de citação narrativa com autoria institucional
Segundo o Instituto Brasileiro de Geografia e Estatística (IBGE, [ano]), […].
Exemplo de citação parentética
[…] conforme os dados utilizados na análise (IBGE, [ano]).
Exemplo com autor pessoal
De acordo com Sobrenome ([ano]), o conjunto de dados […].
ou:
[…] conforme o conjunto utilizado na análise (SOBRENOME, [ano]).
Os exemplos são estruturais. A autoria e a data precisam corresponder aos metadados do recurso real.
Preciso citar o dataset toda vez que mencionar um número?
Não existe uma resposta mecânica que substitua a análise do texto.
A citação deve permitir ao leitor compreender de onde vêm as informações utilizadas.
Se um parágrafo inteiro apresenta resultados obtidos da mesma fonte, a distribuição das citações deve manter a atribuição clara sem produzir repetição desnecessária.
Quando a fonte muda, a atribuição precisa continuar inequívoca.
Dados analisados pelo próprio pesquisador exigem cuidado na redação
Imagine que o estudante baixou microdados e calculou uma taxa que não aparece pronta na fonte.
Nesse caso, não é adequado escrever de maneira que pareça que a instituição publicou exatamente aquele resultado.
Uma redação metodologicamente mais clara pode indicar que:
A partir dos dados de [fonte], a análise realizada neste estudo identificou […].
Assim, ficam separados:
- a origem dos dados;
- o processamento realizado pelo pesquisador;
- o resultado produzido pela análise.
Visão do especialista
Quando você produz um resultado novo a partir de dados de terceiros, não atribua automaticamente a conclusão ao produtor do dataset. A fonte forneceu os dados; a análise do TCC produziu o resultado.
Como citar dataset com DOI?
Quando um dataset possui DOI próprio, esse identificador facilita a identificação persistente do objeto.
Antes de utilizá-lo, porém, confirme que o DOI corresponde realmente ao conjunto citado.
Passo 1 — Abra o DOI
Verifique para onde ele direciona.
Confirme:
- título;
- autoria;
- tipo de objeto;
- versão;
- repositório;
- data.
Passo 2 — Verifique se o DOI pertence ao dataset ou ao artigo
É comum que uma página de projeto apresente simultaneamente:
- DOI do artigo;
- DOI do dataset;
- DOI de uma versão;
- DOI de outro produto relacionado.
Não use um identificador apenas porque ele aparece próximo aos dados.
Passo 3 — Verifique se existem diferentes versões
Quando o repositório utiliza versionamento, pode haver um identificador associado à versão específica utilizada e outro associado ao conjunto de versões.
Essa diferença pode ser importante para reprodutibilidade.
Modelo estrutural de dataset com DOI
AUTOR/INSTITUIÇÃO. Título do dataset. Versão. Repositório, ano. DOI: [DOI].
Adapte o modelo aos metadados efetivamente apresentados pelo recurso e às orientações bibliográficas aplicáveis.
Dataset com vários autores
Quando vários pesquisadores aparecem como criadores, não elimine nomes arbitrariamente para simplificar a referência.
Observe as regras aplicáveis à representação de responsabilidade no padrão adotado pela instituição.
Dataset com autoria institucional e DOI
Uma instituição também pode ser responsável por um conjunto com identificador persistente.
Estruturalmente:
INSTITUIÇÃO. Título do conjunto de dados. Versão, quando pertinente. Repositório, data. DOI: [DOI].
Dataset com DOI e URL
Evite pensar que DOI e URL são apenas elementos redundantes.
O DOI funciona como identificador persistente. A página associada pode apresentar os metadados e arquivos.
A forma de representar esses elementos deve seguir a estrutura bibliográfica utilizada no trabalho.
Boa prática
Ao registrar um DOI, salve também o título, a versão e os responsáveis naquele momento. O identificador ajuda a reencontrar o objeto, mas sua ficha de pesquisa deve preservar o contexto exato em que ele foi utilizado.
Dataset com várias versões: qual DOI deve ser usado?
O versionamento é particularmente importante em repositórios que preservam diferentes estados de um mesmo objeto.
Dependendo da infraestrutura, pode existir:
- um identificador para determinada versão;
- um identificador que representa o conjunto das versões;
- uma página que apresenta o histórico completo.
Para decidir qual identificação é mais apropriada, volte à pergunta central:
Qual objeto produziu os resultados do meu trabalho?
Quando a versão específica é importante?
Ela tende a ser especialmente importante quando:
- os dados mudam entre versões;
- registros são corrigidos;
- novas observações são acrescentadas;
- variáveis são modificadas;
- a análise precisa ser reproduzida exatamente.
E quando quero apontar para o conjunto como um todo?
Em outros contextos, o interesse pode estar no recurso em sentido mais amplo, independentemente de uma versão específica.
É justamente por isso que alguns sistemas diferenciam identificadores de versão e identificadores conceituais.
O que não fazer
Evite:
- usar o DOI mais recente sem verificar qual versão foi analisada;
- trocar o DOI depois da análise apenas porque apareceu uma atualização;
- misturar metadados de versões diferentes;
- atribuir à versão utilizada arquivos que só surgiram posteriormente.
Atenção
Atualizar uma referência não atualiza automaticamente a pesquisa. Se uma nova versão alterou os dados, pode ser necessário reavaliar cálculos, tabelas, gráficos e conclusões.
Como citar dataset sem DOI?
A ausência de DOI não impede a identificação ou o uso de um conjunto de dados.
Muitas bases governamentais, institucionais e históricas não possuem DOI para cada recurso.
Nesses casos, procure outros elementos de identificação.
O que utilizar quando não existe DOI?
Dependendo do recurso:
- Handle;
- ARK;
- identificador institucional;
- código da tabela;
- código do indicador;
- identificador do sistema;
- landing page;
- URL oficial persistente.
Modelo estrutural sem DOI
RESPONSÁVEL. Título do conjunto de dados. Versão, quando pertinente. Instituição ou repositório, data. Disponível em: [endereço pertinente]. Acesso em: [data], quando aplicável.
Novamente, o modelo deve ser adaptado à natureza do recurso.
Não invente identificadores
Se o dataset não possui DOI, não tente construir um a partir do nome do repositório ou copiar o DOI de um artigo relacionado.
É melhor uma referência baseada nos elementos realmente existentes do que uma referência aparentemente sofisticada, mas bibliograficamente falsa.
Como adaptar uma referência ao objeto real?
Considere três situações hipotéticas.
Situação 1 — Dataset formalmente publicado
O registro apresenta:
- dois criadores;
- título;
- versão 2.1;
- data;
- repositório;
- DOI.
Nesse caso, esses metadados formam a base da referência.
Situação 2 — Tabela institucional
O pesquisador utiliza uma tabela numerada disponibilizada por um órgão público.
Agora os elementos relevantes podem incluir:
- instituição;
- pesquisa ou sistema;
- número e título da tabela;
- período;
- página de acesso.
Filtros detalhados podem ser documentados na metodologia.
Situação 3 — Arquivo encontrado em plataforma de terceiros
O estudante encontra um CSV no Kaggle, mas a descrição informa que os dados foram originalmente obtidos de uma organização internacional e posteriormente tratados pelo usuário que publicou o arquivo.
Nesse caso, existem pelo menos três camadas:
fonte original → transformação realizada pelo publicador → arquivo efetivamente utilizado.
O pesquisador precisa decidir quais dessas camadas são materialmente relevantes para documentar sua análise.
Visão do especialista
Uma referência não é um molde no qual os dados precisam caber. É a representação bibliográfica de um objeto real. Quanto melhor você identifica o objeto, mais natural se torna a construção da referência.
Referência, citação e metodologia: como manter tudo coerente?
Depois de construir a referência, faça uma verificação em três níveis.
1. Referência
Pergunte:
O leitor consegue identificar qual conjunto utilizei?
2. Citação
Pergunte:
Está claro quais informações ou dados vêm dessa fonte?
3. Metodologia
Pergunte:
Está claro como transformei a fonte original na base efetivamente analisada?
Quando essas três respostas são positivas, a documentação se torna muito mais consistente.
Quando uma delas falha, surgem problemas típicos:
| Falha | Consequência |
|---|---|
| Referência vaga | Não é possível localizar o conjunto |
| Citação vaga | Não está claro de onde vêm os dados |
| Metodologia vaga | Não é possível compreender como os resultados foram produzidos |
| Versão inconsistente | A referência pode apontar para dados diferentes dos analisados |
| Autoria incorreta | O crédito e a proveniência ficam distorcidos |
Em resumo
Para montar uma referência de dataset, comece pelos metadados reais do objeto. Identifique corretamente autoria ou responsabilidade, título, data, versão, repositório e identificadores disponíveis. Não transforme plataforma em autor, não confunda DOI do artigo com DOI do dataset e não substitua a versão analisada pela versão mais recente. Depois, mantenha referência, citação e metodologia coerentes entre si.
Como ler os metadados antes de montar a referência do dataset
Uma referência de dataset fica muito mais fácil de construir quando o pesquisador deixa de olhar apenas para a página visual do recurso e passa a examinar seus metadados.
Repositórios e sistemas podem apresentar informações como:
- creator;
- author;
- contributor;
- publisher;
- repository;
- maintainer;
- funder;
- title;
- version;
- publication date;
- updated date;
- DOI;
- identifier;
- license;
- related identifiers.
O problema é que esses campos não exercem necessariamente a mesma função.
Copiar todos eles para uma referência sem compreender seu significado pode produzir uma estrutura aparentemente completa, mas conceitualmente inadequada.
Creator, contributor, publisher e repository não são sinônimos
Em um dataset científico, o campo creator pode identificar quem recebeu crédito principal pela criação do conjunto.
Um contributor pode ter participado do projeto sem exercer a mesma função de autoria ou criação.
O campo publisher pode indicar a entidade responsável pela publicação ou disponibilização formal do objeto.
O repository pode representar apenas a infraestrutura que preserva e disponibiliza os arquivos.
Por isso, não é seguro transportar automaticamente qualquer campo para a posição de autoria.
Boa prática
Quando o repositório oferece uma citação recomendada, utilize-a como importante ponto de partida, mas confira se ela corresponde ao objeto, versão e metadados que você realmente utilizou e adapte a apresentação às regras bibliográficas adotadas no trabalho.
Não escolha a autoria apenas pelo nome mais conhecido da página
É comum que o nome visualmente mais destacado seja o da plataforma.
Isso pode levar a referências como:
KAGGLE. [Título do conjunto]…
ou:
ZENODO. [Título do conjunto]…
sem que Kaggle ou Zenodo sejam os criadores dos dados.
Antes de fazer isso, verifique os campos de responsabilidade.
Autoria e responsabilidade: como resolver os casos menos óbvios
Nem todo dataset apresenta uma autoria simples.
Há conjuntos criados por:
- um pesquisador;
- vários pesquisadores;
- um laboratório;
- uma universidade;
- um órgão governamental;
- um consórcio;
- uma organização internacional;
- um projeto colaborativo.
O objetivo não é forçar todos esses casos para um único modelo de autoria, mas identificar a responsabilidade documentada.
Dataset com autoria pessoal
Quando o registro apresenta claramente pesquisadores como criadores, a referência pode utilizar essa responsabilidade pessoal conforme o padrão adotado.
Antes de transcrever os nomes, confira:
- ordem apresentada;
- grafia;
- sobrenomes compostos;
- identificadores de pesquisador, quando relevantes para conferência;
- se todos os nomes pertencem realmente ao campo de criação.
Dataset com autoria institucional
Dados governamentais e institucionais frequentemente possuem responsabilidade corporativa.
Nesse caso, não há necessidade de procurar artificialmente uma pessoa para ocupar a posição de autor.
Exemplos de entidades que podem exercer responsabilidade institucional, dependendo do objeto, incluem:
- institutos nacionais de estatística;
- ministérios;
- secretarias;
- universidades;
- centros de pesquisa;
- organizações internacionais.
A questão principal é verificar quem responde pelo recurso específico.
Órgão maior e unidade subordinada
Algumas fontes apresentam uma estrutura institucional hierárquica.
Por exemplo:
órgão principal → departamento → sistema → dataset.
Nem sempre será necessário reproduzir toda a cadeia institucional dentro da referência.
Entretanto, conhecer essa hierarquia ajuda a evitar atribuições imprecisas.
Consórcios e projetos colaborativos
Grandes projetos científicos podem utilizar nomes coletivos como responsáveis pelos dados.
Não substitua essa responsabilidade coletiva por um pesquisador individual apenas porque seu nome aparece em um artigo associado.
O artigo e o dataset podem apresentar estruturas de crédito diferentes.
Mantenedor não é automaticamente autor
Um mantenedor pode atualizar arquivos, administrar o repositório ou cuidar da infraestrutura técnica sem ter produzido os dados originais.
Essa função pode ser importante para a documentação, mas não deve ser convertida automaticamente em autoria.
Financiador também não é automaticamente autor
O fato de uma agência ter financiado a produção do dataset não significa, por si só, que ela seja sua autora.
Crédito financeiro, autoria, publicação e hospedagem são dimensões diferentes.
Como identificar o título correto de uma base de dados ou dataset
O título deve representar o objeto que está sendo referenciado.
Em repositórios científicos, normalmente existe um título explícito no registro.
Em sistemas estatísticos, porém, a situação pode ser mais complexa.
Você pode encontrar:
- nome do sistema;
- nome da pesquisa;
- nome da tabela;
- nome da série;
- nome do arquivo;
- nome do indicador.
Esses nomes não são intercambiáveis.
Nome do arquivo não deve substituir automaticamente o título
Considere:
base_final_corrigida_03.csv
Esse nome pode ter sido atribuído localmente pelo pesquisador após o download.
Utilizá-lo como título da fonte poderia fazer parecer que existe um objeto publicado com esse nome.
O mais seguro é retornar à página oficial ou aos metadados e identificar o título do recurso de origem.
Não “melhore” o título por conta própria
Também é inadequado reescrever livremente um título apenas para torná-lo mais elegante.
A função bibliográfica é identificar o recurso, e não criar uma nova denominação editorial para ele.
Datas em datasets: publicação, atualização, acesso e extração
Datas são uma das áreas que mais geram confusão porque diferentes sistemas exibem diferentes eventos temporais.
Uma página pode mostrar:
- data de criação;
- data de publicação;
- data de depósito;
- data de atualização;
- data da versão;
- data de modificação;
- data de acesso;
- data de extração.
Essas datas não devem ser tratadas como equivalentes.
Data de publicação
Indica, de modo geral, quando o objeto foi publicado ou disponibilizado como recurso identificado.
Data da versão
Pode indicar quando determinada versão foi liberada.
Em um recurso versionado, ela pode ser mais útil para situar o objeto efetivamente utilizado.
Data de atualização
Indica uma modificação posterior, mas é necessário descobrir o que foi alterado.
Uma atualização pode representar:
- correção dos dados;
- novo arquivo;
- mudança apenas na descrição;
- alteração de metadados;
- nova versão.
Data de acesso
Indica quando o pesquisador consultou determinado recurso.
Ela pode ser importante para fontes online, especialmente quando o conteúdo pode mudar.
Data de extração
Indica quando os registros utilizados foram efetivamente obtidos.
Considere:
O pesquisador acessou a documentação em 20 de setembro, mas os dados analisados foram extraídos em 3 de agosto.
As duas datas descrevem eventos diferentes.
Na prática
Em bases dinâmicas, registre a data de extração durante a coleta. Tentar reconstruí-la meses depois apenas pela data de modificação de arquivos locais pode gerar incerteza desnecessária.
Versionamento: como saber qual versão realmente deve ser documentada
A versão é relevante quando diferentes estados de um conjunto precisam ser distinguidos.
Isso pode ocorrer porque o produtor:
- corrigiu erros;
- incluiu novos registros;
- removeu observações;
- alterou variáveis;
- reprocessou informações;
- modificou a metodologia.
Se essas mudanças podem alterar os resultados, a identificação da versão ganha importância metodológica.
Versão formal
Alguns datasets apresentam valores claros como:
Version 1.0
ou:
Version 2.3
Nesse caso, registre a designação exatamente como documentada, adaptando apenas sua apresentação ao padrão utilizado.
Release
Em projetos técnicos, a versão pode aparecer como release.
Ela pode identificar um estado específico do conjunto e dos arquivos associados.
Commit
Em um repositório Git, um commit pode situar com grande precisão o estado dos arquivos.
Isso não significa que todo trabalho que utiliza GitHub precise transformar o hash completo do commit em elemento obrigatório da referência.
Ele pode ser documentado metodologicamente quando necessário para identificar o estado analisado.
Base sem versionamento explícito
Se a fonte não informa versão, escreva a documentação com aquilo que realmente existe.
Você pode preservar outros elementos, conforme o caso:
- data de extração;
- período;
- nome do arquivo;
- release;
- snapshot;
- data de atualização;
- identificador da consulta.
Erro comum
Transformar o ano da consulta, o nome local do arquivo ou qualquer número encontrado na página em uma suposta “versão” que o produtor nunca declarou.
DOI, Handle e outros identificadores: para que servem?
Um identificador persistente ajuda a reconhecer e recuperar um objeto mesmo quando sua localização técnica muda.
Entre os identificadores que podem aparecer em fontes de dados estão:
- DOI;
- Handle;
- ARK;
- identificadores institucionais;
- identificadores próprios de repositórios.
DOI
O DOI é amplamente utilizado em publicações científicas e datasets.
Quando existe, verifique:
- qual objeto ele resolve;
- se pertence ao dataset ou ao artigo;
- se identifica uma versão específica;
- se existe outro DOI relacionado ao conjunto de versões.
Handle
Alguns repositórios institucionais utilizam Handle como endereço persistente do registro.
Ele pode ser mais apropriado do que copiar uma URL interna longa e instável.
Identificador institucional
Bases estatísticas podem utilizar códigos próprios.
Uma tabela do SIDRA, por exemplo, pode possuir número que ajuda a identificar precisamente o recurso.
Um indicador internacional pode possuir código próprio.
Esses elementos podem ser importantes mesmo sem DOI.
Identificador persistente não significa qualidade científica automática
Um identificador ajuda a localizar e distinguir o objeto.
Ele não responde sozinho:
- se os dados foram coletados adequadamente;
- se são apropriados para sua pergunta de pesquisa;
- se existem vieses;
- se a documentação é suficiente;
- se as variáveis foram interpretadas corretamente.
A avaliação da fonte continua necessária.
Como verificar se o DOI pertence ao objeto correto
Antes de copiar um DOI, abra ou examine o registro para o qual ele aponta.
Verifique:
- título;
- responsáveis;
- tipo de recurso;
- versão;
- repositório;
- arquivos.
Erro clássico: DOI do artigo no lugar do dataset
Imagine que uma página apresente:
- um artigo científico;
- um dataset associado;
- um DOI para cada objeto.
Se você reutilizou o dataset, copiar apenas o DOI do artigo identifica outra entidade.
Os dois objetos estão relacionados, mas não são bibliograficamente idênticos.
Outro erro: DOI de uma versão diferente
Em sistemas com versionamento, o DOI encontrado na página atual pode não representar o estado analisado meses antes.
Por isso, confira a correspondência entre identificador e versão.
Qual URL usar na referência de uma base ou dataset?
Quando existe uma página persistente do registro, ela tende a ser mais útil do que um endereço temporário de download.
Evite, sempre que possível, depender de URLs que:
- contêm tokens temporários;
- expiram após algumas horas;
- dependem de sessão autenticada;
- apontam para armazenamento temporário;
- representam apenas um download gerado naquele momento.
Página do registro e arquivo de download exercem funções diferentes
A página do registro pode oferecer:
- metadados;
- versão;
- DOI;
- licença;
- lista de arquivos;
- documentação.
Já o endereço de download pode simplesmente entregar os bytes de um arquivo.
Quando o objetivo é permitir identificação bibliográfica, a página persistente costuma oferecer contexto melhor.
URL longa de API
Uma consulta de API pode produzir uma URL como:
https://api.exemplo.org/v2/dados?territorio=123&ano=2025&variavel=x&categoria=y&formato=json
Copiar toda essa cadeia para a referência não é automaticamente a melhor solução.
Os parâmetros podem ser documentados na metodologia ou no script, enquanto a referência identifica a fonte ou serviço de dados.
O nível de detalhe depende da estabilidade e da função da consulta.
E quando não existe DOI, Handle nem identificador persistente?
Muitas fontes relevantes não possuem identificadores persistentes formais.
Isso é comum em:
- portais governamentais;
- sistemas administrativos;
- planilhas institucionais;
- bases históricas;
- páginas estatísticas;
- arquivos legados.
Nesse caso, a estratégia é maximizar a identificação utilizando os elementos realmente disponíveis.
Registre o responsável
Identifique a instituição ou autor responsável pelo recurso.
Registre o título ou denominação oficial
Use a designação apresentada pela fonte.
Registre o contexto do recurso
Dependendo do caso:
- sistema;
- pesquisa;
- tabela;
- edição;
- período;
- arquivo.
Utilize um endereço estável quando possível
Se não existe identificador persistente, prefira uma página institucional estável em vez de links temporários.
Documente a extração
Quanto mais dinâmica e menos persistente for a fonte, mais importante pode se tornar a documentação metodológica da obtenção dos dados.
Em resumo
Sem DOI não significa sem referência. Significa que a identificação dependerá mais fortemente dos demais metadados, do endereço institucional e da documentação metodológica.
Como relacionar a citação no texto à referência do dataset
A citação no texto precisa manter correspondência com a entrada bibliográfica.
Se a referência utiliza responsabilidade institucional, a citação deve permitir que o leitor reconheça essa mesma entrada.
Se utiliza autoria pessoal, o sistema de citação deve permanecer coerente com essa responsabilidade.
Citação narrativa
Em uma redação narrativa, o responsável integra a frase.
Exemplo estrutural:
Segundo [instituição ou autor] ([ano]), os dados…
Citação parentética
Em uma redação parentética, a atribuição aparece associada à informação apresentada.
Exemplo estrutural:
Os registros indicaram determinada tendência ([RESPONSÁVEL], [ano]).
Esses exemplos são estruturais e devem ser adaptados ao sistema de chamada e às regras utilizadas no trabalho.
Não cite o pesquisador como fonte de um dado externo apenas porque ele calculou o resultado
Suponha que você calcule uma taxa utilizando registros de uma base pública.
O cálculo pode ser seu, mas os dados subjacentes continuam tendo uma fonte.
É possível distinguir:
- origem dos dados;
- método de cálculo;
- resultado produzido pelo pesquisador.
Essa separação evita que “elaboração própria” apague a fonte original.
Dataset e artigo associado: como distribuir as citações?
Um dataset pode acompanhar um artigo que explica sua produção.
Nesse cenário, pergunte qual informação você está utilizando em cada passagem.
Quando o dado vem do dataset
O conjunto de dados precisa ser reconhecido conforme sua função.
Quando a explicação metodológica vem do artigo
O artigo pode ser a fonte da informação metodológica ou interpretativa.
Quando ambos são utilizados
É possível que ambos precisem aparecer no trabalho.
Isso não representa duplicação quando cada objeto sustenta uma dimensão diferente.
Na prática
Uma regra simples ajuda: cite o objeto que sustenta aquilo que você está afirmando naquele ponto do texto. Se a afirmação vem do artigo, reconheça o artigo. Se a análise reutiliza o dataset, preserve também a identidade do dataset.
Auditoria da referência: 20 perguntas antes de considerá-la pronta
Depois de montar a referência, não revise apenas pontuação, maiúsculas e ordem dos elementos.
Faça também uma auditoria de identidade.
- O objeto referenciado é realmente aquele que utilizei?
- A autoria foi obtida dos metadados?
- Confundi plataforma e autor?
- Confundi financiador e autor?
- Confundi mantenedor e autor?
- O título corresponde ao registro oficial?
- Usei o nome local do arquivo como se fosse título?
- A data corresponde ao evento correto?
- Existe versão?
- A versão citada foi realmente analisada?
- Inventei alguma versão ausente?
- Existe DOI?
- O DOI pertence ao dataset?
- O DOI pertence à versão correta?
- Existe outro identificador relevante?
- A URL é estável?
- Copiei uma URL temporária de download?
- A citação no texto corresponde à referência?
- A metodologia descreve o mesmo objeto?
- Um leitor consegue reconhecer a fonte sem depender de adivinhação?
Se alguma resposta revelar inconsistência, corrija a identidade do objeto antes de ajustar detalhes tipográficos.
Visão do especialista
Uma referência pode estar impecavelmente pontuada e ainda estar errada se identificar o artigo em vez do dataset, a plataforma em vez do responsável ou a versão atual em vez da versão analisada. A correção bibliográfica começa pela identidade do objeto.
Regra operacional para transformar metadados em referência
Quando encontrar uma nova fonte de dados, siga esta sequência:
- abra o registro oficial;
- identifique o tipo de objeto;
- localize os responsáveis;
- copie o título oficial;
- verifique data e versão;
- localize DOI ou outro identificador;
- identifique o repositório ou sistema;
- confira a página persistente;
- compare essas informações com o arquivo realmente analisado;
- só então adapte a estrutura da referência.
Essa sequência reduz a chance de criar referências baseadas apenas na aparência da página ou em modelos encontrados para objetos diferentes.
Em resumo
A montagem de uma referência de dataset começa pela leitura crítica dos metadados. Responsável, título, data, versão, identificador e ambiente de disponibilização exercem funções diferentes. DOI e URLs persistentes melhoram a identificação quando existem, mas sua ausência não impede a documentação de uma fonte legítima. O elemento decisivo é manter correspondência entre o objeto identificado, a citação realizada e os dados efetivamente utilizados.
Como citar dataset do Zenodo nas normas ABNT?
O Zenodo é um exemplo importante porque permite visualizar com clareza vários conceitos discutidos neste guia: dataset como objeto independente, metadados estruturados, DOI, versionamento, arquivos associados e relação entre diferentes produtos de pesquisa.
Ao encontrar um conjunto de dados no repositório, não comece copiando automaticamente a citação sugerida pela plataforma.
Primeiro, examine o registro.
Quais informações devem ser verificadas no Zenodo?
Dependendo do depósito, podem estar disponíveis elementos como:
- criadores;
- título;
- data de publicação;
- versão;
- DOI;
- descrição;
- licença;
- palavras-chave;
- arquivos;
- relações com outros recursos;
- histórico de versões.
Esses elementos ajudam a identificar o objeto e a construir a referência com base nos metadados reais.
Boa prática
Ao utilizar um dataset depositado no Zenodo, registre os metadados da versão efetivamente analisada no início da pesquisa. Isso reduz o risco de, meses depois, montar a referência a partir de uma versão diferente.
Zenodo é o autor do dataset?
Não automaticamente.
O Zenodo pode hospedar e preservar o recurso, enquanto a responsabilidade intelectual pertence aos criadores indicados no registro.
Por isso, diferencie:
- criador do dataset;
- repositório;
- instituição associada;
- financiador;
- contribuidores.
Esses papéis podem aparecer simultaneamente, mas não são intercambiáveis.
Modelo estrutural para dataset no Zenodo
Um modelo didático pode seguir a lógica:
AUTOR/RESPONSÁVEL. Título do dataset. Versão. Zenodo, ano. DOI: [DOI correspondente ao objeto utilizado].
Os elementos devem ser adaptados aos metadados reais e ao padrão bibliográfico adotado.
O que fazer se não houver versão explícita?
Não invente uma versão.
Se o registro não apresenta esse elemento, utilize os metadados efetivamente existentes e preserve outras informações que permitam identificar o objeto utilizado.
Zenodo: DOI de versão e identificação do conjunto de versões
O versionamento merece atenção especial porque diferentes estados de um mesmo recurso podem não conter exatamente os mesmos dados.
Em sistemas que preservam versões, pode existir uma distinção entre:
- o identificador de uma versão específica;
- o identificador que representa o recurso ao longo de suas versões.
Essa diferença possui consequências práticas.
Quando identificar a versão específica?
Se sua análise depende exatamente dos arquivos existentes em determinado estado do dataset, a versão específica aumenta a precisão da documentação.
Isso é particularmente importante quando:
- novos registros são acrescentados;
- erros são corrigidos;
- variáveis mudam;
- arquivos são substituídos;
- o conteúdo é ampliado;
- resultados podem mudar entre versões.
Quando a identificação mais ampla pode ter outra função?
Em determinados contextos, o pesquisador pode estar mencionando o projeto ou conjunto de dados em sentido geral, sem discutir uma análise vinculada a um estado específico.
Essa situação não é idêntica à necessidade de permitir que outra pessoa localize exatamente os dados utilizados para reproduzir uma análise.
Visão do especialista
Para fins de reprodutibilidade, pergunte: se alguém seguir minha referência, conseguirá chegar ao mesmo estado dos dados que produziu meus resultados? Essa pergunta ajuda a decidir a granularidade necessária.
Não atualize silenciosamente o DOI depois da análise
Imagine que você realizou toda a análise com a versão 1.0 e, antes da entrega do TCC, foi publicada a versão 2.0.
Não substitua automaticamente a identificação da versão apenas para apontar para o registro mais recente.
Primeiro verifique:
- o que mudou;
- se os arquivos analisados continuam iguais;
- se houve correções;
- se os resultados seriam afetados.
Se a versão nova modifica os dados utilizados, a questão deixa de ser apenas bibliográfica e passa a ser metodológica.
Preciso citar cada arquivo existente no Zenodo?
Nem sempre.
Um único registro pode conter:
- dados principais;
- documentação;
- scripts;
- dicionário de variáveis;
- arquivos auxiliares.
Se todos fazem parte de um dataset formalmente identificado, a referência pode representar o conjunto.
Na metodologia, informe quais arquivos efetivamente participaram da análise quando essa informação for relevante.
Quando um arquivo individual merece atenção especial?
Isso pode ocorrer quando:
- apenas um arquivo de um depósito muito amplo foi utilizado;
- o arquivo possui identificação própria;
- diferentes arquivos correspondem a períodos ou populações diferentes;
- a escolha do arquivo altera a interpretação dos resultados;
- é necessário indicar exatamente qual componente foi processado.
Como citar dataset do SciELO Data nas normas ABNT?
O SciELO Data é outro exemplo útil para compreender a publicação estruturada de dados de pesquisa.
Ao utilizar um conjunto depositado nesse tipo de repositório, comece pelo registro específico do dataset e não apenas pela página inicial da plataforma.
Quais elementos devem ser observados?
Verifique, conforme disponíveis:
- autores ou responsáveis;
- título;
- descrição;
- data;
- versão;
- DOI;
- arquivos;
- licença;
- documentação;
- relações com publicações associadas.
Esses elementos ajudam a diferenciar o dataset dos demais objetos relacionados.
Modelo estrutural para dataset no SciELO Data
AUTOR/RESPONSÁVEL. Título do dataset. Versão, quando pertinente. SciELO Data, ano. DOI: [identificador do dataset].
O modelo deve ser adaptado ao registro real.
Atenção
Não copie um exemplo deste guia e substitua apenas o título. Confira os metadados do dataset que você realmente utilizou. Autoria, versão, data, DOI e relações com outros objetos podem variar entre registros.
Dataset no SciELO Data e artigo científico são a mesma referência?
Não necessariamente.
Um dataset pode estar relacionado a um artigo científico sem deixar de possuir identidade própria.
Podemos ter:
artigo científico ↔ dataset associado
Os dois objetos podem possuir:
- títulos diferentes;
- metadados diferentes;
- DOIs diferentes;
- funções diferentes na pesquisa.
Quando citar o dataset?
Quando os dados foram reutilizados, reanalisados ou serviram diretamente como material para a pesquisa.
Quando citar o artigo?
Quando o trabalho utiliza:
- argumentos;
- interpretações;
- método descrito;
- resultados publicados;
- discussão científica;
- fundamentação teórica.
É possível citar os dois?
Sim.
Se você reutilizou os dados e também dependeu do artigo para compreender como foram produzidos, ambos podem exercer funções distintas no trabalho.
A referência do artigo não deve apagar a identidade do dataset quando o conjunto de dados foi efetivamente reutilizado.
Dataset, arquivo e documentação: qual objeto citar?
Em repositórios científicos, uma página pode reunir diversos componentes.
Por exemplo:
- dataset;
- CSV;
- planilha;
- README;
- codebook;
- protocolo;
- scripts;
- documentação metodológica;
- artigo relacionado.
O pesquisador precisa reconhecer a função de cada componente.
| Objeto | Função típica |
|---|---|
| Dataset | Conjunto de dados como produto de pesquisa |
| Arquivo | Componente utilizado para armazenar os registros |
| README | Orientar uso, estrutura e interpretação |
| Dicionário de dados | Definir variáveis, códigos e categorias |
| Script | Executar processamento ou análise |
| Artigo | Comunicar método, resultados e discussão científica |
A documentação também pode ser uma fonte
Se uma definição utilizada no TCC vem especificamente de um dicionário de dados, manual ou documentação metodológica, esse documento pode exercer uma função de fonte própria.
Isso é diferente de simplesmente utilizar o dataset como matéria-prima para uma análise.
Evite transformar tudo em uma única referência
Quando objetos diferentes exercem funções diferentes, tentar condensá-los artificialmente em uma única referência pode reduzir a clareza.
Em resumo
Em repositórios científicos, diferencie criadores, repositório, dataset, versão, arquivos, documentação e artigo associado. Um mesmo projeto pode gerar vários objetos citáveis, e a escolha depende do que efetivamente foi utilizado em seu trabalho.
Como citar dados do IBGE nas normas ABNT?
O Instituto Brasileiro de Geografia e Estatística é uma das fontes mais utilizadas em TCCs, dissertações, teses e artigos no Brasil.
Entretanto, escrever apenas:
Fonte: IBGE.
nem sempre é suficiente para documentar adequadamente os dados utilizados.
O IBGE disponibiliza muitos tipos de recursos, incluindo:
- pesquisas;
- censos;
- tabelas;
- séries históricas;
- microdados;
- publicações;
- arquivos geográficos;
- indicadores;
- APIs e serviços de consulta.
Por isso, o primeiro passo é identificar qual produto do IBGE entrou efetivamente na pesquisa.
IBGE é uma fonte, mas ainda é necessário identificar o recurso
Compare:
“Foram utilizados dados do IBGE.”
com:
“Foram utilizados microdados da [pesquisa], referentes ao período […], com seleção das variáveis […].”
A segunda formulação oferece muito mais informação sobre a origem e o recorte dos dados.
Como estruturar uma referência institucional?
Quando o IBGE é o responsável institucional pelo recurso, a referência pode partir da instituição e dos elementos específicos do produto utilizado.
Estruturalmente:
INSTITUTO BRASILEIRO DE GEOGRAFIA E ESTATÍSTICA. Título do recurso. [demais elementos pertinentes ao objeto].
O restante da referência depende de o objeto ser uma publicação, tabela, conjunto de microdados, sistema eletrônico ou outro recurso.
Como citar tabela do SIDRA nas normas ABNT?
O SIDRA permite consultar tabelas relacionadas a diferentes pesquisas e levantamentos estatísticos.
O ponto metodológico central é que o usuário pode selecionar filtros e gerar um resultado específico.
Por isso, não basta registrar apenas:
IBGE — SIDRA.
É recomendável preservar informações que permitam compreender qual consulta foi utilizada.
O que registrar em uma tabela do SIDRA?
Conforme a consulta, registre:
- instituição responsável;
- pesquisa;
- número da tabela;
- título da tabela;
- variável;
- classificação;
- período;
- território;
- unidade;
- filtros;
- data da consulta ou extração, quando pertinente.
Por que o número da tabela é útil?
Porque ele ajuda a identificar o recurso dentro do sistema.
Entretanto, o número sozinho pode não revelar o recorte utilizado.
Uma mesma tabela pode permitir combinações de:
- anos;
- estados;
- municípios;
- categorias;
- variáveis.
Por isso, referência e metodologia trabalham juntas.
Exemplo de documentação metodológica
Os dados foram obtidos no SIDRA/IBGE a partir da Tabela [número], selecionando-se [variável], para [território], no período de [período], com os filtros [filtros relevantes].
Esse tipo de descrição não substitui a referência. Ele complementa a identificação bibliográfica ao explicar o recorte.
Na prática
Quando fizer uma consulta no SIDRA, registre imediatamente o número da tabela e os filtros selecionados. Meses depois, lembrar apenas que “os dados vieram do IBGE” pode ser insuficiente para reconstruir a análise.
Como citar microdados do IBGE?
Microdados exigem uma documentação mais detalhada porque representam registros em nível mais desagregado e normalmente precisam ser processados antes da análise.
Dependendo da pesquisa, o estudante pode baixar:
- arquivos de pessoas;
- arquivos de domicílios;
- módulos específicos;
- dicionários;
- documentação metodológica;
- arquivos de apoio.
Identifique a pesquisa
Registre claramente qual levantamento produziu os microdados.
Identifique a edição ou período
Não escreva apenas “microdados do IBGE” se a análise depende de determinado ano, trimestre, edição ou onda da pesquisa.
Registre os arquivos utilizados
Se diferentes arquivos representam diferentes unidades ou módulos, documente quais entraram na análise.
Registre as variáveis
Em conjuntos extensos, anote:
- códigos;
- nomes;
- rótulos;
- categorias;
- unidades.
Consulte o dicionário e a documentação
Não interprete códigos apenas pelo nome da variável.
Verifique:
- definições;
- universo;
- categorias;
- valores especiais;
- regras de preenchimento;
- mudanças entre edições.
Pesos amostrais também podem ser relevantes
Quando a pesquisa utiliza desenho amostral, a análise pode exigir procedimentos específicos.
Se pesos, estratos ou unidades amostrais forem relevantes para a inferência, sua utilização deve ser explicada na metodologia.
Atenção
Citar corretamente o IBGE não corrige uma análise estatística inadequada. A referência resolve a identificação da fonte; o desenho analítico continua exigindo decisões metodológicas apropriadas.
Como citar uma série histórica do IBGE?
Quando a pesquisa utiliza uma série ao longo do tempo, registre qual indicador ou variável foi utilizado e o período efetivamente analisado.
Também verifique se:
- a metodologia mudou durante a série;
- existem quebras de comparabilidade;
- os valores foram revisados;
- as unidades permaneceram constantes;
- houve mudança de classificação.
Essas questões podem ser mais importantes para a interpretação dos resultados do que a simples aparência da referência.
Como citar arquivo Excel ou CSV baixado do IBGE?
O formato do arquivo não substitui a identificação da fonte.
Se você baixou um arquivo .xlsx ou .csv, procure descobrir:
- qual produto gerou o arquivo;
- qual tabela ou pesquisa ele representa;
- qual período contém;
- qual instituição é responsável;
- qual página oficial o disponibiliza.
Na metodologia, você pode informar que os dados foram obtidos em formato XLSX ou CSV quando isso for relevante para o processamento.
Mas a referência não deve tratar “Excel” ou “CSV” como a origem dos dados.
Como citar dados do IBGE obtidos por API?
Quando os registros são recuperados programaticamente, existem duas dimensões principais:
- a identificação da fonte dos dados;
- a documentação da consulta realizada.
Na metodologia, registre, conforme necessário:
- API utilizada;
- endpoint;
- parâmetros;
- identificador da tabela ou recurso;
- variáveis;
- território;
- período;
- data da extração;
- formato da resposta;
- script ou software utilizado.
Não tente necessariamente colocar todos esses elementos dentro da referência bibliográfica.
Como citar dados do DATASUS nas normas ABNT?
DATASUS aparece com enorme frequência em pesquisas brasileiras nas áreas de saúde pública, epidemiologia, gestão e políticas de saúde.
Um erro comum é tratar “DATASUS” como se fosse uma única base homogênea.
Na prática, diferentes sistemas podem estar envolvidos.
Entre os exemplos conhecidos estão:
- SIM — Sistema de Informações sobre Mortalidade;
- SINASC — Sistema de Informações sobre Nascidos Vivos;
- SIH/SUS — Sistema de Informações Hospitalares do SUS;
- SIA/SUS — Sistema de Informações Ambulatoriais do SUS;
- SINAN — Sistema de Informação de Agravos de Notificação;
- CNES — Cadastro Nacional de Estabelecimentos de Saúde.
Por isso, escrever apenas:
Fonte: DATASUS.
pode não fornecer granularidade suficiente para determinados estudos.
Qual sistema forneceu os dados?
Essa é a primeira pergunta.
O pesquisador deve identificar:
- sistema;
- tipo de registro;
- período;
- território;
- variáveis;
- filtros;
- forma de obtenção.
Essas informações tornam o percurso metodológico muito mais transparente.
DATASUS e TABNET são a mesma coisa?
Não devem ser tratados automaticamente como equivalentes.
O TABNET funciona como uma ferramenta de tabulação e consulta que pode permitir acesso a informações provenientes de diferentes sistemas.
Assim, uma pesquisa pode envolver a seguinte cadeia:
sistema de informação → ambiente de consulta/tabulação → filtros selecionados → tabela resultante.
Identificar apenas a interface pode ocultar o sistema que originou os registros.
O que registrar em uma consulta pelo TABNET?
Dependendo da análise:
- sistema de origem;
- linha;
- coluna;
- conteúdo;
- período;
- localidade;
- categorias;
- seleções adicionais;
- data da consulta.
Por que registrar linha, coluna e conteúdo?
Porque duas pessoas podem acessar o mesmo ambiente e produzir tabelas completamente diferentes.
O resultado depende da configuração da consulta.
Boa prática
Ao realizar uma consulta importante no TABNET, salve a tabela resultante e registre os filtros utilizados. Não dependa apenas da memória ou de uma URL de sessão.
Como citar dados do SIM?
Quando o estudo utiliza dados de mortalidade, identifique o Sistema de Informações sobre Mortalidade (SIM) como sistema de origem quando for esse o caso.
Na metodologia, registre os elementos relevantes para a análise, como:
- período;
- localidade;
- causa ou grupo de causas;
- faixa etária;
- sexo;
- outros critérios selecionados;
- data da extração.
Se foram calculadas taxas, explique também a origem dos denominadores e o procedimento utilizado.
Como citar dados do SINASC?
Quando a análise utiliza informações sobre nascidos vivos, identifique adequadamente o Sistema de Informações sobre Nascidos Vivos (SINASC) e o recorte utilizado.
Dependendo do estudo, podem ser relevantes variáveis relacionadas a:
- local de ocorrência;
- residência;
- idade materna;
- tipo de parto;
- peso ao nascer;
- idade gestacional;
- características do recém-nascido.
A referência identifica a fonte; a metodologia explica quais variáveis e critérios foram utilizados.
Como citar dados do SIH/SUS?
Em pesquisas que utilizam informações hospitalares, identifique o Sistema de Informações Hospitalares do SUS (SIH/SUS) quando ele for a fonte dos registros analisados.
Documente o recorte relevante e evite interpretar automaticamente registros administrativos como se fossem equivalentes a dados clínicos produzidos especificamente para pesquisa.
A natureza e as limitações da fonte precisam ser consideradas na análise.
Como citar dados do SIA/SUS?
Quando o estudo utiliza informações ambulatoriais provenientes do Sistema de Informações Ambulatoriais do SUS (SIA/SUS), identifique o sistema e descreva os critérios utilizados para selecionar os registros.
Dependendo do desenho da pesquisa, pode ser necessário explicar:
- procedimentos;
- competências;
- localidades;
- estabelecimentos;
- quantidades;
- valores;
- filtros aplicados.
Como citar dados do SINAN?
Quando os dados utilizados têm origem no Sistema de Informação de Agravos de Notificação (SINAN), identifique o sistema e o agravo ou conjunto de registros analisado.
A metodologia deve explicar critérios como:
- período;
- localidade;
- definição do evento;
- classificações utilizadas;
- filtros;
- tratamento de registros.
Como citar dados do CNES?
Quando a pesquisa utiliza informações do Cadastro Nacional de Estabelecimentos de Saúde (CNES), identifique o recurso e registre o período ou competência pertinente à análise.
Essa atenção é importante porque características de estabelecimentos e serviços podem mudar ao longo do tempo.
Como documentar microdados ou arquivos do DATASUS?
Quando o pesquisador baixa arquivos para processamento local, a documentação metodológica precisa ser ainda mais cuidadosa.
Registre:
- sistema de origem;
- arquivos;
- competências ou períodos;
- data de download;
- procedimento de importação;
- seleção de variáveis;
- filtros;
- limpeza;
- deduplicação, quando houver;
- transformações;
- software utilizado.
Se arquivos precisarem ser convertidos ou processados antes da análise, documente as etapas materialmente relevantes.
Como indicar DATASUS como fonte de tabela ou gráfico?
Se você produziu uma tabela ou gráfico a partir de dados consultados ou processados por você, não esconda a fonte original sob a expressão genérica “elaboração própria”.
Uma estrutura adaptável é:
Fonte: elaboração própria a partir de dados do [sistema/fonte], [período].
O detalhamento necessário depende do contexto da tabela e do que já foi explicado na metodologia.
Para as regras de apresentação e identificação desses elementos, consulte também Como Citar Imagens, Figuras, Gráficos e Tabelas nas Normas ABNT.
Por que a referência não basta em bases como IBGE e DATASUS?
Porque duas pesquisas podem citar a mesma instituição e produzir resultados completamente diferentes.
Imagine dois estudos que utilizam o DATASUS.
O primeiro seleciona:
- um sistema;
- um estado;
- cinco anos;
- determinada faixa etária.
O segundo utiliza:
- outro sistema;
- todo o Brasil;
- dez anos;
- outras categorias.
A referência institucional pode ser semelhante, mas os caminhos metodológicos são completamente diferentes.
Por isso, uma das regras centrais deste cluster permanece:
A referência identifica a fonte. A metodologia reconstrói o caminho percorrido entre a fonte e o resultado.
Como documentar uma consulta em base pública?
Uma ficha prática pode conter:
| Campo | Exemplo do que registrar |
|---|---|
| Instituição | Órgão responsável pelos dados |
| Sistema/pesquisa | Nome específico do recurso |
| Tabela/arquivo | Número, título ou nome |
| Período | Anos ou competências |
| Território | Brasil, estado, município etc. |
| Variáveis | Campos efetivamente utilizados |
| Filtros | Critérios de seleção |
| Data de extração | Quando os dados analisados foram obtidos |
| Formato | CSV, XLSX, arquivo específico etc. |
| Tratamento | Limpeza, transformação, agregação |
| Software | Ferramenta utilizada na análise |
Em resumo
Em bases públicas extensas, não pare no nome da instituição. Identifique o sistema, pesquisa, tabela, série ou conjunto de microdados que realmente forneceu os dados. Depois, utilize a metodologia para preservar período, território, variáveis, filtros, arquivos, transformações e demais decisões que levaram da fonte original ao resultado apresentado no TCC.
Repositório, dataset e arquivo: por que essa distinção importa na prática?
Repositórios de dados científicos facilitaram enormemente a publicação, preservação e reutilização de conjuntos de dados.
Ao mesmo tempo, criaram uma situação que pode confundir estudantes: uma única página pode apresentar simultaneamente o nome do repositório, os autores, o título do dataset, uma versão, um DOI, diversos arquivos, documentação e relações com outros trabalhos.
Para citar corretamente, é necessário entender o papel de cada elemento.
| Elemento | Função principal | Pergunta que ajuda a identificá-lo |
|---|---|---|
| Repositório | Hospeda, preserva e disponibiliza objetos | Onde o dataset está depositado? |
| Dataset | Representa o conjunto de dados identificado | Qual conjunto estou reutilizando? |
| Versão | Distingue estados do objeto | Qual estado dos dados utilizei? |
| Arquivo | Materializa parte ou todo o conteúdo | Qual arquivo efetivamente baixei? |
| DOI/identificador | Ajuda a identificar persistentemente o objeto | Qual identificador pertence a este recurso? |
| Documentação | Explica estrutura, variáveis e uso | Como interpretar corretamente os dados? |
| Artigo associado | Comunica resultados ou metodologia da pesquisa | Qual publicação explica ou analisa esses dados? |
Essa separação ajuda a evitar um erro recorrente: citar apenas o repositório quando o objeto efetivamente reutilizado possui identidade bibliográfica própria.
Boa prática
Quando um repositório disponibiliza metadados estruturados, registre-os no momento do download. Não espere a etapa final do TCC para tentar reconstruir versão, DOI, autores e arquivos utilizados.
Zenodo na prática: como documentar corretamente o dataset utilizado
Ao encontrar um conjunto de dados no Zenodo, o primeiro cuidado é não transformar automaticamente Zenodo em autoria.
O repositório disponibiliza o objeto, mas os criadores apresentados no registro podem ser pesquisadores, grupos ou instituições diferentes.
O que registrar antes de baixar os arquivos?
Crie uma ficha com, pelo menos:
- criadores;
- título;
- data;
- versão, quando apresentada;
- DOI;
- relação com outras versões;
- arquivos utilizados;
- licença;
- página do registro;
- data da obtenção dos dados.
Esses registros reduzem a possibilidade de posteriormente citar uma versão diferente daquela efetivamente analisada.
Exemplo hipotético de situação
Imagine um dataset com três versões:
- versão 1.0 — dados originais;
- versão 1.1 — correção de registros duplicados;
- versão 2.0 — inclusão de um novo período.
Você realizou a análise com a versão 1.1.
Meses depois, ao escrever o TCC, a página principal apresenta a versão 2.0 como mais recente.
Substituir silenciosamente a identificação da versão 1.1 pela 2.0 criaria um problema: a referência passaria a apontar para um estado diferente daquele que produziu os resultados.
Atenção
A versão mais recente não é automaticamente a versão correta para a referência de uma análise já realizada. A correspondência com os dados efetivamente utilizados vem primeiro.
DOI de versão específica e identificação do conjunto
Sistemas de versionamento podem permitir diferentes níveis de identificação.
Um identificador pode representar uma versão específica, enquanto outro pode funcionar como referência mais ampla ao conjunto de versões.
Para uma análise que depende dos valores existentes em determinado estado do dataset, a identificação da versão específica pode melhorar a rastreabilidade.
Para uma menção geral ao projeto de dados, outro nível de identificação pode cumprir função diferente.
O ponto central é não tratar esses identificadores como intercambiáveis sem verificar o que cada um resolve.
Não copie apenas o DOI visível sem abrir o registro
Confirme:
- qual título aparece;
- quais criadores aparecem;
- qual versão aparece;
- quais arquivos pertencem ao registro;
- se o identificador corresponde ao estado utilizado.
Vários arquivos dentro do mesmo registro
Um dataset depositado no Zenodo pode conter:
- dados brutos;
- dados processados;
- README;
- dicionário;
- scripts;
- documentação suplementar.
Se você utilizou somente o arquivo de dados processados, não é necessário necessariamente criar uma referência bibliográfica independente para cada arquivo.
Mas a metodologia deve deixar claro qual componente participou da análise.
Quando o README se torna metodologicamente importante?
Quando ele contém informações necessárias para interpretar:
- variáveis;
- códigos;
- unidades;
- procedimentos de coleta;
- limitações;
- estrutura dos arquivos.
Nesse caso, não trate o README como material irrelevante apenas porque ele não contém os registros numéricos.
Checklist rápido para dataset encontrado no Zenodo
Antes de fechar a aba do navegador, confirme:
- [ ] Quem são os criadores?
- [ ] Qual é o título?
- [ ] Existe versão?
- [ ] Qual versão baixei?
- [ ] Qual DOI corresponde a ela?
- [ ] Existe identificador mais amplo relacionado?
- [ ] Quais arquivos utilizei?
- [ ] Existe README?
- [ ] Existe documentação?
- [ ] Existe artigo associado?
- [ ] Qual é a licença?
- [ ] Registrei a data de obtenção?
Esse pequeno controle pode economizar horas de reconstrução bibliográfica no final do TCC.
SciELO Data na prática: dataset, artigo associado e arquivos
O SciELO Data permite que dados de pesquisa sejam depositados e disponibilizados com metadados próprios.
Para o estudante, o ponto mais importante é reconhecer que dataset e artigo associado podem ser objetos diferentes.
O dataset pode ter identidade própria
Procure no registro:
- autores ou criadores;
- título;
- data;
- versão, quando aplicável;
- DOI;
- descrição;
- arquivos;
- documentação;
- licença;
- relações com publicações.
Artigo e dataset podem ter identificadores diferentes
Isso acontece porque cada um representa um objeto distinto.
O artigo pode descrever:
- objetivos;
- metodologia;
- análises;
- resultados;
- interpretação.
O dataset, por sua vez, pode disponibilizar os registros reutilizáveis.
Se você lê o artigo para compreender a metodologia e utiliza o dataset para fazer uma nova análise, os dois objetos participam da pesquisa de maneiras diferentes.
Não substitua o dataset pelo artigo apenas porque o artigo parece mais familiar
Estudantes estão acostumados a referenciar artigos científicos. Por isso, diante de um dataset associado a um artigo, pode surgir a tentação de citar somente o artigo.
Mas, se os registros foram efetivamente reutilizados, a identidade do conjunto de dados não deve desaparecer.
Arquivo individual e conjunto depositado
Um registro pode conter diversos arquivos.
Na metodologia, registre qual arquivo ou quais arquivos foram efetivamente utilizados.
Isso é especialmente importante quando existem:
- dados brutos;
- dados tratados;
- arquivos suplementares;
- dicionários;
- scripts;
- documentos metodológicos.
Use a documentação para interpretar os dados
Não abra uma planilha e comece a analisar códigos desconhecidos apenas porque os valores parecem intuitivos.
Procure documentação sobre:
- significado das variáveis;
- categorias;
- valores ausentes;
- unidades;
- procedimentos de coleta;
- limitações.
Erro comum
Utilizar o DOI do artigo como se fosse o identificador do dataset apenas porque ambos aparecem relacionados na mesma pesquisa.
Quando citar o dataset, o artigo ou os dois?
Uma maneira prática de decidir é observar a função de cada objeto no trabalho.
| O que você utilizou? | Objeto que merece atenção |
|---|---|
| Resultados e discussão publicados | Artigo |
| Descrição metodológica apresentada no artigo | Artigo |
| Registros disponibilizados para nova análise | Dataset |
| Registros + explicação metodológica do artigo | Dataset e artigo podem ser relevantes |
| Apenas documentação do dataset | Documentação, conforme sua função |
| Software associado | Software, quando pertinente |
A regra não é “cite tudo que aparece na página”.
A regra prática é reconhecer os objetos que efetivamente sustentaram a pesquisa.
IBGE: por que escrever apenas “Fonte: IBGE” pode ser insuficiente?
O IBGE produz e disponibiliza grande variedade de informações.
Entre elas podem estar:
- censos;
- pesquisas amostrais;
- levantamentos econômicos;
- estatísticas demográficas;
- tabelas;
- séries históricas;
- indicadores;
- microdados;
- arquivos geográficos;
- APIs.
Portanto, escrever apenas:
Fonte: IBGE.
pode identificar a instituição, mas não necessariamente o recurso utilizado.
Quanto mais importante for a possibilidade de reconstruir a análise, mais útil se torna especificar o produto.
Comece identificando a pesquisa ou sistema
Pergunte:
- os dados vieram de qual pesquisa?
- de qual censo?
- de qual tabela?
- de qual série?
- de quais microdados?
- de qual API?
Depois registre o recorte realizado.
SIDRA: como documentar uma consulta além da referência
O SIDRA permite gerar tabelas por meio da seleção de dimensões e categorias.
Uma consulta pode depender de escolhas como:
- tabela;
- variável;
- período;
- território;
- classificação;
- categoria;
- nível territorial.
Por isso, dois pesquisadores podem acessar a mesma tabela e extrair resultados diferentes.
O número da tabela é um elemento de rastreabilidade valioso
Quando disponível, registre o número ou código da tabela.
Ele ajuda a distinguir o recurso de outras tabelas com temas semelhantes.
Registre o título da tabela
O título oferece contexto semântico e ajuda a verificar se o código foi anotado corretamente.
Registre as variáveis selecionadas
Uma tabela pode permitir diferentes medidas.
Por exemplo:
- quantidade;
- percentual;
- taxa;
- valor;
- índice.
A variável utilizada precisa estar clara na metodologia ou documentação da análise.
Registre o período
Não presuma que a tabela consultada permanecerá limitada aos mesmos anos.
Novos períodos podem ser incorporados posteriormente.
Registre o território
A consulta pode utilizar:
- Brasil;
- região;
- unidade da federação;
- município;
- outro recorte territorial disponível.
Registre classificações e categorias
Esse detalhe pode ser decisivo.
Imagine uma tabela com classificação por:
- sexo;
- faixa etária;
- situação do domicílio;
- atividade econômica.
Uma análise que seleciona apenas uma categoria não está utilizando a tabela inteira de forma indiferenciada.
Na prática
Para uma consulta do SIDRA, mantenha junto ao projeto uma pequena ficha com número da tabela + título + variável + período + território + classificações + categorias + data de extração.
O que vai para a referência e o que fica na metodologia em uma consulta do SIDRA?
Não é necessário transformar a referência em uma reprodução integral da tela de consulta.
Uma divisão operacional pode ser:
| Informação | Referência | Metodologia/documentação |
|---|---|---|
| Instituição responsável | Sim | Pode aparecer |
| Pesquisa/recurso | Sim, conforme o objeto | Sim |
| Tabela | Pode integrar a identificação | Sim |
| Período | Conforme o objeto | Sim |
| Território | Conforme o objeto | Sim |
| Variáveis | Normalmente não em detalhe | Sim |
| Filtros | Normalmente não | Sim |
| Classificações | Normalmente não em detalhe | Sim |
| Tratamento posterior | Não | Sim |
O objetivo é preservar tanto a identificação bibliográfica quanto a reconstrução metodológica sem sobrecarregar uma única camada.
Microdados do IBGE: por que exigem documentação mais detalhada?
Microdados são diferentes de uma tabela já agregada.
Em vez de receber apenas um resultado pronto, o pesquisador trabalha com registros que precisam ser interpretados e processados.
Isso aumenta a responsabilidade metodológica.
Identifique a pesquisa
Não escreva apenas “microdados do IBGE”.
Registre qual pesquisa originou os arquivos.
Identifique edição, período ou onda
Pesquisas recorrentes podem possuir:
- edições anuais;
- trimestres;
- ondas;
- anos de referência;
- versões corrigidas.
Registre os arquivos utilizados
Uma distribuição de microdados pode conter diversos arquivos.
Documente quais entraram na análise.
Preserve dicionários e layouts
O arquivo de dados sozinho pode ser insuficiente para interpretar:
- nomes das variáveis;
- posições;
- categorias;
- códigos;
- valores especiais;
- unidades.
Guarde junto ao projeto a documentação correspondente à edição analisada.
Pesos amostrais podem ser metodologicamente decisivos
Quando a pesquisa possui desenho amostral, não presuma que cada registro pode ser tratado como uma observação simples sem considerar a documentação metodológica.
A necessidade de pesos, estratos, conglomerados ou outros elementos depende da pesquisa e do objetivo analítico.
Esse é um problema de metodologia estatística, não apenas de formatação da referência.
Atenção
Uma referência bibliográfica perfeita não corrige uma análise inadequada dos microdados. A documentação da fonte e a metodologia estatística precisam trabalhar juntas.
Séries históricas do IBGE: cuidado com revisões e mudanças metodológicas
Uma série histórica pode parecer simples porque apresenta valores ao longo do tempo.
Entretanto, antes de comparar anos, verifique se ocorreram:
- mudanças conceituais;
- mudanças de classificação;
- revisões;
- alterações territoriais;
- mudanças metodológicas;
- interrupções da série.
Uma sequência de números disponível na mesma página não garante automaticamente comparabilidade perfeita entre todos os períodos.
Quando a documentação oficial sinaliza ruptura ou revisão, essa informação pode ser importante para a interpretação do TCC.
IBGE por API: a referência sozinha não reconstrói a consulta
Uma API pode permitir automatizar a obtenção de dados do IBGE.
Nesse cenário, documente a cadeia:
IBGE → recurso/API → endpoint → parâmetros → resposta → processamento → base analítica.
Dependendo da consulta, registre:
- serviço utilizado;
- endpoint;
- parâmetros;
- códigos territoriais;
- variáveis;
- período;
- data de extração;
- formato da resposta;
- script utilizado.
Esses detalhes podem permanecer na metodologia, apêndice, script ou documentação do projeto sem serem todos transferidos para a referência.
DATASUS: identifique o sistema antes de citar os números
“DATASUS” é frequentemente utilizado como rótulo genérico para diferentes fontes de informação em saúde.
Entretanto, o pesquisador precisa descobrir qual sistema originou os dados.
Entre os exemplos que podem aparecer em pesquisas acadêmicas estão:
- Sistema de Informações sobre Mortalidade — SIM;
- Sistema de Informações sobre Nascidos Vivos — SINASC;
- Sistema de Informações Hospitalares do SUS — SIH/SUS;
- Sistema de Informações Ambulatoriais do SUS — SIA/SUS;
- Sistema de Informação de Agravos de Notificação — SINAN;
- Cadastro Nacional de Estabelecimentos de Saúde — CNES.
Cada sistema representa uma estrutura de informação diferente.
Consequentemente, escrever apenas “dados do DATASUS” pode ocultar uma distinção metodológica importante.
Por que o sistema de origem importa?
Porque sistemas diferentes podem possuir:
- unidades de registro diferentes;
- coberturas diferentes;
- variáveis diferentes;
- processos de atualização diferentes;
- limitações diferentes.
O pesquisador precisa conhecer minimamente a natureza da fonte que está analisando.
TABNET é a interface de consulta ou a fonte dos dados?
Essa pergunta é importante porque a interface utilizada para tabular informações não necessariamente representa, sozinha, a origem dos registros.
Uma consulta pode envolver:
sistema de informação → dados disponibilizados → TABNET → seleção do pesquisador → tabela resultante.
Documentar apenas “TABNET” pode perder o sistema de origem.
Por outro lado, ignorar completamente a interface pode ocultar como a tabela foi produzida.
Por isso, fonte e mecanismo de consulta podem precisar aparecer em camadas diferentes da documentação.
O que registrar em uma consulta pelo TABNET?
Conforme a análise:
- sistema de informação;
- indicador ou conteúdo consultado;
- linha;
- coluna;
- conteúdo;
- período;
- território;
- filtros;
- data de extração.
A nomenclatura exata depende da interface e do recurso utilizado.
DATASUS: o recorte precisa aparecer na metodologia
Considere dois estudos que utilizam o mesmo sistema.
O primeiro analisa:
- Brasil inteiro;
- dez anos;
- todas as faixas etárias.
O segundo analisa:
- um único estado;
- dois anos;
- uma faixa etária específica.
A fonte pode ser a mesma, mas o objeto analítico é diferente.
A metodologia precisa deixar esse recorte claro.
Período
Registre os anos ou meses incluídos.
Território
Registre o nível geográfico analisado.
População
Informe os critérios utilizados para definir os registros pertinentes.
Variáveis e filtros
Documente as escolhas que alteram o conjunto final.
Extração
Em bases sujeitas a atualização, registre quando a consulta foi realizada.
Dados preliminares, atualizações e revisões: por que isso merece atenção?
Bases administrativas podem passar por atualização, consolidação ou correção.
Isso significa que uma consulta realizada em momentos diferentes pode, dependendo do sistema e período, retornar valores distintos.
Por isso, ao utilizar dados sujeitos a atualização:
- registre a data de extração;
- verifique notas metodológicas;
- observe indicações de dados preliminares;
- preserve o arquivo exportado quando permitido;
- não substitua silenciosamente os números sem revisar os resultados.
Boa prática
Se a base for atualizada durante a redação do TCC, não altere apenas a referência. Primeiro verifique se os registros utilizados também mudaram e se a mudança afeta tabelas, gráficos, cálculos ou conclusões.
Microdados do DATASUS: o download é apenas o começo
Quando a pesquisa trabalha com arquivos de microdados, a documentação precisa ir além do endereço de download.
Registre:
- sistema de origem;
- período;
- arquivos;
- estrutura dos registros;
- documentação utilizada;
- variáveis selecionadas;
- critérios de inclusão;
- critérios de exclusão;
- transformações;
- tratamento de duplicidades;
- tratamento de ausentes;
- software ou scripts relevantes.
Arquivos compactados e formatos técnicos não são a fonte
O fato de os dados terem sido obtidos em determinado formato não altera automaticamente a identidade institucional do recurso.
O formato deve ser documentado quando é metodologicamente relevante, mas não deve substituir o sistema que originou os registros.
Preserve a documentação correspondente ao período analisado
Dicionários de dados e layouts podem mudar.
Utilizar uma documentação recente para interpretar arquivos antigos sem verificar compatibilidade pode gerar erros.
Como indicar a fonte de tabelas e gráficos produzidos com IBGE ou DATASUS?
Quando o pesquisador constrói uma tabela a partir de dados externos, existem duas dimensões:
- a elaboração da tabela;
- a origem dos dados.
Por isso, escrever apenas:
Fonte: elaboração própria.
pode ser insuficiente quando os registros vieram de uma fonte externa.
Uma formulação estrutural possível é:
Fonte: elaboração própria a partir de dados do [recurso/instituição], [período].
Adapte a formulação às regras da instituição e ao grau de especificidade necessário.
Quando existem duas fontes
Se uma tabela combina dados do IBGE e DATASUS, por exemplo, preserve as duas origens.
Na metodologia, explique como ocorreu a integração.
Quando o indicador foi calculado pelo pesquisador
É importante diferenciar:
- dados de entrada;
- fórmula ou método de cálculo;
- resultado derivado.
A instituição que forneceu os dados não deve ser apresentada como autora de um indicador que foi criado pelo pesquisador, mas sua contribuição como fonte dos registros continua existindo.
Ficha prática para documentar IBGE, SIDRA, DATASUS e TABNET
Durante a pesquisa, utilize uma ficha como esta:
| Campo | Registro |
|---|---|
| Instituição | [preencher] |
| Sistema/pesquisa | [preencher] |
| Tabela/dataset/recurso | [preencher] |
| Código ou número | [preencher] |
| Período | [preencher] |
| Território | [preencher] |
| População | [preencher] |
| Variáveis | [preencher] |
| Classificações | [preencher] |
| Filtros | [preencher] |
| Data de extração | [preencher] |
| Arquivo exportado | [preencher] |
| Documentação utilizada | [preencher] |
| Transformações posteriores | [preencher] |
| Observações metodológicas | [preencher] |
Essa ficha não precisa aparecer integralmente no TCC.
Ela funciona como documentação de trabalho para que, na etapa de redação, você consiga distribuir as informações corretamente entre referência, metodologia, tabelas, gráficos e materiais complementares.
Teste de rastreabilidade para dados públicos
Antes de considerar a documentação concluída, tente responder:
- Qual instituição responde pelos dados?
- Qual pesquisa ou sistema os produziu?
- Qual tabela, dataset ou arquivo utilizei?
- Qual período foi analisado?
- Qual território foi selecionado?
- Quais variáveis entraram na análise?
- Quais filtros foram aplicados?
- Quando os dados foram extraídos?
- Que transformações foram realizadas?
- As tabelas e gráficos preservam a origem dos registros?
Se essas respostas estiverem documentadas, a pesquisa deixa de depender apenas de uma referência genérica à instituição.
Em resumo
Zenodo e SciELO Data exigem atenção à identidade do dataset, versão, DOI, arquivos e relação com artigos associados. Já IBGE, SIDRA, DATASUS e TABNET exigem especial cuidado com produto, sistema, tabela, consulta, período, território, variáveis e filtros. Em todos esses casos, a referência identifica a fonte, enquanto a metodologia reconstrói o caminho percorrido entre a fonte e o resultado.
Como citar dados do Banco Mundial nas normas ABNT?
O Banco Mundial disponibiliza grande quantidade de indicadores econômicos, sociais, demográficos, ambientais e institucionais utilizados em trabalhos acadêmicos.
Um dos erros mais comuns é registrar apenas:
Fonte: Banco Mundial.
Essa indicação pode ser insuficiente quando a pesquisa depende de um indicador específico, determinado período ou conjunto de países.
O procedimento mais seguro é identificar qual recurso ou indicador foi efetivamente utilizado.
O que registrar ao utilizar indicadores do Banco Mundial?
Dependendo da pesquisa, registre:
- instituição responsável;
- base ou coleção;
- nome do indicador;
- código do indicador;
- país ou conjunto de países;
- período;
- unidade;
- fonte indicada nos metadados;
- data da extração;
- eventuais transformações realizadas.
Por que registrar o código do indicador?
O código ajuda a diferenciar indicadores com nomes semelhantes e facilita a reconstrução da consulta.
Imagine que o estudante registre apenas:
PIB — Banco Mundial.
Essa informação pode ser insuficiente porque diferentes indicadores relacionados ao Produto Interno Bruto podem utilizar:
- valores correntes;
- valores constantes;
- moeda nacional;
- dólares;
- paridade do poder de compra;
- valores per capita;
- taxas de crescimento.
O código e os metadados ajudam a evitar ambiguidades.
World Development Indicators e outros conjuntos
Quando o indicador pertence a uma coleção ou base identificável, como um conjunto de indicadores de desenvolvimento, registre essa informação quando ela contribuir para a identificação da fonte.
Não reduza automaticamente todos os recursos disponibilizados pela instituição a uma única base genérica.
Modelo estrutural
Dependendo do objeto, uma referência institucional pode partir da seguinte lógica:
WORLD BANK. Título do indicador ou recurso. [base ou coleção, quando pertinente]. [demais elementos de identificação e acesso].
O modelo precisa ser adaptado ao recurso real e às regras bibliográficas aplicáveis.
Boa prática
Salve o nome e o código do indicador no momento da extração. Isso reduz o risco de citar posteriormente um indicador parecido, mas metodologicamente diferente daquele que realmente entrou na análise.
Como citar uma série temporal do Banco Mundial?
Quando o trabalho analisa um indicador ao longo de vários anos, a referência identifica a fonte, enquanto a metodologia deve explicar o recorte temporal.
Registre:
- indicador;
- código;
- países ou territórios;
- ano inicial;
- ano final;
- unidade;
- eventuais lacunas;
- tratamento aplicado aos valores ausentes;
- transformações.
Verifique mudanças metodológicas
Uma série longa pode sofrer:
- revisões;
- mudanças de metodologia;
- atualizações retroativas;
- mudanças na fonte primária;
- reclassificações.
Se essas alterações forem relevantes para a interpretação, elas precisam ser consideradas na análise.
Como citar dados do Banco Mundial obtidos por API?
Quando os dados são recuperados programaticamente, diferencie novamente:
fonte dos dados ≠ interface de acesso ≠ resposta recebida ≠ arquivo salvo pelo pesquisador.
A API é o mecanismo utilizado para recuperar os registros.
Na metodologia, pode ser pertinente registrar:
- API utilizada;
- indicadores solicitados;
- países;
- período;
- parâmetros;
- paginação;
- formato da resposta;
- data da extração;
- script ou software utilizado.
A referência não precisa necessariamente conter cada parâmetro técnico da consulta.
Como citar dataset do Kaggle nas normas ABNT?
O Kaggle exige atenção especial porque pode hospedar conjuntos com origens muito diferentes.
Um dataset encontrado na plataforma pode ter sido:
- produzido pelo próprio usuário que o publicou;
- obtido de uma instituição externa;
- copiado de outra plataforma;
- tratado a partir de uma fonte pública;
- combinado a partir de várias fontes;
- derivado de um conjunto anterior;
- atualizado independentemente da fonte original.
Portanto, antes de montar a referência, investigue a proveniência.
Kaggle é o autor do dataset?
Não automaticamente.
O fato de o arquivo estar hospedado na plataforma não significa que ela produziu os dados.
Verifique:
- quem publicou o conjunto;
- quem produziu os dados originalmente;
- qual fonte é declarada;
- se houve transformações;
- qual versão foi utilizada;
- qual licença é apresentada;
- se existe documentação.
Cenário 1 — O publicador produziu os dados
Se os metadados e a documentação indicam que o responsável pelo registro criou efetivamente o conjunto, a autoria pode estar vinculada a esse responsável.
Cenário 2 — O dataset é uma cópia de outra fonte
Se o usuário apenas republicou dados de uma instituição, citar somente o perfil do Kaggle pode ocultar a origem.
Investigue a fonte primária.
Cenário 3 — O dataset foi transformado
Se o publicador realizou:
- limpeza;
- integração;
- recodificação;
- seleção;
- enriquecimento;
- criação de variáveis
antes de disponibilizar o conjunto, o recurso encontrado pode representar um objeto derivado.
Nesse caso, pode ser necessário reconhecer tanto a proveniência original quanto a transformação que deu origem ao dataset efetivamente utilizado.
Atenção
Não substitua uma análise de proveniência pela frase “Fonte: Kaggle”. A plataforma informa onde você encontrou o recurso, mas não necessariamente quem produziu os dados nem quais transformações ocorreram antes da publicação.
Como registrar a versão de um dataset do Kaggle?
Quando a plataforma ou o responsável mantém histórico de versões, registre qual estado do conjunto participou da análise.
Isso é especialmente importante quando:
- arquivos são substituídos;
- linhas são adicionadas;
- erros são corrigidos;
- novas colunas aparecem;
- a limpeza é refeita;
- o conjunto é atualizado periodicamente.
Se a plataforma não fornece um identificador persistente comparável a um DOI, preserve localmente informações suficientes para reconstruir o estado utilizado.
Devo citar o Kaggle ou a fonte original?
A resposta depende da cadeia de proveniência e do objeto efetivamente utilizado.
Considere:
fonte original → processamento por terceiro → dataset no Kaggle → processamento pelo pesquisador.
Se o conjunto disponível no Kaggle é apenas uma reprodução fiel, a fonte original pode exercer papel central.
Se houve transformação material realizada pelo publicador, o dataset derivado também pode precisar ser identificado.
Se sua análise depende exatamente da versão tratada disponível no Kaggle, ignorar essa camada pode dificultar a reprodução dos resultados.
Como citar dataset de repositório institucional?
Universidades, centros de pesquisa, agências e outras instituições podem manter repositórios próprios de dados.
O raciocínio é semelhante ao aplicado aos grandes repositórios científicos.
Procure:
- criadores;
- título;
- data;
- versão;
- identificador persistente;
- instituição;
- coleção;
- licença;
- arquivos;
- documentação.
Instituição hospedeira e autoria podem ser diferentes
Um repositório de uma universidade pode hospedar um dataset criado por pesquisadores específicos.
Não transforme automaticamente a universidade em autora se os metadados indicarem outros responsáveis.
Handle e outros identificadores
Alguns repositórios utilizam Handle ou outros mecanismos persistentes em vez de DOI.
A ausência de DOI não torna o recurso automaticamente inadequado.
O importante é identificar o objeto com os elementos realmente disponíveis.
Figshare, Dryad, OSF e Dataverse: o raciocínio muda?
A lógica geral permanece semelhante:
- identifique o objeto;
- recupere os metadados;
- verifique autoria;
- confira versão;
- verifique identificadores;
- registre os arquivos utilizados;
- documente o recorte e o tratamento na metodologia.
O que muda é a infraestrutura e a maneira como cada ambiente organiza seus registros.
Não copie automaticamente a citação gerada
Muitos repositórios oferecem funções como:
- Cite;
- Export citation;
- BibTeX;
- RIS;
- EndNote;
- outros formatos.
Essas ferramentas podem ser muito úteis para recuperar metadados.
Entretanto, a saída automática deve ser conferida antes de entrar no TCC.
Verifique:
- responsabilidade;
- ordem dos nomes;
- título;
- data;
- versão;
- tipo de recurso;
- identificador;
- adequação ao padrão adotado.
Erro comum
Tratar a referência gerada automaticamente por um repositório como se ela fosse, por definição, uma referência ABNT pronta. A ferramenta ajuda a recuperar metadados; a normalização bibliográfica continua precisando ser conferida.
Como citar tabela criada a partir de uma base de dados?
Quando o estudante cria uma tabela a partir de dados de terceiros, existem pelo menos duas dimensões de autoria:
- a autoria da organização visual da tabela;
- a proveniência dos dados utilizados.
Por isso, escrever somente:
Fonte: elaboração própria.
pode ser insuficiente quando os números foram obtidos de uma fonte externa.
Modelo adaptável
Fonte: elaboração própria a partir de dados de [fonte], [período, quando pertinente].
Esse modelo deixa claro que:
- o pesquisador elaborou a tabela;
- os dados não foram necessariamente produzidos por ele.
E se a tabela reproduzir uma tabela já publicada?
Nesse caso, a situação é diferente.
Você deve distinguir entre:
- reprodução;
- adaptação;
- nova elaboração a partir dos dados.
Para aprofundar essa distinção, consulte Como Citar Imagens, Figuras, Gráficos e Tabelas nas Normas ABNT.
A fonte abaixo da tabela substitui a referência?
Não necessariamente.
A indicação de fonte ajuda o leitor a compreender a origem dos números apresentados naquele elemento.
A referência bibliográfica desempenha outra função: identificar a fonte de maneira mais completa.
Como citar gráfico criado a partir de um dataset?
O mesmo princípio se aplica aos gráficos.
Se você criou a visualização, mas os números vieram de outra fonte, preserve as duas informações.
Exemplo estrutural:
Fonte: elaboração própria a partir de dados de [fonte].
E se o gráfico combinar duas ou mais bases?
Indique as fontes materialmente utilizadas e explique a integração na metodologia.
Por exemplo:
Fonte: elaboração própria a partir de dados de [fonte A] e [fonte B].
Se a integração exigiu harmonização, transformação ou cálculo, esses procedimentos devem ser explicados na metodologia.
E se o gráfico apresentar um indicador calculado pelo pesquisador?
Deixe claro que o resultado foi calculado a partir dos dados.
Não atribua automaticamente à instituição um indicador que ela não publicou.
Por exemplo:
Fonte: elaboração própria a partir de dados de [fonte].
A metodologia deve explicar como o indicador foi calculado.
Visão do especialista
“Elaboração própria” informa quem construiu a tabela ou o gráfico; não necessariamente informa quem produziu os dados. Quando existe fonte externa, preserve sua proveniência.
Como citar dados obtidos por API?
APIs permitem que sistemas e scripts recuperem dados automaticamente.
Elas são cada vez mais comuns em pesquisas que trabalham com:
- indicadores econômicos;
- estatísticas públicas;
- dados meteorológicos;
- dados geográficos;
- informações científicas;
- registros administrativos;
- grandes volumes de dados.
A principal dificuldade é separar quatro elementos:
fonte dos dados → API → consulta → resposta.
1. Fonte dos dados
É o sistema, instituição ou conjunto que fornece as informações.
2. API
É a interface pela qual o pesquisador solicita os registros.
3. Consulta
É formada pelos parâmetros utilizados.
4. Resposta
É o conteúdo devolvido pela API, muitas vezes em formatos como:
- JSON;
- XML;
- CSV.
Essas camadas não devem ser confundidas.
O que registrar ao utilizar uma API na pesquisa?
Dependendo do sistema e da importância da consulta para a reprodutibilidade, registre:
- nome da API;
- instituição responsável;
- versão da API;
- endpoint;
- parâmetros;
- filtros;
- data e, quando necessário, horário da extração;
- formato da resposta;
- paginação;
- limites de requisição;
- script ou software utilizado;
- tratamento posterior.
Todos esses elementos vão para a referência?
Não.
Muitos deles pertencem à metodologia, ao código ou à documentação suplementar.
A referência deve continuar identificando adequadamente o recurso ou fonte.
Endpoint é a mesma coisa que referência?
Não necessariamente.
Um endpoint pode ser apenas um endereço técnico utilizado para realizar uma requisição.
Em alguns sistemas, ele é estável e informativo. Em outros, a consulta completa inclui dezenas de parâmetros ou elementos temporários.
Por isso, não transforme automaticamente toda URL de requisição em referência bibliográfica.
Como documentar parâmetros de uma API?
Os parâmetros determinam quais dados serão retornados.
Por exemplo, uma consulta pode selecionar:
- país;
- município;
- indicador;
- ano;
- categoria;
- idioma;
- número de registros por página.
Se esses parâmetros influenciam os resultados, precisam ser preservados de alguma forma.
Isso pode ser feito:
- na metodologia;
- em tabela metodológica;
- em apêndice;
- em script;
- em arquivo de configuração;
- em documentação suplementar.
Paginação de API precisa ser documentada?
Sim, quando ela interfere na recuperação completa dos registros.
Algumas APIs retornam apenas uma quantidade limitada de observações por requisição.
Se o pesquisador recuperar apenas a primeira página sem perceber a paginação, poderá analisar uma fração do conjunto acreditando que possui todos os dados.
Por isso, registre:
- limite por página;
- quantidade de páginas;
- procedimento de iteração;
- verificação do total de registros.
Atenção
Uma citação bibliográfica perfeita não corrige uma extração incompleta. Quando a pesquisa depende de API, a qualidade metodológica também exige verificar paginação, parâmetros, limites e integridade da resposta.
Como citar uma API com dados atualizados em tempo real?
Quando os dados mudam continuamente, registrar apenas a fonte pode não ser suficiente para reproduzir o estado utilizado.
Considere preservar:
- data da extração;
- horário, quando materialmente relevante;
- parâmetros;
- resposta original;
- snapshot;
- script utilizado;
- versão da API.
Nem todas essas medidas são necessárias em toda pesquisa.
O nível de documentação deve ser proporcional à importância da variabilidade temporal para os resultados.
Como citar dados recebidos em JSON?
JSON é um formato de representação dos dados.
Ele não é, por si só, a fonte.
Se uma API retorna um arquivo ou resposta JSON, a documentação deve identificar:
- a fonte dos registros;
- a API;
- a consulta;
- o momento da extração;
- o processamento realizado.
O mesmo princípio vale para XML e outros formatos.
Preciso citar o script ou software usado para acessar a API?
Isso depende da relevância da ferramenta para a pesquisa e das exigências aplicáveis.
Se o script é essencial para:
- reproduzir a extração;
- processar paginação;
- autenticar;
- transformar respostas;
- construir a base analítica,
sua documentação pode ser importante.
Software e dataset, entretanto, continuam sendo objetos diferentes.
Para essa dimensão, consulte Como Citar Software nas Normas ABNT.
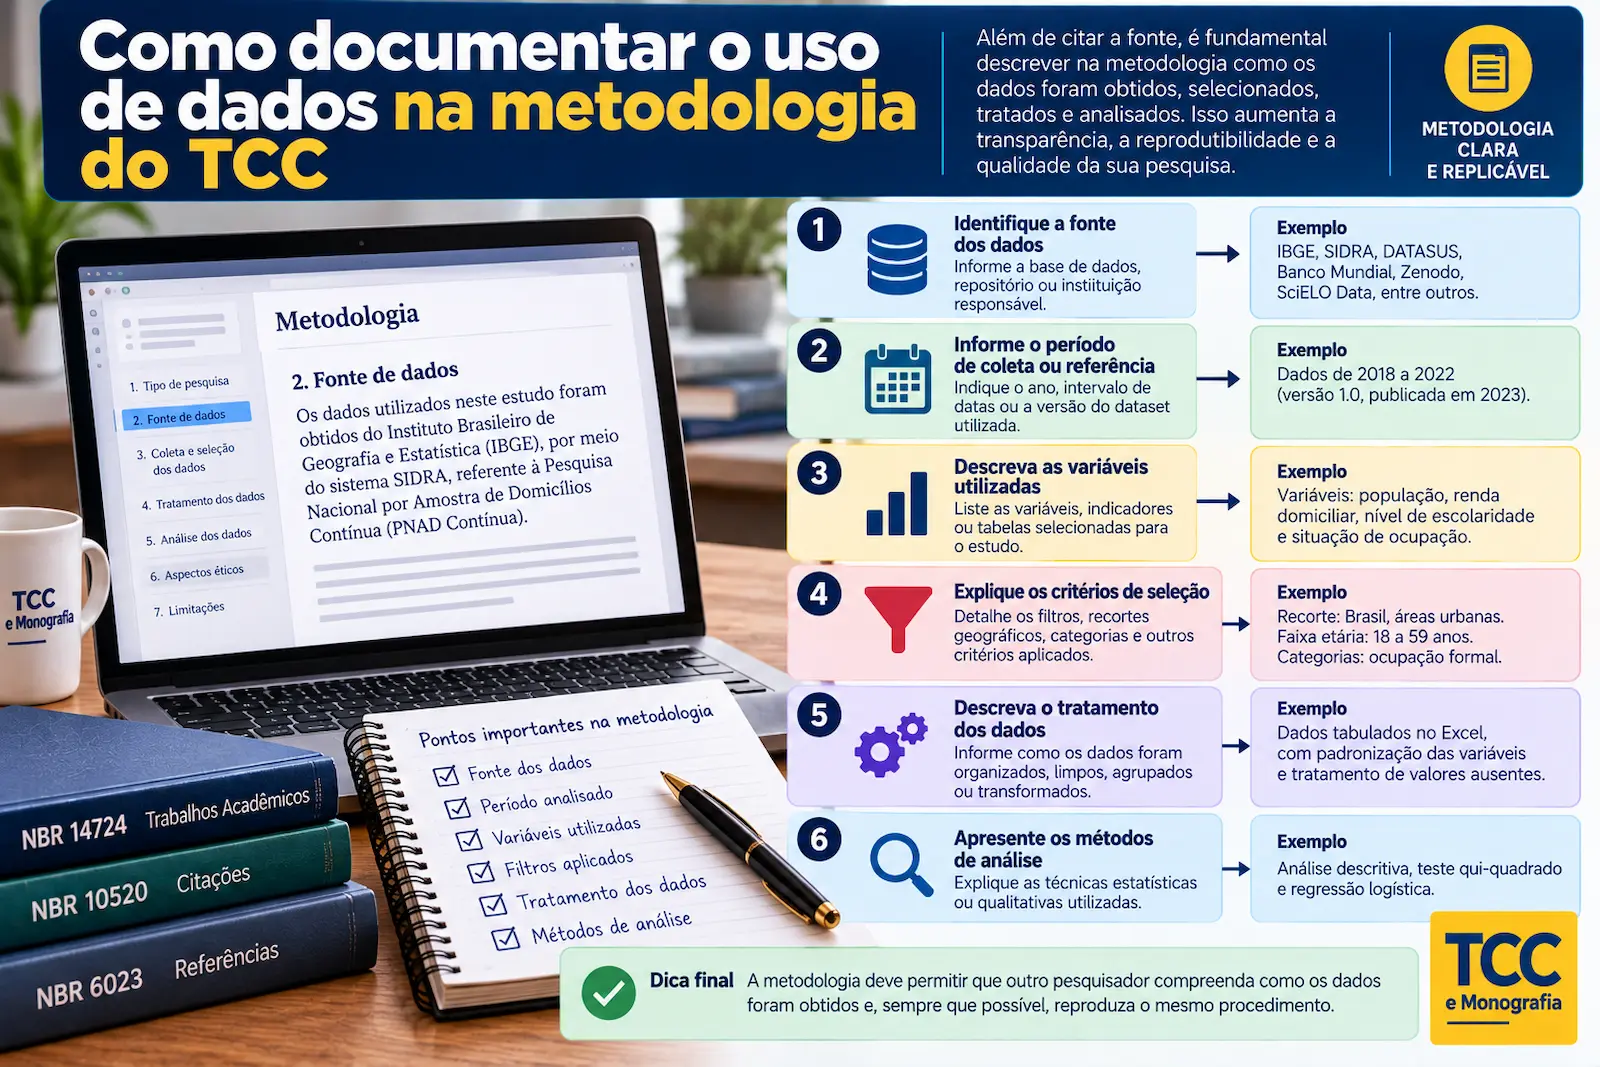
Como documentar o uso de dados na metodologia do TCC?
Independentemente de os dados terem vindo do IBGE, DATASUS, Banco Mundial, Kaggle, Zenodo, SciELO Data ou de uma API, a metodologia precisa explicar o percurso entre a fonte e o resultado.
Uma estrutura útil é:
fonte → obtenção → recorte → tratamento → análise → resultado.
1. Fonte
Qual base, dataset, sistema ou recurso forneceu os dados?
2. Obtenção
Como os registros foram obtidos?
- download;
- consulta;
- API;
- microdados;
- exportação;
- acesso controlado.
3. Recorte
Quais registros participaram da análise?
- período;
- território;
- população;
- categorias;
- variáveis;
- critérios de inclusão e exclusão.
4. Tratamento
O que aconteceu antes da análise?
- limpeza;
- remoção de duplicidades;
- tratamento de ausentes;
- recodificação;
- conversão de unidades;
- padronização;
- junção;
- criação de variáveis.
5. Análise
Quais procedimentos foram aplicados?
- estatística descritiva;
- testes;
- modelagem;
- classificação;
- análise temporal;
- análise espacial;
- outros métodos pertinentes.
6. Resultado
Quais tabelas, gráficos, indicadores ou conclusões foram produzidos a partir do processamento?
Exemplo de descrição metodológica de uso de dataset
Um modelo didático pode seguir esta lógica:
Foram utilizados dados provenientes de [fonte/dataset], correspondentes ao período de [período]. Foram selecionadas as variáveis [variáveis] e incluídos os registros que atenderam aos critérios [critérios]. Os dados foram obtidos em [data], processados em [software] e submetidos aos procedimentos de [tratamento/análise].
O modelo deve ser adaptado à pesquisa real.
Não inclua etapas que não foram realizadas apenas para tornar a metodologia aparentemente mais sofisticada.
Erro comum
Escrever uma metodologia genérica como “os dados foram coletados na internet e analisados no Excel”. Esse tipo de descrição pode omitir a fonte, o objeto, o recorte, os critérios e as transformações que realmente produziram o resultado.
Ficha prática para registrar um dataset durante a pesquisa
Uma ficha simples pode acompanhar cada fonte de dados:
| Campo | Registro |
|---|---|
| Responsável | [preencher] |
| Título | [preencher] |
| Data | [preencher] |
| Versão | [preencher] |
| DOI/identificador | [preencher] |
| Repositório/sistema | [preencher] |
| Data de extração | [preencher] |
| Arquivos | [preencher] |
| Período | [preencher] |
| Território/população | [preencher] |
| Variáveis | [preencher] |
| Filtros | [preencher] |
| Transformações | [preencher] |
| Software | [preencher] |
| Observações | [preencher] |
Essa ficha não precisa aparecer integralmente no TCC.
Ela funciona como instrumento de organização para que as informações necessárias não sejam perdidas durante o desenvolvimento da pesquisa.
O que é proveniência dos dados e por que ela importa?
Proveniência é, em termos práticos, a capacidade de reconstruir a origem e o percurso dos dados.
Em uma análise simples:
fonte → dataset → análise.
Em uma análise mais complexa:
fonte original → extração → limpeza → combinação → transformação → base analítica → resultado.
Quanto mais etapas existirem, maior é o risco de perder a conexão com a origem.
Por que isso importa para a citação?
Porque a referência precisa apontar para o objeto correto.
Se o pesquisador utiliza uma base derivada e esquece de onde vieram as variáveis originais, pode terminar atribuindo os dados ao arquivo final criado por ele próprio.
Por que isso importa para a metodologia?
Porque o leitor precisa compreender quais transformações ocorreram entre a fonte e o resultado.
Por que isso importa para tabelas e gráficos?
Porque “elaboração própria” não deve apagar a origem dos números.
Em resumo
Ao utilizar Banco Mundial, Kaggle, repositórios institucionais ou APIs, identifique a fonte real, preserve a proveniência e diferencie ambiente de hospedagem, mecanismo de acesso, arquivo e objeto de dados. Em tabelas e gráficos, reconheça a origem dos números. Na metodologia, registre o percurso entre a fonte e a base analisada.
Banco Mundial: identifique o indicador antes de citar a plataforma
O Banco Mundial disponibiliza uma grande quantidade de indicadores e séries estatísticas. Por isso, escrever apenas “dados do Banco Mundial” pode ser correto como identificação institucional geral, mas insuficiente para documentar com precisão aquilo que entrou na análise.
Antes de montar a referência ou redigir a metodologia, identifique:
- nome do indicador;
- código do indicador;
- país, território ou conjunto de países;
- período utilizado;
- unidade de medida;
- fonte indicada nos metadados;
- forma de obtenção;
- data de extração, quando pertinente.
O nome do portal não substitui o indicador
Considere dois pesquisadores que utilizam dados disponibilizados pelo Banco Mundial.
O primeiro analisa expectativa de vida.
O segundo analisa PIB per capita.
Embora ambos tenham obtido informações na mesma infraestrutura, os objetos estatísticos são diferentes.
Por isso, a documentação deve permitir reconhecer qual indicador foi utilizado.
O código do indicador ajuda a reduzir ambiguidades
Indicadores podem possuir nomes semelhantes ou traduções diferentes.
Quando existe um código oficial, registrá-lo na documentação do projeto ajuda a confirmar que o indicador analisado é exatamente aquele pretendido.
Uma ficha de pesquisa pode guardar:
Indicador: [nome oficial]
Código: [código]
Território: [país/região]
Período: [anos]
Data da extração: [data]
Nem todos esses elementos precisam necessariamente aparecer na mesma referência bibliográfica. Entretanto, devem permanecer recuperáveis na documentação metodológica.
Indicador e fonte primária podem ser diferentes
Um indicador disponibilizado pelo Banco Mundial pode incorporar dados provenientes de outras instituições ou processos estatísticos.
Por isso, examine os metadados antes de concluir que “Banco Mundial” descreve sozinho toda a cadeia de produção.
Dependendo do objetivo do trabalho, pode ser importante distinguir:
produtor ou fonte indicada → indicador → plataforma de disponibilização → extração do pesquisador.
Boa prática
Ao utilizar indicadores internacionais, salve junto ao projeto não apenas os valores, mas também os metadados do indicador. Eles ajudam a interpretar unidade, definição, cobertura, fonte e possíveis limitações.
Séries do Banco Mundial: cuidado com período, atualização e comparabilidade
Uma série histórica pode receber novos períodos e, em alguns casos, revisões de valores anteriores.
Isso significa que uma consulta realizada hoje pode não reproduzir exatamente uma extração feita meses atrás.
Registre o período realmente analisado
Se o trabalho utiliza dados de 2000 a 2025, documente esse recorte.
Não basta informar que o indicador possui uma série histórica extensa.
Registre a data da extração quando ela for metodologicamente relevante
Isso ajuda a situar o estado dos dados.
Considere:
Extração A, realizada em março → valores disponíveis naquele momento.
Extração B, realizada em setembro → série atualizada ou revisada.
Se a análise foi construída com a extração A, substituir silenciosamente os números pelos da extração B pode exigir recálculo dos resultados.
Não presuma comparabilidade apenas porque os valores aparecem na mesma série
Verifique documentação sobre:
- definição do indicador;
- unidade;
- mudanças metodológicas;
- estimativas;
- revisões;
- cobertura;
- lacunas temporais.
Essa avaliação pertence à qualidade metodológica da pesquisa e não pode ser resolvida apenas pela formatação bibliográfica.
Banco Mundial por API: como preservar a consulta realizada
Quando os dados são obtidos por API, a fonte continua sendo identificável, mas surge uma nova camada: a requisição utilizada para recuperar os registros.
Uma cadeia simplificada pode ser representada assim:
indicador → API → parâmetros → resposta → tratamento → base analítica.
Documente o indicador
Registre nome e código.
Documente os territórios
Uma consulta pode envolver:
- um país;
- vários países;
- regiões;
- agregados.
Documente o período
Registre os anos solicitados e não apenas os anos que permaneceram depois da limpeza.
Documente o formato da resposta quando relevante
A API pode fornecer dados em formatos estruturados, como JSON ou XML.
O formato não é a fonte, mas pode fazer parte da descrição técnica do processo.
Preserve o script quando possível
Se a consulta foi automatizada, o script pode registrar com precisão:
- endpoint;
- indicador;
- países;
- período;
- paginação;
- tratamento da resposta.
Isso pode ser mais confiável do que tentar reconstruir manualmente a consulta meses depois.
Na prática
Se uma API participa da coleta, preserve três coisas separadamente: a identificação da fonte, a configuração da consulta e o arquivo ou resposta efetivamente utilizado na análise.
Kaggle: a pergunta mais importante é “de onde vieram estes dados?”
O Kaggle é amplamente utilizado para compartilhar datasets, competições e projetos de ciência de dados.
Para fins acadêmicos, porém, encontrar um conjunto na plataforma não encerra a investigação bibliográfica.
É necessário descobrir a proveniência.
Cenário 1 — O próprio produtor publica os dados
Uma organização ou pesquisador pode utilizar o Kaggle para disponibilizar um conjunto que produziu.
Nesse caso, o perfil que publica e a responsabilidade pelos dados podem estar relacionados.
Ainda assim, confira os metadados e a descrição.
Cenário 2 — Um usuário republica dados de uma instituição
Um perfil pode copiar para o Kaggle dados originalmente produzidos por:
- órgão governamental;
- organização internacional;
- universidade;
- empresa;
- projeto científico.
Nesse cenário, tratar automaticamente o usuário do Kaggle como produtor original pode apagar a verdadeira proveniência.
Cenário 3 — O conjunto foi transformado
O publicador pode ter:
- limpado os dados;
- eliminado variáveis;
- corrigido registros;
- combinado fontes;
- criado rótulos;
- normalizado valores;
- produzido novas variáveis.
Nesse caso, existem pelo menos duas camadas relevantes:
fonte original → transformação do publicador → dataset disponibilizado no Kaggle.
Se você utiliza o conjunto transformado, ignorar completamente a contribuição intermediária também pode distorcer a proveniência.
Cenário 4 — A fonte original não está clara
Esse é um sinal para interromper a montagem da referência e investigar.
Procure:
- descrição do dataset;
- links para a origem;
- README;
- documentação;
- licença;
- discussões do projeto;
- artigos associados.
Se a proveniência continuar incerta, essa limitação deve pesar na avaliação da adequação da fonte para a pesquisa.
Atenção
O fato de um dataset estar disponível no Kaggle não demonstra, por si só, quem produziu os registros, se o conjunto é uma cópia fiel da fonte original ou quais transformações ocorreram.
Versões e arquivos no Kaggle: registre o que realmente entrou na análise
Datasets disponibilizados em plataformas podem ser atualizados.
Por isso, registre:
- nome do conjunto;
- responsável apresentado;
- versão ou estado, quando disponível;
- arquivos utilizados;
- data de obtenção;
- fonte original declarada;
- transformações informadas pelo publicador.
Não trate a página atual como prova do estado antigo
Se você baixou o dataset meses atrás e ele foi atualizado posteriormente, a página atual pode não representar exatamente os arquivos analisados.
Preservar os arquivos originais utilizados ajuda a manter a correspondência.
O nome do arquivo pode ser útil metodologicamente
Se um dataset contém cinco arquivos e apenas um foi analisado, registre esse fato.
Isso não significa necessariamente transformar o nome do arquivo em título bibliográfico.
Como documentar um dataset do Kaggle derivado de outra fonte?
Considere um exemplo hipotético.
Um usuário baixa dados públicos de três instituições, combina os arquivos, remove registros incompletos, cria uma variável de classificação e publica o resultado no Kaggle.
Se você reutiliza esse dataset, sua proveniência possui várias etapas:
fontes originais → processamento do publicador → dataset derivado → sua análise.
Dependendo do papel de cada objeto, pode ser necessário reconhecer:
- o dataset derivado efetivamente utilizado;
- as fontes originais relevantes;
- a metodologia ou documentação da transformação.
Não existe benefício em fingir que você baixou diretamente das fontes originais se, na realidade, trabalhou com uma versão intermediária transformada.
Visão do especialista
Proveniência não é escolher a fonte “mais prestigiosa” para colocar na referência. É documentar honestamente o caminho pelo qual os dados chegaram à sua análise.
Repositórios institucionais: como identificar corretamente o dataset
Universidades, centros de pesquisa e instituições podem manter seus próprios repositórios.
Esses ambientes frequentemente utilizam identificadores persistentes e metadados estruturados.
Ao encontrar um dataset em um repositório institucional, registre:
- criadores;
- título;
- data;
- versão;
- instituição;
- coleção;
- identificador persistente;
- arquivos;
- licença;
- documentação relacionada.
Universidade que hospeda não é necessariamente autora
Um pesquisador pode depositar dados no repositório de sua universidade.
A instituição pode:
- hospedar;
- preservar;
- administrar o sistema;
- fornecer o identificador.
Isso não significa automaticamente que ela substitua os criadores como responsabilidade principal do dataset.
Handle e outros identificadores institucionais
Quando o repositório oferece um endereço persistente, prefira-o a uma URL interna instável, especialmente se esta depender da estrutura momentânea do sistema.
Collection, community e folder não são necessariamente parte do título
Repositórios podem organizar objetos em hierarquias.
Essas categorias ajudam na navegação, mas não devem ser incorporadas automaticamente ao título bibliográfico.
Dataverse, Figshare, Dryad e OSF: o princípio continua o mesmo
Apesar das diferenças entre plataformas, o raciocínio fundamental permanece:
- identifique o objeto;
- identifique os responsáveis;
- registre o título;
- verifique versão ou estado;
- localize identificadores;
- registre os arquivos utilizados;
- confira documentação e licença;
- preserve a relação com artigos ou projetos associados.
Não copie a citação automática sem conferir
Uma citação gerada automaticamente pelo repositório pode ser extremamente útil.
Mas antes de utilizá-la:
- confirme os nomes;
- confirme o título;
- confirme a versão;
- confirme o DOI;
- confirme se o objeto é realmente o dataset utilizado;
- adapte a apresentação ao padrão exigido no trabalho.
O estilo exportado pelo repositório pode não ser o estilo adotado pela instituição
Um sistema pode oferecer exportação em estilos internacionais ou formatos de gerenciamento bibliográfico.
Isso não significa que a saída esteja automaticamente pronta para ser inserida sem revisão em um trabalho que segue padrões ABNT e regras institucionais específicas.
API não é sinônimo de fonte: entenda as camadas
Uma API é uma interface por meio da qual sistemas podem trocar ou fornecer informações de maneira estruturada.
Quando um pesquisador utiliza uma API para coletar dados, existem pelo menos três perguntas diferentes:
- Quem produz ou responde pelos dados?
- Qual API ou serviço foi utilizado para obtê-los?
- Qual consulta foi executada?
Essas perguntas não devem ser comprimidas em uma única informação.
Exemplo conceitual
Instituição responsável → base de dados → API → endpoint → parâmetros → resposta → script → base analítica.
Cada etapa exerce uma função.
A referência pode identificar a fonte ou recurso.
A metodologia pode documentar a requisição e o tratamento.
O script pode preservar detalhes técnicos suficientes para repetição.
Endpoint e parâmetros: quanto detalhe documentar?
Uma consulta de API pode depender de parâmetros como:
- variável;
- indicador;
- território;
- período;
- categoria;
- idioma;
- formato;
- ordenação;
- limite de registros;
- página.
Se um parâmetro altera quais registros são recuperados, ele pode ser metodologicamente relevante.
Parâmetros que alteram o conteúdo
Por exemplo:
country=BR;year=2025;indicator=XYZ.
Esses parâmetros definem o recorte.
Parâmetros predominantemente técnicos
Outros podem alterar apenas:
- formato de resposta;
- quantidade por página;
- ordenação;
- idioma da interface.
Eles ainda podem ser importantes para o script, mas nem sempre precisam ocupar espaço no corpo do TCC.
Boa prática
Documente integralmente a consulta no script ou arquivo técnico e leve para a metodologia os parâmetros necessários para compreender o recorte e reproduzir a obtenção dos dados.
Paginação de API: um detalhe técnico que pode alterar o dataset
APIs frequentemente limitam a quantidade de registros retornados por resposta.
Imagine que uma consulta tenha 50.000 registros, mas cada resposta entregue apenas 1.000.
Se o script baixar somente a primeira página, a análise trabalhará com apenas uma fração do conjunto.
Como perceber a paginação?
Procure na documentação campos como:
- page;
- page number;
- per_page;
- limit;
- offset;
- next;
- cursor;
- total pages;
- total records.
Documente como a paginação foi tratada
Se o script percorreu todas as páginas, isso pode ser registrado metodologicamente de forma concisa.
Exemplo estrutural:
Os registros foram obtidos por API, com paginação automatizada até a recuperação integral das observações correspondentes aos parâmetros definidos.
Não copie essa frase mecanicamente. Adapte-a ao procedimento realmente realizado.
Erro comum
Presumir que uma resposta HTTP bem-sucedida significa que todos os registros foram recuperados. Uma API pode retornar corretamente apenas a primeira página.
APIs e dados dinâmicos: a mesma requisição pode retornar valores diferentes
Uma requisição reproduzida meses depois pode retornar dados atualizados.
Isso ocorre quando a base subjacente:
- recebe novos registros;
- corrige registros antigos;
- altera classificações;
- reprocessa informações.
Portanto, preservar apenas o código da consulta pode não ser suficiente para reconstruir o estado analisado.
Preserve a resposta bruta quando permitido
Uma estratégia útil pode ser manter:
- arquivo JSON original;
- CSV exportado;
- snapshot;
- registro da data e horário;
- hash do arquivo, em projetos que necessitam controle mais rigoroso.
Essas medidas pertencem a boas práticas de rastreabilidade e não devem ser apresentadas como requisitos universais da ABNT.
Data e horário
Em muitas bases, registrar apenas a data é suficiente.
Em sistemas atualizados continuamente, o horário pode se tornar relevante.
O nível de precisão deve ser proporcional ao comportamento da fonte.
JSON, XML e CSV retornados por API: o formato não substitui a fonte
É comum encontrar frases como:
“Os dados foram retirados de um arquivo JSON.”
Essa informação descreve o formato, mas não a origem.
Uma descrição metodológica mais informativa distingue:
- fonte;
- API;
- consulta;
- formato;
- tratamento.
Por exemplo, conceitualmente:
Fonte institucional → API → resposta JSON → conversão → base analítica.
APIs com autenticação: documente o método, não exponha credenciais
Algumas APIs exigem:
- API key;
- token;
- OAuth;
- login institucional;
- credenciais específicas.
Essas informações exigem cuidado.
Nunca publique a chave apenas para tornar o método “reproduzível”
Credenciais podem:
- dar acesso à conta;
- gerar custos;
- permitir alterações;
- violar termos de uso;
- expor dados protegidos.
A metodologia pode informar que a API exigia autenticação sem revelar o segredo.
Scripts compartilhados podem utilizar variáveis de ambiente ou arquivos de configuração excluídos do material público.
Limites, falhas e respostas incompletas de APIs
APIs podem impor:
- limite de requisições;
- limite de registros;
- timeouts;
- restrições de período;
- limites de tamanho;
- bloqueios temporários.
Se esses fatores afetaram a coleta, registre o procedimento adotado.
Uma resposta vazia não significa necessariamente ausência de dados
Pode indicar:
- parâmetro incorreto;
- falha temporária;
- limitação da API;
- erro de autenticação;
- problema de paginação.
Valide a quantidade de registros recuperados antes de iniciar a análise.
Como validar uma extração feita por API?
Antes de considerar a coleta concluída, verifique:
- quantos registros eram esperados;
- quantos foram obtidos;
- se todas as páginas foram processadas;
- se o período está correto;
- se os territórios estão corretos;
- se as variáveis correspondem às pretendidas;
- se existem duplicidades inesperadas;
- se existem campos vazios inesperados;
- se a documentação confirma o significado dos códigos;
- se o arquivo bruto foi preservado.
Essa validação evita que um erro de coleta seja confundido posteriormente com um resultado científico.
Como descrever dados obtidos por API na metodologia?
Uma descrição metodológica pode ser organizada em cinco componentes.
1. Fonte
Identifique a instituição e o recurso de dados.
2. Mecanismo de obtenção
Informe que a coleta foi realizada por API.
3. Recorte
Registre os parâmetros analiticamente relevantes.
4. Extração
Informe quando ocorreu e, quando necessário, como a paginação foi tratada.
5. Processamento
Explique as transformações realizadas depois da resposta.
Um modelo estrutural — que deve ser adaptado ao procedimento real — seria:
Os dados foram obtidos por meio da API disponibilizada por [instituição], utilizando o recurso [identificação]. A consulta contemplou [territórios/período/variáveis], com extração realizada em [data]. As respostas foram recuperadas em [formato] e posteriormente submetidas a [tratamentos relevantes] antes da composição da base analítica.
Não utilize o modelo se ele não representar o que realmente foi feito.
O script de coleta substitui a descrição metodológica?
Não necessariamente.
Um script pode conter detalhes técnicos excelentes, mas o leitor não deveria precisar interpretar todo o código para compreender o desenho básico da coleta.
A metodologia apresenta o processo em linguagem acadêmica.
O script preserva detalhes operacionais.
Quando ambos estão disponíveis, eles podem se complementar.
| Metodologia | Script |
|---|---|
| Explica a fonte | Implementa a consulta |
| Explica o recorte | Registra parâmetros |
| Explica o tratamento | Executa transformações |
| É legível para o leitor acadêmico | Permite inspeção técnica |
| Resume decisões relevantes | Preserva detalhes operacionais |
A cadeia completa de proveniência em uma pesquisa com API
Em trabalhos mais complexos, uma sequência como esta pode ser útil para auditar o processo:
instituição → sistema → recurso → API → endpoint → parâmetros → extração → resposta bruta → limpeza → transformação → base analítica → análise → resultado.
Não é necessário reproduzir essa cadeia literalmente no texto final.
Ela funciona como ferramenta de auditoria.
Teste da cadeia
Pergunte:
- Sei quem responde pelos dados?
- Sei qual recurso consultei?
- Sei como os registros foram obtidos?
- Sei quais parâmetros definiram o recorte?
- Sei quando ocorreu a extração?
- Preservei a resposta original?
- Sei quais transformações foram realizadas?
- Consigo ligar a base analítica à extração?
- Consigo ligar os resultados à base analítica?
Quanto mais respostas forem positivas e documentadas, menor é o risco de perda de proveniência.
Tabelas e gráficos produzidos a partir de API
Uma tabela criada automaticamente por script continua tendo uma fonte de dados.
O fato de o pesquisador ter programado a coleta, o processamento e a visualização não transforma os registros externos em dados originalmente produzidos por ele.
Por isso, preserve a distinção entre:
- fonte dos dados;
- processamento;
- elaboração da visualização.
Uma formulação estrutural possível é:
Fonte: elaboração própria a partir de dados de [fonte], obtidos por API.
Adapte-a às regras institucionais e à necessidade de detalhamento do trabalho.
Ficha prática para documentar uma fonte obtida por API
| Campo | Registro |
|---|---|
| Instituição responsável | [preencher] |
| Base/recurso | [preencher] |
| API | [preencher] |
| Versão da API | [preencher] |
| Endpoint | [preencher] |
| Indicador/variável | [preencher] |
| Território | [preencher] |
| Período | [preencher] |
| Outros parâmetros | [preencher] |
| Paginação | [preencher] |
| Data da extração | [preencher] |
| Horário, se relevante | [preencher] |
| Formato da resposta | [preencher] |
| Arquivo bruto preservado | [sim/não/localização] |
| Quantidade de registros | [preencher] |
| Script utilizado | [preencher] |
| Tratamentos | [preencher] |
| Observações | [preencher] |
A ficha é um instrumento de trabalho. Ela não precisa ser transferida integralmente para o texto final.
Teste final: Banco Mundial, Kaggle, repositórios e APIs
Antes de seguir para a análise dos dados, verifique:
- Identifiquei o recurso específico, e não apenas a plataforma?
- Se é um indicador, registrei nome e código?
- Se é um dataset do Kaggle, investiguei a fonte original?
- Se houve transformação por terceiros, preservei essa etapa?
- Se é um repositório institucional, distingui autores e instituição hospedeira?
- Conferi a citação automática antes de utilizá-la?
- Se usei API, registrei endpoint e parâmetros relevantes?
- Tratei corretamente a paginação?
- Registrei a data da extração?
- Preservei a resposta bruta quando pertinente e permitido?
- Validei a quantidade de registros?
- Documentei as transformações?
- Minha referência identifica a fonte?
- Minha metodologia explica a consulta?
- Meus resultados podem ser rastreados até os dados obtidos?
Em resumo
Banco Mundial, Kaggle, repositórios científicos e APIs apresentam desafios diferentes, mas a lógica permanece consistente: identifique quem responde pelos dados, qual objeto foi utilizado, onde ele foi disponibilizado, como foi obtido e o que aconteceu depois da obtenção. Em uma API, a cadeia pode chegar a fonte → recurso → consulta → resposta → processamento → resultado. Em um dataset derivado, preserve também as etapas intermediárias de proveniência.
Como citar dataset atualizado continuamente?
Nem todo conjunto de dados permanece estático depois de publicado.
Algumas bases são atualizadas:
- diariamente;
- semanalmente;
- mensalmente;
- anualmente;
- sempre que novos registros são incorporados;
- quando erros são identificados;
- quando a metodologia é revisada.
Nesses casos, simplesmente informar o nome da base pode não ser suficiente para permitir que outra pessoa compreenda qual estado dos dados participou da pesquisa.
Por que uma base dinâmica exige atenção adicional?
Imagine que um estudante obtenha determinada série em março.
Em setembro, antes da entrega do TCC, a instituição responsável:
- acrescenta novos meses;
- corrige registros antigos;
- altera valores preliminares;
- revisa a metodologia.
Uma nova consulta pode produzir resultados diferentes.
Por isso, a documentação precisa responder:
qual estado dos dados foi efetivamente utilizado para produzir os resultados apresentados?
O que registrar em uma base dinâmica?
Dependendo da natureza da fonte, registre:
- data da extração;
- horário, quando materialmente relevante;
- versão, se houver;
- release;
- período coberto;
- parâmetros;
- filtros;
- arquivos baixados;
- snapshot, quando disponível e pertinente;
- documentação metodológica vigente naquele momento.
Data de acesso resolve tudo?
Não necessariamente.
A data de acesso indica quando determinado recurso foi consultado.
A data de extração indica quando os dados efetivamente analisados foram obtidos.
Em algumas situações elas coincidem. Em outras, não.
Se a base é dinâmica, essa distinção pode ser importante para a reprodutibilidade.
Boa prática
Quando trabalhar com uma base que muda continuamente, preserve o arquivo bruto obtido na extração sempre que isso for permitido e metodologicamente apropriado. Dessa forma, a análise não dependerá de a plataforma continuar apresentando exatamente os mesmos valores no futuro.
Qual versão do dataset deve ser citada?
A regra prática é simples:
identifique a versão que efetivamente participou da análise.
Isso evita um problema comum: atualizar a referência bibliográfica sem atualizar a análise.
Por que a versão mais recente nem sempre é a correta?
Porque o objetivo da referência não é demonstrar que você conhece a versão mais nova.
O objetivo é identificar o objeto relacionado aos resultados apresentados.
Se os cálculos foram feitos com a versão 1.4, citar a versão 2.0 pode sugerir que seus resultados foram produzidos com dados diferentes.
O que pode mudar entre versões?
- quantidade de registros;
- valores;
- variáveis;
- nomes de campos;
- categorias;
- codificação;
- documentação;
- arquivos;
- licença;
- tratamento de erros.
E se a versão nova corrigir um erro?
Nesse caso, avalie a materialidade da correção.
Pergunte:
- o erro afeta alguma variável utilizada?
- afeta registros incluídos na análise?
- altera tabelas ou gráficos?
- altera estimativas?
- pode alterar conclusões?
Se a resposta for positiva, talvez seja necessário refazer parte da análise.
Simplesmente trocar o número da versão na referência não resolve a inconsistência.
E se a atualização não alterar os dados utilizados?
Registre o estado efetivamente analisado e, se necessário, explique a situação.
O princípio continua sendo a correspondência entre:
dados analisados → versão identificada → resultados apresentados.
O que fazer quando o dataset não informa versão?
Não invente uma.
Em vez disso, procure outros elementos capazes de situar o estado utilizado:
- data de publicação;
- data de atualização;
- data de extração;
- release;
- nome do arquivo;
- identificador;
- commit;
- snapshot;
- registro do repositório.
A ausência de um campo chamado “versão” não significa que o conjunto seja impossível de documentar.
Atenção
Versionamento explícito é excelente para rastreabilidade, mas não deve ser inventado para tornar a referência aparentemente mais completa.
Como documentar um dataset sem DOI?
Como vimos anteriormente, DOI é apenas uma das formas possíveis de identificação persistente.
Um conjunto sem DOI pode continuar sendo perfeitamente identificável por meio de:
- Handle;
- ARK;
- identificador institucional;
- código do recurso;
- número da tabela;
- código do indicador;
- landing page oficial;
- URL persistente;
- nome e versão claramente definidos.
Ausência de DOI significa baixa qualidade?
Não.
Qualidade e identificação persistente são dimensões diferentes.
Uma base estatística oficial pode não possuir DOI para cada tabela e ainda ser altamente relevante para determinada pesquisa.
Por outro lado, a existência de DOI não garante automaticamente que um dataset seja adequado ao problema estudado.
O que avaliar além do identificador?
- origem;
- responsabilidade;
- metodologia;
- cobertura;
- documentação;
- consistência;
- atualização;
- limitações;
- adequação à pergunta de pesquisa.
Dados públicos precisam ser citados?
Sim, quando exercem função de fonte no trabalho.
O fato de os dados estarem disponíveis publicamente não elimina a necessidade de reconhecer sua origem.
Isso vale para dados provenientes de:
- órgãos governamentais;
- institutos de estatística;
- portais de transparência;
- organizações internacionais;
- repositórios abertos;
- projetos de ciência aberta.
Público significa sem autoria?
Não.
Dados públicos podem possuir:
- responsabilidade institucional;
- metodologia;
- licença;
- versão;
- documentação;
- condições de reutilização.
Gratuito significa livre de qualquer condição?
Também não necessariamente.
A possibilidade de acessar gratuitamente um conjunto e as condições jurídicas ou institucionais de sua reutilização são questões diferentes.
Consulte as informações de licença e uso quando forem relevantes.
Por que citar dados públicos?
A citação permite:
- atribuir a fonte;
- localizar os dados;
- avaliar a metodologia de produção;
- verificar resultados;
- distinguir dados externos de cálculos realizados pelo pesquisador.
Erro comum
“Como os dados são públicos, não preciso citar.” A publicidade do recurso facilita o acesso; ela não apaga sua proveniência.
Como citar dados coletados pelo próprio pesquisador?
Nem toda pesquisa utiliza datasets produzidos por terceiros.
O estudante pode gerar seus próprios dados por meio de:
- questionários;
- entrevistas;
- experimentos;
- observações;
- medições;
- registros de campo;
- coleta automatizada;
- instrumentos laboratoriais.
Nesses casos, a documentação funciona de maneira diferente.
Dados próprios não publicados
Se os dados existem apenas como material interno da pesquisa, não é necessário criar artificialmente uma referência bibliográfica para uma planilha particular.
O foco principal estará na metodologia.
Ela deve explicar, conforme o desenho do estudo:
- como ocorreu a coleta;
- quem ou o que compôs a população;
- como a amostra foi definida;
- qual instrumento foi utilizado;
- quando os dados foram coletados;
- quais critérios foram aplicados;
- como os registros foram tratados;
- como foram analisados;
- quais procedimentos éticos foram observados.
Preciso escrever “Fonte: dados da pesquisa”?
Dependendo da natureza da tabela, gráfico e das regras institucionais, uma indicação que deixe clara a origem autoral dos dados pode ser utilizada.
O ponto principal é não criar uma falsa fonte externa quando os registros foram produzidos pelo próprio estudo.
Dados próprios publicados em repositório
A situação muda quando o pesquisador deposita os dados em um repositório e o conjunto passa a possuir:
- título;
- criadores;
- data;
- versão;
- metadados;
- página persistente;
- DOI ou outro identificador.
Nesse cenário, o dataset passa a ter identidade própria como produto de pesquisa e pode ser citado como tal.
A publicação do dataset substitui a metodologia?
Não.
O depósito ajuda a preservar e identificar os dados, mas o TCC continua precisando explicar como eles foram produzidos e analisados.
Como citar dados restritos, confidenciais ou sensíveis?
Nem todo dataset pode ser disponibilizado publicamente.
Restrições podem existir por razões:
- éticas;
- legais;
- contratuais;
- institucionais;
- de privacidade;
- de confidencialidade;
- de segurança.
A impossibilidade de abrir os registros não significa necessariamente que sua origem deva desaparecer do trabalho.
Dados restritos podem ter metadados públicos?
Sim.
Em alguns casos, o conteúdo é controlado, mas existe uma página pública com:
- título;
- responsáveis;
- descrição;
- instituição;
- identificador;
- condições de acesso.
Esses metadados podem permitir que o conjunto seja identificado sem expor os registros protegidos.
O que explicar na metodologia?
Dentro dos limites permitidos, informe:
- origem;
- natureza dos dados;
- forma de acesso;
- autorização;
- restrições;
- procedimentos de proteção;
- tratamento analítico.
Não publique credenciais ou caminhos privados
Reprodutibilidade não significa divulgar:
- senhas;
- tokens;
- chaves de API privadas;
- URLs protegidas;
- dados pessoais;
- informações confidenciais.
Atenção
A transparência científica deve ser compatível com as obrigações éticas, legais, contratuais e institucionais da pesquisa. Não exponha dados protegidos apenas para tornar a documentação aparentemente mais completa.
Dados anonimizados deixam de exigir documentação da fonte?
Não automaticamente.
A anonimização altera a forma como determinados registros podem ser tratados e compartilhados, mas não elimina a necessidade de explicar sua origem e seu papel na pesquisa.
Se um dataset anonimizado foi produzido por uma instituição ou estudo anterior, sua proveniência continua relevante.
Se a anonimização foi realizada pelo próprio pesquisador, esse procedimento também pode precisar ser descrito na metodologia.
Devo citar o dataset ou o artigo que descreve os dados?
Essa é uma das dúvidas mais importantes na reutilização de dados científicos.
Dataset e artigo são objetos diferentes.
O artigo pode explicar:
- por que o estudo foi realizado;
- como os dados foram coletados;
- quais análises foram realizadas;
- quais resultados foram encontrados;
- como os autores interpretaram esses resultados.
O dataset, por outro lado, representa os dados disponibilizados para análise ou reutilização.
Quando citar o dataset?
Cite o dataset quando ele foi efetivamente:
- baixado;
- consultado;
- reutilizado;
- reanalisado;
- combinado;
- transformado;
- utilizado como material da pesquisa.
Quando citar o artigo?
Cite o artigo quando ele sustentar:
- afirmações;
- conceitos;
- interpretações;
- metodologia;
- resultados;
- discussões científicas.
Quando citar os dois?
Se você reutilizou os dados e também utilizou o artigo para compreender sua produção ou fundamentar afirmações, os dois podem precisar aparecer.
Isso preserva funções diferentes:
| Objeto | Função |
|---|---|
| Dataset | Identificar os dados reutilizados |
| Artigo | Identificar a publicação científica utilizada |
O DOI do artigo pode substituir o DOI do dataset?
Não automaticamente.
Se os dois objetos possuem DOIs diferentes, cada identificador representa seu respectivo objeto.
Não transfira o DOI de um artigo para o dataset apenas porque eles estão relacionados.
Erro comum
Baixar um dataset, realizar uma nova análise e citar apenas o artigo associado, mesmo quando o conjunto possui registro e identificador próprios. Isso pode dificultar a identificação dos dados efetivamente reutilizados.
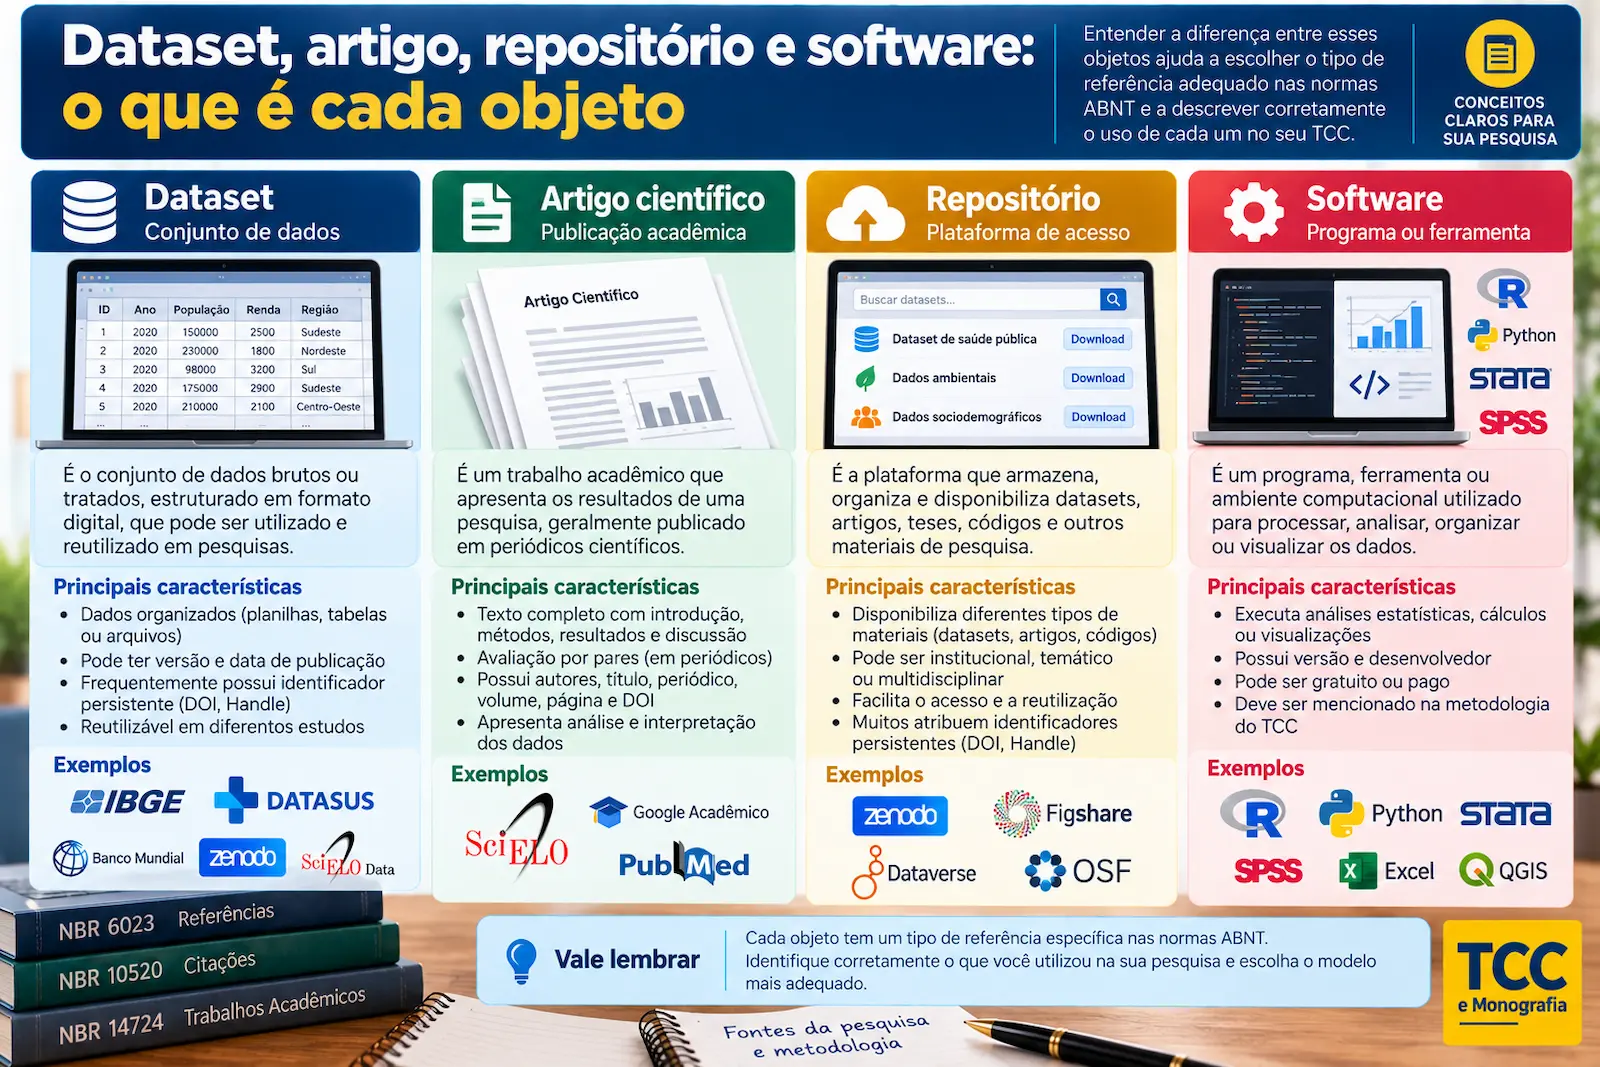
Dataset, software, repositório e artigo: qual é a diferença?
Uma pesquisa contemporânea pode envolver simultaneamente vários objetos digitais.
Imagine este fluxo:
artigo → dataset no repositório → arquivo CSV → script em R → tabela produzida no TCC.
Cada componente exerce uma função.
| Objeto | Função típica |
|---|---|
| Dataset | Fornecer os dados |
| Repositório | Hospedar, preservar e disponibilizar o dataset |
| Artigo | Comunicar método, resultados e discussão científica |
| Software | Processar ou analisar os dados |
| Arquivo | Armazenar parte ou todo o conjunto |
| Script | Executar etapas computacionais |
| Tabela/gráfico | Comunicar resultados |
Citar o software substitui a citação dos dados?
Não.
Dizer que a análise foi realizada no R, Python, SPSS, Stata ou outro programa não informa de onde vieram os dados.
Citar o dataset substitui a citação do software?
Também não necessariamente.
Se o software é relevante para a reprodutibilidade, metodologia ou atribuição, ele pode precisar ser identificado separadamente.
Para aprofundar esse tema, consulte Como Citar Software nas Normas ABNT.
Citar o repositório substitui o dataset?
Não automaticamente.
Dizer apenas “Zenodo”, “SciELO Data” ou “Dataverse” pode identificar o ambiente, mas não o conjunto específico utilizado.
Citar o artigo substitui o dataset?
Não quando o objetivo é identificar os dados efetivamente reutilizados e o dataset possui identidade própria relevante.
Como descobrir qual objeto precisa ser citado?
Use uma sequência de perguntas.
- Eu utilizei informações escritas em um artigo?
- Eu reutilizei os dados disponibilizados separadamente?
- Eu utilizei um software para processar esses dados?
- O conjunto está hospedado em um repositório?
- Eu utilizei apenas um arquivo específico?
- O arquivo possui identidade própria?
- O dataset possui DOI ou outro identificador?
- Existe versão específica?
- Meu resultado depende dessa versão?
As respostas ajudam a separar os objetos.
Visão do especialista
Não pergunte apenas “quantas referências preciso fazer?”. Pergunte quais objetos desempenharam funções intelectuais, metodológicas ou materiais relevantes no trabalho. A documentação deve refletir essas funções sem multiplicar referências artificialmente.
Como descrever o dataset na metodologia do TCC?
A metodologia precisa permitir que o leitor compreenda como os dados entraram na pesquisa.
Uma descrição completa pode envolver quatro grupos de informação.
1. Identificação da fonte
Informe:
- instituição ou responsáveis;
- dataset, sistema ou pesquisa;
- versão ou estado, quando pertinente;
- forma de acesso.
2. Obtenção dos dados
Explique:
- download;
- API;
- consulta;
- acesso controlado;
- coleta própria;
- outro procedimento.
3. Recorte
Defina:
- período;
- território;
- população;
- unidade de análise;
- variáveis;
- critérios de inclusão;
- critérios de exclusão.
4. Tratamento e análise
Descreva, conforme necessário:
- limpeza;
- duplicidades;
- ausentes;
- recodificação;
- junção;
- transformação;
- cálculos;
- software;
- procedimentos analíticos.
Modelo didático
Foram utilizados dados de [fonte/dataset], referentes a [período/população]. Os registros foram obtidos por [procedimento] em [data, quando pertinente]. Foram selecionadas as variáveis [variáveis] e aplicados os critérios [critérios]. Posteriormente, os dados foram submetidos aos procedimentos de [tratamento] e analisados por meio de [método/software].
O modelo deve representar o que realmente foi feito.
Por que a referência do dataset não substitui a metodologia?
Porque a referência identifica o recurso, mas normalmente não descreve o percurso analítico.
Considere um dataset com:
- 10 milhões de registros;
- 20 anos de observações;
- 300 variáveis;
- cobertura nacional.
O TCC pode utilizar apenas:
- 20 mil registros;
- 3 anos;
- 8 variáveis;
- uma região.
A referência do conjunto não explica esse recorte.
A metodologia precisa fazê-lo.
O mesmo dataset pode produzir pesquisas completamente diferentes
Dois estudantes podem utilizar a mesma fonte e chegar a resultados diferentes porque selecionaram:
- períodos diferentes;
- populações diferentes;
- variáveis diferentes;
- tratamentos diferentes;
- modelos diferentes.
Isso mostra por que:
referência correta não é sinônimo de metodologia completa.
A metodologia pode substituir a referência?
Também não.
Uma metodologia pode dizer:
“Foram analisados dados de mortalidade do período de 2015 a 2025.”
Mas, se não identifica adequadamente a fonte, o leitor pode não saber:
- qual sistema foi utilizado;
- qual instituição responde pelos dados;
- onde o recurso pode ser localizado;
- qual versão ou estado foi utilizado.
As duas camadas são complementares.
As três camadas essenciais da documentação de dados
| Camada | Pergunta respondida |
|---|---|
| Referência | Qual é o objeto? |
| Citação | De onde vem esta informação? |
| Metodologia | Como os dados foram utilizados? |
Em tabelas e gráficos, uma quarta camada pode ser acrescentada:
Qual é a origem dos números apresentados neste elemento?
Essa pergunta é respondida pela indicação de fonte apropriada.
Como construir uma cadeia de rastreabilidade dos dados?
Uma cadeia de rastreabilidade conecta a origem aos resultados.
Ela pode ser representada assim:
fonte → objeto de dados → versão ou estado → recorte → tratamento → análise → resultado.
Para uma pesquisa com API:
fonte → API → parâmetros → resposta → limpeza → base analítica → resultado.
Para bases combinadas:
fonte A + fonte B → harmonização → integração → base derivada → análise → resultado.
Para dados próprios:
coleta → dados brutos → tratamento → base analítica → análise → resultado.
Por que desenhar essa cadeia?
Porque ela ajuda a descobrir onde a documentação está incompleta.
Se você não consegue responder o que aconteceu entre duas etapas, provavelmente existe uma lacuna metodológica.
Em resumo
Datasets dinâmicos exigem atenção ao estado dos dados; versões devem corresponder ao material efetivamente analisado; DOI não é condição universal de validade; dados públicos continuam tendo proveniência; dados próprios precisam de documentação metodológica; dados restritos podem ser identificados sem exposição indevida; e dataset, artigo, repositório, software e arquivo são objetos diferentes. Em todos os casos, preserve a cadeia entre a fonte e o resultado.
Datasets dinâmicos: como preservar a identidade de dados que mudam ao longo do tempo?
Nem toda base de dados representa um conjunto estável de registros. Muitas fontes são continuamente atualizadas, corrigidas ou ampliadas, o que cria dificuldades adicionais para a identificação bibliográfica e para a reprodutibilidade das análises.
Esse cenário é comum em sistemas de informação em saúde, bases econômicas, plataformas estatísticas, registros administrativos, indicadores internacionais e serviços de dados acessados por API.
O problema central não está apenas em saber como escrever a referência. É necessário determinar qual estado dos dados efetivamente participou da pesquisa.
O que caracteriza uma base dinâmica?
Uma base dinâmica é aquela cujo conteúdo pode mudar ao longo do tempo, seja pela incorporação de novos registros, pela atualização de informações anteriores ou pela revisão dos procedimentos de produção dos dados.
Entre as mudanças possíveis estão:
- inclusão de novas observações;
- correção de registros existentes;
- exclusão de registros inválidos;
- reclassificação de categorias;
- atualização de indicadores;
- revisão de estimativas;
- alteração de variáveis;
- modificação de procedimentos metodológicos.
Essas alterações podem modificar os resultados obtidos pelo pesquisador mesmo quando a consulta aparentemente continua sendo a mesma.
Por que a data de acesso nem sempre resolve o problema?
A data de acesso informa quando determinado recurso foi consultado. Entretanto, ela não descreve necessariamente quais registros foram efetivamente utilizados.
Imagine que um estudante acesse uma base em março, baixe os arquivos em abril e consulte novamente a documentação em agosto.
Nesse cenário, existem pelo menos três eventos:
- consulta inicial à fonte;
- extração dos dados analisados;
- consulta posterior à documentação.
Esses eventos não devem ser confundidos.
Para compreender os resultados, a data de extração pode ser mais importante metodologicamente do que uma consulta posterior à página institucional.
Boa prática
Quando os dados podem mudar, registre a data da extração e preserve, quando permitido, o arquivo ou a resposta original utilizada. Essa prática complementa a referência bibliográfica e facilita a identificação do estado efetivamente analisado.
Quando vale a pena registrar também o horário?
O horário pode ser relevante quando a fonte sofre alterações frequentes, como em determinados sistemas operacionais, registros de eventos ou serviços atualizados continuamente.
Entretanto, não é necessário transformar o registro de horário em uma exigência universal.
A precisão temporal deve ser proporcional à frequência de atualização e à sensibilidade dos resultados.
Como explicar uma extração de base dinâmica na metodologia?
Uma descrição metodológica pode informar:
- qual fonte foi utilizada;
- qual recurso foi consultado;
- quando ocorreu a extração;
- qual período dos dados foi selecionado;
- quais filtros foram aplicados;
- qual arquivo ou resposta foi preservado;
- quais transformações ocorreram posteriormente.
Modelo estrutural:
Os dados foram extraídos de [identificação da fonte] em [data], considerando [período e recorte]. Após a obtenção, os registros foram submetidos a [tratamentos], resultando na base analítica utilizada no estudo.
Esse modelo deve ser adaptado ao procedimento realmente executado.
Versões, releases e snapshots: como identificar o estado analisado?
O versionamento é um mecanismo utilizado para distinguir diferentes estados de um objeto digital.
Em datasets, essa distinção pode ser fundamental porque pequenas alterações nos registros podem modificar estatísticas, gráficos e conclusões.
Versão declarada pelo produtor
Quando o dataset apresenta uma versão oficial, essa informação pode integrar sua identificação bibliográfica.
Exemplos hipotéticos:
- versão 1.0;
- versão 1.2;
- versão 2.0;
- release 2026-03.
Essas designações não devem ser inventadas pelo pesquisador. Elas precisam corresponder ao sistema de identificação adotado pela fonte.
Snapshot
Um snapshot representa um estado preservado de determinado conjunto ou sistema em um momento específico.
Quando existe um snapshot identificável, ele pode ajudar a documentar o conteúdo analisado sem depender exclusivamente do estado atual da fonte.
Release
Um release pode reunir arquivos, correções e documentação associados a uma publicação específica.
É importante verificar se o release representa efetivamente o estado dos dados utilizado, especialmente em projetos que mantêm diversas versões disponíveis.
Versão da API e versão do dataset não são necessariamente iguais
Uma API pode possuir uma versão técnica, enquanto os dados disponibilizados por ela apresentam outro mecanismo de atualização.
Por exemplo:
API versão 2 → conjunto de dados atualizado continuamente.
Nesse caso, registrar apenas a versão 2 da API não identifica necessariamente o estado dos registros.
O pesquisador pode precisar documentar tanto o mecanismo de acesso quanto a extração.
O que fazer quando não existe versionamento formal?
Não atribua artificialmente uma versão ao conjunto.
Em vez disso, preserve os elementos disponíveis:
- identificação da fonte;
- data de extração;
- período;
- parâmetros;
- arquivo exportado;
- identificador da consulta;
- documentação correspondente.
Atenção
Versionamento, snapshots e preservação de extrações são recursos de rastreabilidade. Sua utilização deve ser apresentada como boa prática quando pertinente, e não como obrigação universal imposta pelas normas ABNT.
Dados públicos: disponibilidade não elimina a necessidade de referência
O fato de um dataset estar disponível gratuitamente ou em um portal público não significa que sua origem possa ser omitida.
Dados públicos continuam possuindo responsabilidade institucional, contexto de produção e limitações.
Dados públicos não são necessariamente dados sem autoria
Um órgão governamental pode produzir, organizar ou disponibilizar dados relacionados a políticas públicas, população, economia, educação ou saúde.
Mesmo quando os registros são acessíveis sem pagamento, é necessário identificar adequadamente a fonte utilizada.
Disponibilidade pública e licença de reutilização são questões diferentes
Um conjunto estar acessível na internet não significa automaticamente que qualquer forma de redistribuição ou reutilização seja permitida.
Verifique, quando aplicável:
- licença;
- termos de uso;
- condições de atribuição;
- restrições de redistribuição;
- requisitos de proteção de dados.
A referência bibliográfica e o cumprimento das condições de utilização são responsabilidades distintas.
Dados públicos também podem apresentar limitações metodológicas
Entre as limitações possíveis estão:
- sub-registro;
- cobertura incompleta;
- atrasos de atualização;
- mudanças de classificação;
- diferenças territoriais;
- alterações nos procedimentos de coleta.
Essas questões devem ser avaliadas conforme o sistema utilizado e o objetivo da pesquisa.
Dados produzidos pelo próprio pesquisador: quando existe um dataset citável?
Nem todos os dados utilizados em um TCC foram obtidos de fontes externas.
O próprio pesquisador pode produzir registros por meio de questionários, entrevistas, observações, experimentos, medições ou levantamentos.
Nesses casos, é necessário distinguir a descrição metodológica da eventual publicação de um dataset independente.
Dados coletados exclusivamente para o TCC
Quando o pesquisador coleta dados e os utiliza diretamente no próprio trabalho, a metodologia deve explicar como ocorreu a produção dessas informações.
Conforme a natureza da pesquisa, isso pode envolver:
- instrumentos de coleta;
- critérios de seleção;
- participantes ou unidades observadas;
- procedimentos;
- período;
- tratamento;
- cuidados éticos.
Não é necessário presumir que todo conjunto interno de registros deva se transformar automaticamente em uma referência bibliográfica independente.
Quando os dados próprios são publicados como dataset
Se o pesquisador deposita um conjunto em repositório e ele recebe identidade própria, título, responsabilidade, data e eventualmente DOI, passa a existir um objeto que pode ser identificado e citado.
Essa situação é diferente de simplesmente possuir uma planilha armazenada no computador.
Dataset próprio e TCC não são o mesmo objeto
Um TCC pode apresentar análises, interpretações e conclusões.
Um dataset associado pode disponibilizar os registros que sustentam essas análises.
Quando publicados separadamente, ambos podem possuir identificações bibliográficas distintas.
Visão do especialista
O que determina a necessidade de documentação não é apenas a origem externa ou interna dos dados, mas a função que eles exercem na pesquisa e a existência de um objeto identificável que possa ser localizado ou reconhecido.
Dados restritos, confidenciais ou sensíveis: como documentar sem expor informações?
Algumas pesquisas utilizam conjuntos de dados que não podem ser disponibilizados publicamente.
Isso pode ocorrer por razões relacionadas à privacidade, confidencialidade, contratos, propriedade intelectual, segurança ou condições éticas.
A impossibilidade de divulgar os registros não elimina a necessidade de explicar sua origem e utilização.
Identificação bibliográfica não equivale à divulgação integral dos dados
Uma pesquisa pode identificar a instituição responsável, o tipo de recurso e o contexto de obtenção sem publicar informações protegidas.
O nível de detalhe dependerá das condições de acesso e das obrigações aplicáveis.
O que pode ser descrito na metodologia?
Conforme permitido:
- natureza dos dados;
- instituição ou contexto de origem;
- período;
- critérios de seleção;
- procedimentos de acesso;
- tratamento;
- medidas de proteção;
- limitações de compartilhamento.
Não publique informações pessoais apenas para facilitar a reprodução
Rastreabilidade e reprodutibilidade devem respeitar os limites legais, éticos e contratuais aplicáveis.
Em pesquisas com dados pessoais, a legislação de proteção de dados e as exigências institucionais pertinentes precisam ser consideradas.
Dados anonimizados exigem avaliação cuidadosa
Remover nomes e documentos não garante, por si só, anonimização efetiva.
Combinações de variáveis podem permitir reidentificação em determinadas circunstâncias.
Por isso, o compartilhamento de dados derivados de pessoas deve considerar riscos residuais e orientações especializadas quando necessário.
Quando não existe endereço público
Não invente DOI, URL ou disponibilidade pública.
Documente a situação real do material e siga as orientações da instituição para fontes não publicadas, materiais restritos e informações obtidas mediante autorização.
Atenção
A necessidade de citar ou documentar dados restritos não autoriza a divulgação de informações confidenciais, credenciais, identificadores pessoais ou arquivos protegidos.
Dataset e artigo científico: objetos relacionados, mas não intercambiáveis
Um dos erros mais frequentes em pesquisas que reutilizam dados é substituir a identificação do dataset pela referência de um artigo que o descreve.
Essa substituição pode ocultar o objeto efetivamente analisado.
O artigo comunica a pesquisa
Em geral, um artigo pode apresentar:
- problema investigado;
- objetivos;
- fundamentação;
- metodologia;
- resultados;
- discussão.
O dataset disponibiliza os registros
Um conjunto de dados pode oferecer:
- observações;
- variáveis;
- arquivos;
- metadados;
- documentação;
- identificadores próprios.
Quando citar apenas o artigo?
Quando a informação utilizada vem do conteúdo intelectual do artigo e não há reutilização independente do dataset, o artigo pode ser o objeto bibliográfico pertinente.
Quando citar o dataset?
Quando o conjunto de dados foi efetivamente utilizado como fonte de registros para análise, sua identidade deve ser preservada.
Quando os dois são relevantes?
Quando o pesquisador utiliza os registros e também depende da descrição metodológica ou interpretação apresentada no artigo.
Nessa situação, reconhecer os dois objetos pode melhorar a transparência.
O DOI do artigo não substitui o DOI do dataset
Se ambos possuem identificadores próprios, é necessário verificar qual corresponde ao objeto utilizado.
Copiar o DOI do artigo para uma referência apresentada como dataset cria uma inconsistência bibliográfica.
Dataset, software e repositório: três funções que não devem ser confundidas
Pesquisas baseadas em dados frequentemente envolvem programas, bibliotecas, plataformas e ambientes de armazenamento.
Esses elementos participam do processo, mas exercem funções diferentes.
| Objeto | Função principal | Exemplo de uso na pesquisa |
|---|---|---|
| Dataset | Disponibilizar dados | Registros utilizados na análise |
| Software | Executar operações | Limpeza, cálculo e modelagem |
| Repositório | Hospedar ou preservar recursos | Acesso ao dataset ou código |
| Documentação | Explicar estrutura e funcionamento | Interpretação de variáveis |
| Artigo | Comunicar pesquisa científica | Fundamentação ou método |
O software utilizado para analisar dados não é a fonte dos registros
Imagine que um pesquisador obtenha dados de uma instituição pública e utilize Python para analisá-los.
Python participa do processamento, mas não se transforma automaticamente na fonte dos dados.
Da mesma maneira, um pacote estatístico pode ser metodologicamente importante sem substituir a identificação do dataset.
GitHub pode hospedar dados e código simultaneamente
Um projeto pode conter:
- arquivos de dados;
- scripts;
- documentação;
- configurações;
- resultados;
- histórico de versões.
O pesquisador precisa identificar qual desses componentes utilizou.
Uma única pesquisa pode exigir múltiplas referências
Considere um estudo que utiliza:
- dataset publicado em repositório;
- artigo que explica sua coleta;
- software especializado para análise;
- documentação técnica independente.
Se cada objeto contribuiu de maneira relevante, pode ser adequado reconhecê-los separadamente, observando as normas e orientações institucionais aplicáveis.
Erro comum
Referenciar apenas o software porque ele foi utilizado para abrir, processar ou visualizar os dados, deixando sem identificação a fonte original dos registros.
Como escrever uma metodologia realmente rastreável ao utilizar datasets?
Uma metodologia de pesquisa com dados secundários não deve se limitar a informar que “os dados foram coletados em fontes oficiais”.
Essa frase pode indicar uma intenção geral, mas não descreve adequadamente o percurso realizado.
Uma metodologia mais informativa apresenta decisões que permitem compreender como os dados se transformaram em resultados.
Etapa 1 — Identificação da fonte
Informe a instituição, sistema, pesquisa ou dataset utilizado.
Quando houver várias fontes, apresente cada uma de maneira suficientemente clara.
Etapa 2 — Justificativa da escolha
Explique por que o conjunto foi considerado adequado ao problema investigado.
Dependendo do estudo, a justificativa pode envolver:
- cobertura;
- confiabilidade;
- pertinência das variáveis;
- período disponível;
- representatividade;
- compatibilidade metodológica.
Etapa 3 — Delimitação temporal e territorial
Registre quais períodos e territórios entraram na análise.
Não confunda o período de referência dos dados com a data em que eles foram extraídos.
Etapa 4 — Seleção de unidades e registros
Explique quais observações foram incluídas.
Por exemplo:
- municípios;
- estabelecimentos;
- participantes;
- eventos;
- períodos;
- categorias.
Etapa 5 — Seleção de variáveis
Informe quais variáveis foram utilizadas e, quando necessário, como foram operacionalizadas.
Uma variável derivada deve ser distinguida de uma variável originalmente disponibilizada pela fonte.
Etapa 6 — Obtenção dos dados
Descreva se a coleta ocorreu por:
- download direto;
- consulta em sistema;
- exportação de tabela;
- API;
- acesso institucional;
- recebimento autorizado de arquivos.
Etapa 7 — Tratamento dos registros
Explique operações relevantes como:
- padronização de formatos;
- tratamento de ausentes;
- exclusão de duplicidades;
- correção de inconsistências;
- agregação;
- recodificação;
- junção de bases.
Etapa 8 — Construção da base analítica
Informe como o conjunto final foi obtido a partir dos registros originais.
Quando pertinente, apresente a quantidade inicial e final de observações.
Etapa 9 — Procedimentos de análise
Descreva os métodos empregados para responder ao problema de pesquisa.
Isso pode incluir análises descritivas, estatísticas, qualitativas, espaciais ou computacionais, conforme o desenho do estudo.
Etapa 10 — Limitações
Reconheça limitações que possam afetar a interpretação.
Exemplos:
- dados incompletos;
- restrições de cobertura;
- mudanças metodológicas;
- atualizações posteriores;
- ausência de variáveis relevantes;
- possíveis vieses.
Exemplo comentado de metodologia com dados secundários
Considere um estudo hipotético que analisa indicadores municipais ao longo de cinco anos.
Uma redação excessivamente genérica seria:
Foram utilizados dados públicos coletados na internet, posteriormente analisados em planilhas.
Essa descrição deixa diversas perguntas sem resposta.
Uma versão metodologicamente mais informativa poderia ser:
O estudo utilizou dados secundários disponibilizados por [instituição], provenientes de [pesquisa ou sistema]. Foram selecionados registros referentes aos municípios de [recorte territorial], no período de [anos]. A extração ocorreu em [data], mediante [procedimento de obtenção]. As variáveis [identificação] foram selecionadas conforme sua pertinência aos objetivos do estudo. Após a obtenção, os registros passaram por [tratamentos], resultando em uma base analítica utilizada para [procedimentos de análise].
O segundo modelo não é uma fórmula obrigatória da ABNT.
Ele representa uma estrutura didática para documentar decisões metodológicas relevantes.
O que melhorou na segunda versão?
O texto passou a identificar:
- origem;
- recurso;
- recorte;
- período;
- extração;
- variáveis;
- tratamento;
- análise.
Essas informações ajudam o leitor a compreender como o resultado foi construído.
Proveniência completa: como conectar os dados originais aos resultados do TCC?
Uma pesquisa pode possuir referências corretas e, ainda assim, apresentar falhas de rastreabilidade.
Isso acontece quando não existe documentação suficiente para compreender as transformações realizadas entre a fonte e os resultados.
Uma cadeia operacional útil é:
fonte → objeto de dados → versão ou estado → extração → recorte → limpeza → transformação → base analítica → análise → resultado.
Fonte
Identifica a origem institucional ou intelectual dos registros.
Objeto de dados
Identifica o dataset, pesquisa, tabela, arquivo ou recurso efetivamente utilizado.
Versão ou estado
Permite situar os dados no tempo ou em determinado processo de versionamento.
Extração
Descreve como os registros foram obtidos.
Recorte
Define quais registros e variáveis foram selecionados.
Limpeza e transformação
Explica como os dados originais foram modificados.
Base analítica
Representa o conjunto preparado para a análise.
Análise
Descreve os procedimentos empregados para produzir resultados.
Resultado
Corresponde às tabelas, gráficos, indicadores, interpretações ou modelos apresentados no trabalho.
Erros metodológicos que uma referência correta não consegue resolver
A qualidade bibliográfica e a qualidade metodológica estão relacionadas, mas não são equivalentes.
Uma referência bem formatada não corrige problemas como:
- utilizar variável diferente da pretendida;
- selecionar período incorreto;
- confundir unidade de medida;
- misturar versões incompatíveis;
- ignorar pesos amostrais quando necessários;
- não tratar duplicidades;
- excluir registros sem documentar o critério;
- combinar bases com chaves inadequadas;
- interpretar códigos sem consultar o dicionário;
- atribuir à fonte um indicador calculado pelo pesquisador;
- omitir limitações relevantes;
- apresentar dados externos como produção inteiramente própria.
Esses problemas exigem revisão do procedimento de pesquisa, não apenas da lista de referências.
Em resumo
A referência identifica o recurso utilizado, mas a metodologia precisa explicar o percurso entre os registros originais e os resultados. Uma pesquisa rastreável depende da coerência entre fonte, objeto, versão, extração, recorte, tratamento, análise e apresentação dos resultados.
Auditoria complementar: 25 verificações para pesquisas que utilizam datasets
Antes de considerar concluída a documentação de uma pesquisa baseada em dados, realize a seguinte verificação:
- Identifiquei corretamente a fonte?
- Sei qual dataset ou recurso utilizei?
- Distingui o produtor da plataforma?
- Registrei a versão quando existente?
- Documentei o estado de bases dinâmicas?
- Registrei a data de extração quando pertinente?
- Preservei os arquivos originais quando permitido?
- Verifiquei a licença e as condições de uso?
- Identifiquei restrições de confidencialidade?
- Evitei divulgar informações protegidas?
- Documentei o período analisado?
- Documentei o território?
- Defini a população ou unidade de análise?
- Registrei as variáveis utilizadas?
- Expliquei critérios de inclusão e exclusão?
- Documentei valores ausentes?
- Registrei o tratamento de duplicidades?
- Expliquei transformações relevantes?
- Identifiquei variáveis derivadas?
- Preservei a origem de bases combinadas?
- Distingui dataset e artigo associado?
- Distingui dataset e software?
- Minha metodologia corresponde à referência?
- As fontes de tabelas e gráficos estão coerentes?
- Um leitor consegue compreender como os resultados foram produzidos?
Esse checklist não substitui as orientações metodológicas da instituição nem representa uma lista de exigências universais da ABNT.
Ele funciona como ferramenta editorial e científica para reduzir lacunas de documentação.
Visão do especialista
O objetivo de uma boa documentação de dados não é produzir a referência mais longa possível. É permitir que o leitor reconheça qual objeto foi utilizado, em qual estado, sob qual recorte e por meio de quais procedimentos ele contribuiu para os resultados.
Como citar dados secundários utilizados no TCC?
Dados secundários são dados que já existiam antes da pesquisa atual e foram produzidos, coletados, organizados ou disponibilizados por terceiros para determinada finalidade.
Eles podem ser encontrados em:
- órgãos governamentais;
- institutos de estatística;
- organizações internacionais;
- repositórios científicos;
- universidades;
- institutos de pesquisa;
- projetos acadêmicos;
- bases administrativas;
- plataformas de compartilhamento de dados.
Utilizar dados secundários não significa simplesmente escrever que a pesquisa é “documental” ou que “foram utilizados dados disponíveis na internet”.
É necessário identificar de onde os dados vieram e explicar como eles foram transformados em material de análise.
O que deve ser documentado?
Dependendo do estudo:
- produtor ou responsável;
- nome da base ou dataset;
- versão ou estado;
- período coberto;
- população;
- unidade de análise;
- variáveis selecionadas;
- critérios de inclusão e exclusão;
- forma de obtenção;
- data de extração;
- tratamentos realizados;
- limitações conhecidas.
Dados secundários não significam dados sem metodologia
Um conjunto secundário foi produzido por algum processo.
Antes de reutilizá-lo, procure compreender:
- como os dados foram coletados;
- qual população representam;
- quais definições foram utilizadas;
- quais limitações existem;
- se houve mudanças metodológicas;
- se as variáveis são comparáveis ao longo do período estudado.
Atenção
Uma base extensa, conhecida ou institucional não é automaticamente adequada a qualquer pergunta de pesquisa. A qualidade metodológica depende também da compatibilidade entre os dados disponíveis e o problema investigado.
Como citar apenas uma parte de um dataset?
É muito comum que o pesquisador utilize apenas uma pequena parte de um conjunto maior.
Imagine um dataset contendo:
- 50 países;
- 30 anos;
- 200 variáveis;
- milhões de registros.
O TCC pode analisar apenas:
- Brasil;
- 2015 a 2025;
- cinco variáveis;
- determinada população.
Nesse cenário, a referência continua identificando o dataset ou recurso pertinente, enquanto a metodologia explica o recorte.
Preciso criar uma nova referência para meu recorte?
Não apenas porque você selecionou parte dos registros.
Uma seleção analítica realizada pelo próprio pesquisador não transforma automaticamente o recorte em um novo dataset publicado.
Explique na metodologia:
- quais registros foram selecionados;
- por quê;
- quais variáveis foram mantidas;
- qual período foi utilizado;
- quais critérios foram aplicados.
E se o arquivo utilizado possuir identidade própria?
A situação pode mudar se determinado arquivo:
- possuir título próprio;
- possuir identificador persistente;
- for tratado pelo repositório como objeto independente;
- representar uma versão ou subconjunto formalmente publicado.
Nesse caso, avalie a granularidade bibliográfica adequada ao objeto real.
Como indicar o recorte em uma tabela?
Se uma tabela apresenta apenas determinado período ou população, seu título, notas e fonte devem permitir que o leitor compreenda o que está sendo mostrado.
A metodologia fornece o detalhamento do processo de seleção.
Na prática
Não tente colocar todos os filtros do recorte dentro da referência bibliográfica. Preserve a identidade do dataset na referência e explique a seleção metodológica no lugar apropriado.
CSV, Excel, JSON e outros formatos: como citar?
Um dos erros mais frequentes é confundir o formato de armazenamento com a fonte dos dados.
CSV, XLSX, JSON, XML, Parquet e outros formatos informam como os dados estão organizados ou armazenados digitalmente.
Eles não respondem, por si só:
- quem produziu os dados;
- qual é o dataset;
- qual pesquisa os originou;
- qual versão foi utilizada;
- qual instituição é responsável.
Por isso:
formato do arquivo ≠ fonte dos dados.
Como citar arquivo CSV?
Se o CSV é apenas um arquivo pertencente a um dataset, identifique o conjunto correspondente.
Na metodologia, pode ser útil informar que os registros foram obtidos em formato CSV.
Exemplo de descrição:
Os dados foram obtidos em formato CSV a partir do dataset [título], sendo posteriormente processados para seleção das variáveis utilizadas na análise.
Como citar planilha Excel?
O mesmo princípio vale para arquivos XLS ou XLSX.
Não utilize “Microsoft Excel” como fonte apenas porque os dados estavam armazenados em uma planilha.
Procure identificar:
- quem disponibilizou a planilha;
- qual recurso ela representa;
- qual período contém;
- se possui título;
- se integra um dataset maior.
Como citar arquivo JSON?
JSON é muito utilizado em respostas de APIs e disponibilização de dados estruturados.
Identifique a fonte e documente a consulta ou recurso que produziu a resposta.
Na metodologia, informe o formato quando ele for relevante para o processamento.
Como citar arquivo XML?
O raciocínio é equivalente.
XML descreve uma forma de estruturar os dados, mas não substitui a identificação do produtor ou do conjunto.
Como citar arquivo Parquet?
Arquivos Parquet são comuns em fluxos de dados de maior escala.
Se o arquivo integra um dataset, a referência deve continuar centrada na identidade do conjunto ou objeto apropriado.
Na metodologia, o formato pode ser registrado quando influenciar a importação, processamento ou reprodução da análise.
E arquivos SAV, DTA, RData ou RDS?
O mesmo princípio vale para formatos associados a softwares estatísticos ou ambientes de programação.
.savnão transforma o SPSS na fonte dos dados;.dtanão transforma o Stata na fonte;.RDataou.rdsnão transformam o R na fonte.
Software e fonte de dados são objetos diferentes.
Quando necessário, o software utilizado pode ser documentado separadamente em conformidade com o contexto metodológico. Consulte também Como Citar Software nas Normas ABNT.
Erro comum
Escrever “Fonte: Excel” porque a tabela analisada estava em uma planilha. Excel pode ter sido a ferramenta ou o formato de trabalho; a fonte é o objeto ou instituição de onde os dados vieram.
Como citar dataset disponível no GitHub?
O GitHub pode hospedar projetos que incluem:
- datasets;
- código;
- documentação;
- arquivos de configuração;
- scripts;
- resultados;
- releases.
Isso significa que “está no GitHub” ainda não identifica qual objeto foi utilizado.
Primeiro descubra o que o repositório representa
Pergunte:
- o repositório foi criado para publicar um dataset?
- é principalmente um projeto de software?
- os dados são apenas arquivos auxiliares?
- os dados vieram de outra instituição?
- o responsável pelo repositório produziu os dados?
- existe uma release?
- existe versão?
- existe DOI associado?
GitHub é o autor?
Não.
O GitHub é a plataforma que hospeda o repositório.
A responsabilidade pelo conteúdo deve ser identificada a partir do projeto e de sua documentação.
O que registrar?
Quando o GitHub é materialmente importante para identificar o objeto utilizado, registre conforme pertinente:
- responsável;
- nome do repositório;
- release;
- tag;
- commit;
- data;
- arquivos utilizados;
- licença;
- README;
- DOI associado, quando existente.
Release, tag ou commit: qual usar?
Depende de como o projeto é organizado e de qual estado foi utilizado.
Release
Uma release pode representar uma versão formalmente publicada do projeto.
Tag
Uma tag pode marcar determinado estado relevante do repositório.
Commit
Um commit identifica um estado específico do histórico.
Ele pode ser particularmente útil quando:
- não existe release formal;
- os arquivos mudam frequentemente;
- a análise depende de um estado exato;
- é necessário reproduzir o conteúdo utilizado.
Preciso colocar o hash completo do commit na referência?
Não existe uma regra mecânica universal para qualquer situação.
A informação pode ser registrada na metodologia, documentação técnica ou referência, conforme a função que exerce e o padrão adotado.
O ponto central é preservar a possibilidade de identificar o estado utilizado quando isso for relevante.
Dataset no GitHub com versão arquivada no Zenodo
Alguns projetos utilizam o GitHub para desenvolvimento e um repositório como o Zenodo para arquivar releases e atribuir identificadores persistentes.
Nesse cenário, pode existir uma cadeia como:
repositório GitHub → release → versão arquivada → DOI.
Quando o objetivo é identificar de forma persistente a versão dos dados utilizada, o registro arquivado pode oferecer vantagens importantes.
Isso não significa que o GitHub se torne irrelevante.
Ele pode continuar sendo útil para:
- documentação;
- histórico;
- issues;
- código;
- desenvolvimento.
Mas o objeto arquivado e identificado persistentemente pode ser o ponto bibliográfico mais preciso para a versão utilizada.
O que é CITATION.cff e como ele ajuda a citar dados?
CITATION.cff é um arquivo estruturado que pode acompanhar projetos digitais e fornecer metadados destinados à citação.
Ele pode incluir informações como:
- título;
- autores;
- versão;
- data;
- DOI;
- URL;
- mensagem de citação.
Posso copiar o CITATION.cff diretamente para as referências?
Não necessariamente.
O arquivo é uma excelente fonte de metadados, mas você ainda precisa:
- confirmar qual objeto ele descreve;
- verificar se corresponde à versão utilizada;
- adaptar os elementos ao padrão bibliográfico adotado;
- distinguir software e dataset quando o projeto contiver ambos.
Por que ele é útil?
Porque reduz ambiguidades sobre quem deve receber crédito e qual versão ou identificador está associado ao projeto.
Entretanto, não transforme a existência de CITATION.cff em exigência universal para um dataset ser citável.
Boa prática
Quando um repositório oferece README, arquivo de citação e registro persistente, compare os metadados entre essas fontes. Divergências podem indicar que o projeto foi atualizado ou que os arquivos descrevem objetos diferentes.
README também deve ser citado?
O README pode conter informações essenciais para compreender o conjunto, como:
- descrição das variáveis;
- procedimentos de coleta;
- estrutura dos arquivos;
- licença;
- instruções de processamento;
- origem dos dados;
- limitações.
Se você utiliza informações específicas contidas no README como fonte documental, pode ser necessário tratá-lo como um documento relevante.
Isso é diferente de simplesmente consultar o README para aprender como abrir o dataset.
Dataset e README podem exercer funções diferentes
Por exemplo:
- o dataset fornece os registros analisados;
- o README explica como uma variável foi construída.
Se a definição dessa variável sustenta uma afirmação metodológica importante, preserve adequadamente a fonte dessa informação.
Dicionário de dados e codebook precisam ser identificados?
Sim, quando são necessários para interpretar corretamente as variáveis utilizadas.
Um dicionário pode informar:
- nome da variável;
- descrição;
- tipo;
- unidade;
- categorias;
- códigos especiais;
- valores ausentes;
- universo;
- saltos;
- regras de preenchimento.
Ignorar essa documentação pode levar a erros graves de interpretação.
Exemplo
Uma variável codificada como:
1 = sim
2 = não
9 = ignorado
não deve ser tratada automaticamente como uma variável numérica contínua.
A documentação é parte essencial da compreensão do dado.
Como citar duas ou mais bases de dados combinadas?
Muitos TCCs constroem uma base analítica a partir de fontes diferentes.
Exemplos:
- IBGE + DATASUS;
- Banco Mundial + FMI;
- dados climáticos + dados agrícolas;
- dados próprios + dados públicos;
- dois datasets científicos independentes.
Nesse cenário, cada fonte relevante precisa permanecer identificável.
Não transforme a base final em uma fonte imaginária
Depois da integração, o pesquisador pode possuir um arquivo chamado:
base_final.xlsx
Esse arquivo é um produto do fluxo de pesquisa.
Ele não substitui automaticamente as fontes originais.
O que explicar na metodologia?
Descreva:
- quais bases foram utilizadas;
- qual variável permitiu a integração;
- qual nível geográfico foi adotado;
- qual período foi utilizado;
- como diferenças de formato foram resolvidas;
- como códigos foram harmonizados;
- como duplicidades foram tratadas;
- como ausências foram tratadas;
- quais registros permaneceram após a junção.
Chaves de integração merecem atenção
Se duas bases são combinadas por:
- código do município;
- CPF anonimizado;
- identificador do estabelecimento;
- data;
- código de país;
- outro identificador,
documente a lógica da junção e os cuidados pertinentes.
Como indicar a fonte em uma tabela produzida com várias bases?
Uma forma adaptável é:
Fonte: elaboração própria a partir de dados de [fonte A] e [fonte B].
Se houver mais fontes, identifique-as de maneira legível e coerente com a metodologia.
O que é um dataset derivado?
Um dataset derivado é um conjunto produzido a partir de um ou mais conjuntos anteriores por meio de algum processamento.
Esse processamento pode envolver:
- seleção;
- limpeza;
- junção;
- agregação;
- recodificação;
- normalização;
- cálculos;
- extração de características;
- anotação;
- enriquecimento.
Nem toda planilha intermediária precisa ser tratada como um novo produto científico.
Mas é importante compreender quando o conjunto derivado passa a exercer papel próprio na pesquisa.
Exemplo simples
O pesquisador baixa dados de municípios e seleciona apenas um estado.
Esse recorte não precisa automaticamente ser publicado ou citado como um novo dataset.
Exemplo mais complexo
O pesquisador:
- combina três fontes;
- corrige códigos territoriais;
- calcula 20 indicadores;
- cria novas classificações;
- documenta o processamento;
- publica o resultado em repositório com DOI.
Nesse caso, o conjunto derivado pode adquirir identidade própria como produto de pesquisa.
Como citar dataset derivado?
Quando um conjunto derivado foi formalmente publicado, ele pode possuir:
- criadores;
- título;
- versão;
- data;
- repositório;
- DOI;
- licença;
- documentação.
Ele pode, portanto, ser identificado como um objeto próprio.
Isso não significa que as fontes originais devam ser apagadas.
Preserve a proveniência
Uma cadeia possível é:
dataset A + dataset B → transformação → dataset derivado.
Se outra pessoa utiliza apenas o dataset derivado, ela precisa saber:
- quem o criou;
- de quais fontes ele deriva;
- quais transformações foram realizadas;
- qual versão está utilizando.
Visão do especialista
Citar um dataset derivado não deve apagar a história dos dados. Quanto maior a transformação, mais importante se torna documentar a cadeia de proveniência.
Quais transformações dos dados devem ser documentadas?
Não existe uma lista universal aplicável a todas as pesquisas.
Documente as transformações que possam afetar:
- interpretação;
- reprodutibilidade;
- quantidade de registros;
- valores;
- variáveis;
- resultados.
Exemplos de transformações importantes
- remoção de duplicidades;
- exclusão de registros;
- tratamento de dados ausentes;
- recodificação;
- padronização;
- normalização;
- agregação;
- desagregação;
- conversão de unidades;
- conversão monetária;
- deflacionamento;
- criação de indicadores;
- junção de tabelas;
- imputação;
- correção manual;
- anonimização.
Como documentar exclusões e dados ausentes?
Se registros foram removidos por ausência de informações, documente o critério.
Por exemplo:
Foram excluídos registros sem informação para as variáveis X e Y.
Quando pertinente, informe também:
- quantidade inicial;
- quantidade excluída;
- quantidade final;
- razão da exclusão.
Por que isso importa?
Porque diferentes estratégias de tratamento de ausentes podem produzir amostras e resultados diferentes.
Como indicar uma variável calculada pelo pesquisador?
Se determinada variável não existia originalmente na fonte, não escreva como se ela tivesse sido fornecida pelo produtor do dataset.
Explique sua construção.
Exemplo:
A variável X foi calculada a partir das variáveis A e B por meio de [procedimento].
Quando necessário, informe:
- fórmula;
- unidade;
- arredondamento;
- tratamento de valores ausentes;
- referencial metodológico.
Como documentar conversão de moeda?
Se valores monetários foram convertidos, registre:
- moeda original;
- moeda final;
- taxa ou fonte utilizada;
- data ou período da conversão;
- procedimento aplicado.
Não apresente valores convertidos como se tivessem sido fornecidos originalmente pela fonte.
Como documentar valores deflacionados?
Quando valores monetários são ajustados ao longo do tempo, informe:
- índice utilizado;
- fonte do índice;
- período-base;
- fórmula ou procedimento;
- unidade resultante.
O mesmo princípio vale para outras transformações econômicas relevantes.
Como documentar padronização e normalização?
Se variáveis foram transformadas antes da análise, informe o procedimento quando ele for importante para interpretar ou reproduzir os resultados.
Exemplos:
- z-score;
- normalização min-max;
- transformação logarítmica;
- centralização;
- reescalonamento.
A fonte original continua sendo citada, mas a transformação pertence ao percurso metodológico do pesquisador.
Como citar dataset usado em machine learning?
Em projetos de aprendizado de máquina, o dataset pode exercer papel central na pesquisa.
Além da referência do conjunto, pode ser necessário documentar:
- versão;
- divisão entre treino, validação e teste;
- amostragem;
- balanceamento;
- pré-processamento;
- normalização;
- augmentação, quando aplicável;
- exclusões;
- rótulos;
- métricas.
Não cite apenas a biblioteca de machine learning
TensorFlow, PyTorch, scikit-learn ou outra ferramenta pode ser importante para a metodologia, mas não substitui a identificação dos dados utilizados.
Como citar dataset de imagens?
Conjuntos de imagens também são datasets.
Além dos metadados bibliográficos, podem ser relevantes:
- quantidade de imagens;
- classes;
- origem;
- resolução;
- anotações;
- licença;
- divisão de treino e teste;
- pré-processamento.
Se apenas parte das imagens foi utilizada, explique o recorte.
Como citar dataset de textos?
Datasets textuais podem conter:
- notícias;
- postagens;
- documentos;
- transcrições;
- resenhas;
- comentários;
- corpora linguísticos.
Além da identificação do dataset, considere documentar:
- origem dos textos;
- período;
- idioma;
- critérios de seleção;
- limpeza;
- tokenização ou processamento;
- questões de licença e acesso.
Como citar dataset geográfico?
Dados geográficos podem envolver:
- shapefiles;
- GeoJSON;
- rasters;
- coordenadas;
- limites administrativos;
- camadas temáticas.
Além da fonte, podem ser metodologicamente importantes:
- sistema de referência de coordenadas;
- escala;
- resolução;
- ano da malha;
- versão;
- processamentos espaciais realizados.
Se limites territoriais mudaram ao longo do tempo, registre a malha utilizada.
O que fazer se o dataset foi atualizado depois que terminei a análise?
Não altere automaticamente sua referência para a versão mais recente.
Primeiro compare as versões.
Verifique:
- se os registros utilizados mudaram;
- se houve correções;
- se as variáveis mudaram;
- se novos dados apenas foram acrescentados;
- se a metodologia mudou.
Se a atualização não afeta minha análise
Mantenha a documentação coerente com o estado efetivamente utilizado e, se necessário, registre a situação.
Se a atualização afeta minha análise
Avalie a necessidade de:
- baixar a nova versão;
- refazer o processamento;
- recalcular tabelas;
- refazer gráficos;
- reavaliar conclusões.
O que fazer se o dataset utilizado foi corrigido?
Uma correção posterior merece atenção maior do que uma simples expansão temporal quando ela modifica valores já utilizados.
Pergunte:
- qual erro foi corrigido?
- quais registros foram afetados?
- minhas variáveis foram afetadas?
- meus resultados mudariam?
- a instituição publicou errata ou nova versão?
Se a correção for material para os resultados, a consistência científica pode exigir uma nova análise.
Atenção
Não trate uma correção material como simples problema de formatação da referência. Se os dados mudaram, o problema pode alcançar resultados e conclusões.
Como documentar a proveniência em pesquisas com várias etapas?
Em pesquisas simples, a origem dos dados pode ser direta.
dataset → análise.
Em pesquisas complexas, a cadeia pode ser:
fonte A + fonte B → extração → limpeza → harmonização → integração → criação de variáveis → base analítica → modelo → resultado.
Cada seta representa uma transformação ou decisão que pode afetar o resultado.
Uma ficha de proveniência pode registrar
| Etapa | O que documentar |
|---|---|
| Fonte | Origem e identificação do dataset |
| Extração | Data, arquivos, consulta ou parâmetros |
| Limpeza | Exclusões, duplicidades e ausentes |
| Harmonização | Padronização de códigos, nomes e unidades |
| Integração | Chaves e regras de junção |
| Transformação | Variáveis derivadas e cálculos |
| Base analítica | Estado final utilizado na análise |
| Análise | Métodos e software |
| Resultado | Tabelas, gráficos e estimativas produzidas |
Preciso publicar toda essa ficha?
Não necessariamente.
Ela pode funcionar como instrumento interno para produzir uma metodologia consistente.
O trabalho final deve apresentar o nível de detalhe adequado à pesquisa, às exigências institucionais e à necessidade de compreensão e reprodução do procedimento.
O que vai na referência, na citação e na metodologia?
A tabela abaixo ajuda a evitar um dos principais problemas encontrados ao trabalhar com datasets: colocar informações corretas no lugar errado.
| Informação | Referência | Citação no texto | Metodologia |
|---|---|---|---|
| Responsável pelo dataset | Sim | Quando necessário à atribuição | Pode ser mencionado |
| Título do dataset | Sim | Quando necessário | Recomendável na identificação da fonte |
| Versão | Quando pertinente | Raramente necessária em toda ocorrência | Importante quando afeta a análise |
| DOI/identificador | Quando disponível e aplicável | Normalmente não | Pode ser registrado |
| Data de extração | Conforme o recurso e padrão adotado | Normalmente não | Especialmente útil em bases dinâmicas |
| Período analisado | Somente quando integra a identidade do recurso | Quando necessário ao argumento | Sim |
| Filtros | Normalmente não | Não | Sim, quando relevantes |
| Variáveis utilizadas | Normalmente não | Quando necessário ao texto | Sim |
| Limpeza | Não | Não | Sim |
| Tratamento de ausentes | Não | Não | Sim |
| Junção de bases | Não como procedimento | Não | Sim |
| Variável calculada | Não como procedimento | Quando discutida | Sim |
| Software | Em referência própria, quando pertinente | Quando pertinente | Sim, se relevante ao procedimento |
Em resumo
O formato do arquivo não substitui a fonte; GitHub não é automaticamente autor; README e dicionários podem exercer funções documentais próprias; bases combinadas precisam preservar suas origens; datasets derivados não devem apagar sua proveniência; e transformações metodologicamente relevantes precisam ser documentadas. A regra que organiza todo esse processo é simples: referência identifica, citação atribui, metodologia explica e proveniência conecta as etapas.
Dados secundários: como documentar corretamente uma pesquisa que reutiliza informações existentes?
Dados secundários são informações que já foram produzidas ou coletadas anteriormente e que passam a ser utilizadas em uma nova investigação.
Isso pode ocorrer em pesquisas acadêmicas que utilizam estatísticas governamentais, microdados, registros administrativos, bases institucionais, repositórios científicos ou conjuntos disponibilizados por outros pesquisadores.
O fato de os dados já existirem não elimina a necessidade de justificar sua escolha, verificar sua adequação e documentar como foram utilizados.
Fonte secundária não significa fonte de menor qualidade
Uma pesquisa baseada em dados secundários pode apresentar elevada qualidade científica quando os registros são apropriados ao problema investigado e os procedimentos de análise são transparentes.
Por outro lado, a utilização de uma base reconhecida não garante automaticamente que os resultados sejam válidos.
A qualidade depende também de fatores como:
- adequação da fonte ao objetivo;
- cobertura temporal;
- cobertura territorial;
- definição das variáveis;
- qualidade dos registros;
- procedimentos de seleção;
- tratamento dos dados;
- métodos de análise.
Dados secundários e revisão bibliográfica não são a mesma coisa
Uma revisão bibliográfica trabalha principalmente com publicações e documentos que sustentam uma discussão teórica ou científica.
Uma pesquisa com dados secundários pode utilizar registros existentes para realizar novas análises empíricas.
As duas abordagens podem coexistir no mesmo TCC, mas não devem ser tratadas como equivalentes.
Como apresentar a origem dos dados secundários?
Uma descrição adequada pode identificar:
- instituição responsável;
- pesquisa ou sistema de origem;
- dataset utilizado;
- período;
- população ou unidade de análise;
- procedimento de obtenção;
- data de extração, quando pertinente.
A referência bibliográfica identifica o recurso. A metodologia explica a seleção e o uso dos registros.
Boa prática
Antes de utilizar dados secundários, leia a documentação metodológica da fonte. Variáveis aparentemente simples podem apresentar definições, limitações e procedimentos de coleta que alteram sua interpretação.
Utilização parcial de um dataset: é necessário citar todos os arquivos e variáveis?
Um dataset pode conter milhares de registros, dezenas de variáveis e vários arquivos.
Entretanto, o pesquisador frequentemente utiliza apenas uma parte desse material.
Essa situação exige distinguir a identidade bibliográfica do conjunto da delimitação metodológica realizada.
O dataset pode continuar sendo o objeto principal da referência
Se os arquivos utilizados pertencem a um conjunto publicado com título, responsabilidade e identificador próprios, a referência pode identificar esse dataset.
A metodologia, por sua vez, informa quais componentes foram efetivamente utilizados.
Exemplo hipotético
Um repositório disponibiliza um dataset com:
- arquivo de participantes;
- arquivo de instituições;
- arquivo de resultados;
- dicionário de variáveis;
- documentação metodológica.
O estudante utiliza apenas o arquivo de resultados e seleciona três variáveis.
Uma documentação coerente pode:
- identificar o dataset na referência;
- informar o arquivo utilizado na metodologia;
- descrever as três variáveis selecionadas;
- explicar os filtros aplicados;
- registrar eventuais transformações.
Quando o arquivo possui identidade independente?
Alguns sistemas atribuem título, identificador ou registro próprio a componentes específicos.
Nessas situações, pode ser apropriado identificar o arquivo ou subconjunto diretamente, conforme a organização da fonte e sua função na pesquisa.
Não existe uma regra universal segundo a qual todo arquivo precisa de referência separada.
O que não fazer?
Evite:
- apresentar o dataset inteiro como se todos os seus registros tivessem sido analisados;
- omitir filtros relevantes;
- inventar uma referência para cada variável;
- substituir o título oficial pelo nome local do arquivo;
- confundir subconjunto produzido pelo pesquisador com publicação independente.
CSV, Excel, JSON, XML e outros formatos: o arquivo não substitui a fonte
O formato de um arquivo descreve como as informações são armazenadas ou organizadas tecnicamente.
Ele não determina, por si só, a responsabilidade bibliográfica pelos dados.
Uma mesma fonte pode disponibilizar o mesmo conjunto em formatos diferentes.
| Formato | Uso frequente | Cuidado metodológico |
|---|---|---|
| CSV | Dados tabulares | Separadores, codificação e tipos de variáveis |
| XLSX | Planilhas eletrônicas | Abas, fórmulas e células formatadas |
| JSON | Dados estruturados e APIs | Hierarquia, campos e estruturas aninhadas |
| XML | Intercâmbio estruturado | Esquema e interpretação das tags |
| TXT | Arquivos textuais ou registros delimitados | Layout, codificação e posições dos campos |
| Parquet | Armazenamento analítico | Esquema, tipos e compatibilidade |
| ZIP | Distribuição compactada | Identificação dos arquivos contidos |
CSV: atenção aos separadores e à codificação
Um arquivo CSV pode utilizar diferentes separadores, codificações e convenções decimais.
Se a importação for realizada incorretamente, os valores podem ser interpretados de maneira inadequada.
Por exemplo, uma variável numérica pode ser importada como texto, ou colunas podem ser combinadas indevidamente.
Esses problemas não modificam a fonte bibliográfica, mas podem comprometer o processamento.
Excel: fórmulas e valores calculados exigem atenção
Planilhas podem conter fórmulas, abas auxiliares, filtros e valores derivados.
Antes de utilizar uma planilha, verifique se os dados analisados correspondem aos valores efetivamente apresentados e se existem procedimentos de cálculo relevantes.
JSON: estruturas aninhadas podem alterar a interpretação
Respostas de APIs podem conter objetos, listas e campos aninhados.
Converter essas estruturas para tabelas pode exigir decisões de transformação.
Essas decisões devem ser documentadas quando afetam os registros ou a unidade de análise.
Arquivos compactados
Um ZIP pode reunir vários arquivos pertencentes ao mesmo dataset.
O nome do pacote compactado não substitui necessariamente o título oficial do conjunto.
Erro comum
Escrever que a fonte dos dados foi “um arquivo Excel” ou “um CSV”, sem identificar a instituição, pesquisa ou dataset que originou os registros.
Integridade dos arquivos: como evitar mudanças silenciosas nos dados utilizados?
Em projetos que exigem maior rigor de rastreabilidade, pode ser útil preservar os arquivos originais separadamente dos arquivos tratados.
Uma organização possível é:
- dados_brutos;
- dados_intermediarios;
- dados_tratados;
- scripts;
- documentacao;
- resultados.
Essa estrutura é uma sugestão operacional, não uma exigência das normas ABNT.
Por que separar dados brutos e tratados?
Porque o pesquisador pode precisar verificar se uma alteração surgiu:
- na fonte original;
- na importação;
- na limpeza;
- na transformação;
- na análise.
Hashes de arquivos
Em determinados projetos, um hash criptográfico pode ajudar a verificar se um arquivo permaneceu inalterado.
Por exemplo, um hash SHA-256 pode funcionar como registro de integridade de um arquivo específico.
Entretanto, o hash não substitui autoria, título, versão, DOI ou referência bibliográfica.
Ele também não comprova, sozinho, que os dados são corretos ou cientificamente confiáveis.
Quando esse controle faz sentido?
Pode ser especialmente útil em:
- projetos com muitas etapas de processamento;
- pesquisas colaborativas;
- datasets grandes;
- análises computacionais;
- estudos que precisam preservar snapshots.
GitHub: como distinguir código, dataset, release e repositório?
O GitHub é frequentemente utilizado para disponibilizar projetos que combinam código, documentação e dados.
Por isso, a referência deve começar pela identificação do objeto efetivamente utilizado.
Repositório Git não é automaticamente dataset
Um repositório pode conter apenas código.
Também pode conter:
- arquivos de dados;
- scripts de coleta;
- scripts de tratamento;
- documentação;
- modelos;
- resultados;
- arquivos de configuração.
Antes de citar, determine qual desses componentes sustenta o trabalho.
Branch, tag, release e commit
Esses elementos possuem funções diferentes.
| Elemento | Função | Cuidado |
|---|---|---|
| Branch | Linha de desenvolvimento | Pode continuar mudando |
| Tag | Marca determinada referência no histórico | Verificar o estado associado |
| Release | Publicação identificada do projeto | Conferir versão e arquivos |
| Commit | Identifica um estado do histórico | Pode melhorar a precisão da documentação |
Por que citar apenas a branch principal pode ser insuficiente?
Uma branch como main pode receber alterações.
Se os resultados dependem de determinado estado dos arquivos, uma tag, release, commit ou versão arquivada pode oferecer identificação mais precisa.
GitHub e Zenodo podem estar relacionados
Alguns projetos preservam releases em repositórios que atribuem identificadores persistentes.
Nesses casos, verifique se existe uma versão arquivada com DOI e se ela corresponde ao material utilizado.
Não presuma que todo projeto hospedado no GitHub possui DOI.
CITATION.cff: o que é e como utilizar esse arquivo?
O arquivo CITATION.cff é utilizado por projetos para fornecer metadados de citação em formato estruturado.
Ele pode apresentar informações como:
- título;
- autores;
- versão;
- data;
- DOI;
- mensagem de citação;
- outros metadados.
Por que consultar o CITATION.cff?
Porque ele pode indicar como os responsáveis pelo projeto recomendam que o recurso seja citado.
Isso ajuda a reduzir erros de identificação.
O arquivo não substitui a conferência do objeto
Mesmo quando existe uma recomendação de citação, verifique:
- se ela corresponde ao software ou dataset utilizado;
- se a versão está correta;
- se o DOI corresponde ao objeto;
- se os responsáveis estão adequadamente identificados.
CITATION.cff não é uma norma ABNT
O arquivo fornece metadados e orientações de citação do projeto.
A apresentação bibliográfica deve ser adaptada ao padrão adotado no trabalho, respeitando as normas e orientações institucionais pertinentes.
Boa prática
Ao utilizar um projeto do GitHub, confira o README, os releases, as tags e o CITATION.cff, quando disponível. Esses elementos podem ajudar a identificar a versão e a responsabilidade pelo recurso.
README, dicionário de dados e documentação: quando precisam ser considerados?
Os arquivos de documentação podem ser fundamentais para interpretar corretamente um dataset.
README
Frequentemente apresenta:
- descrição do projeto;
- estrutura de arquivos;
- instruções de uso;
- dependências;
- licença;
- procedimentos de reprodução.
Dicionário de dados
Pode explicar:
- nomes das variáveis;
- definições;
- categorias;
- códigos;
- unidades;
- valores ausentes;
- restrições.
Documentação metodológica
Pode detalhar:
- procedimentos de coleta;
- amostragem;
- instrumentos;
- tratamento;
- limitações;
- alterações entre versões.
Quando citar a documentação separadamente?
Quando ela constitui um objeto identificável e é utilizada como fonte relevante de informações, pode ser pertinente referenciá-la conforme sua natureza.
Entretanto, não é necessário criar automaticamente uma referência independente para cada arquivo auxiliar de um dataset.
A decisão depende de sua função e identidade.
Combinação de bases de dados: como preservar a origem de cada conjunto?
Muitas pesquisas utilizam mais de uma fonte para construir a base analítica.
Por exemplo, um estudo pode combinar:
- indicadores econômicos;
- dados demográficos;
- informações educacionais;
- registros de saúde;
- dados territoriais.
Essa combinação pode enriquecer a análise, mas também cria novos riscos metodológicos.
Identifique cada fonte separadamente
Não substitua diferentes origens por uma referência genérica a “bases públicas”.
Cada conjunto utilizado deve permanecer identificável.
Documente as chaves de integração
Uma junção pode depender de:
- código de município;
- identificador institucional;
- ano;
- território;
- categoria;
- outra chave comum.
Se a chave estiver incorreta, a integração pode produzir associações inadequadas.
Verifique a compatibilidade temporal
Combinar dados de anos diferentes sem justificativa pode gerar interpretações problemáticas.
O pesquisador precisa explicar como os períodos foram alinhados.
Verifique a compatibilidade territorial
Limites geográficos, códigos e unidades administrativas podem mudar.
Essa questão merece atenção especial em séries históricas e comparações municipais.
Registre perdas de registros durante a junção
Uma integração pode eliminar observações que não encontram correspondência.
Se isso afeta a amostra final, a decisão deve ser documentada.
Atenção
Combinar duas bases não garante que suas variáveis sejam conceitualmente comparáveis. A integração técnica precisa ser acompanhada de avaliação metodológica.
Exemplo comentado: integração de duas fontes públicas
Imagine uma pesquisa hipotética que utiliza:
- Fonte A: indicadores educacionais por município;
- Fonte B: indicadores econômicos por município.
O pesquisador deseja analisar relações entre essas variáveis.
Primeiro problema: identificação
As duas fontes precisam ser reconhecidas bibliograficamente.
Segundo problema: período
É necessário verificar se os indicadores correspondem aos mesmos anos ou se existe justificativa para períodos diferentes.
Terceiro problema: território
Os códigos municipais devem ser compatíveis.
Quarto problema: unidades
Um indicador pode ser percentual, enquanto outro pode representar valores monetários.
Quinto problema: junção
É necessário documentar como as tabelas foram combinadas.
Sexto problema: perdas
Municípios sem correspondência podem ser excluídos ou tratados de outra maneira.
Essa decisão afeta a base analítica.
Sétimo problema: apresentação
Se o resultado final é uma tabela elaborada pelo pesquisador, sua fonte deve reconhecer a origem externa dos registros.
Uma formulação estrutural possível é:
Fonte: elaboração própria a partir de dados de [Fonte A] e [Fonte B].
A metodologia deve explicar o procedimento de integração.
Dataset derivado: quando um conjunto transformado se torna um novo objeto?
Um dataset derivado é produzido a partir de dados anteriores mediante algum processo de seleção, transformação, integração ou processamento.
Esse processo pode gerar um conjunto com identidade própria.
Exemplo hipotético
Um pesquisador:
- obtém dados de uma fonte institucional;
- seleciona determinados registros;
- remove duplicidades;
- padroniza variáveis;
- calcula novos indicadores;
- publica a base resultante em um repositório.
O conjunto publicado pode representar um novo objeto, mas sua proveniência continua ligada à fonte original.
Dataset derivado não significa dados inteiramente originais
O pesquisador pode ter criado:
- estrutura;
- variáveis;
- indicadores;
- recortes;
- agregações.
Entretanto, os registros de entrada continuam tendo origem anterior.
Como documentar o dataset derivado?
Conforme o caso, registre:
- fontes originais;
- versões utilizadas;
- arquivos de entrada;
- procedimentos de transformação;
- critérios de seleção;
- estrutura do conjunto final;
- identificador do dataset derivado, quando publicado.
O dataset derivado pode precisar de referência própria?
Quando é publicado como objeto identificável, com responsabilidade, título, data e eventualmente identificador persistente, pode ser citado como recurso próprio.
Isso não elimina automaticamente a necessidade de reconhecer as fontes anteriores.
Proveniência das transformações: como registrar o caminho dos dados?
Em uma pesquisa quantitativa ou computacional, os dados frequentemente passam por diversas etapas antes de gerar resultados.
Uma cadeia possível é:
dataset original → seleção → limpeza → padronização → integração → variáveis derivadas → base analítica → análise → resultado.
Seleção
Define quais registros e variáveis permanecem.
Limpeza
Pode envolver tratamento de ausentes, duplicidades e inconsistências.
Padronização
Pode ajustar formatos, categorias, unidades e códigos.
Integração
Combina informações de diferentes arquivos ou fontes.
Variáveis derivadas
Representam medidas calculadas a partir dos registros originais.
Base analítica
É o conjunto preparado para responder ao problema de pesquisa.
Resultado
É o produto da análise, como tabela, gráfico, indicador ou modelo.
Como documentar transformações sem tornar a metodologia ilegível?
Nem toda operação técnica precisa ser explicada linha por linha no corpo do TCC.
Uma boa estratégia é distribuir a documentação em diferentes níveis.
| Local | Conteúdo recomendado |
|---|---|
| Referências | Identificação dos objetos utilizados |
| Metodologia | Principais decisões de seleção e tratamento |
| Apêndice | Procedimentos complementares, quando pertinentes |
| Script | Implementação operacional |
| README | Instruções e organização do projeto |
| Dicionário | Variáveis, códigos e unidades |
Essa distribuição evita dois extremos:
- metodologia vaga demais;
- metodologia sobrecarregada com detalhes técnicos que poderiam estar em material complementar.
Teste final de proveniência: o leitor consegue reconstruir o percurso?
Antes de encerrar a documentação, responda:
- Quais foram as fontes originais?
- Quais datasets foram utilizados?
- Quais versões ou estados foram analisados?
- Quais arquivos entraram no processamento?
- Quais registros foram selecionados?
- Quais variáveis foram utilizadas?
- Quais critérios de exclusão foram aplicados?
- Quais transformações ocorreram?
- Quais bases foram combinadas?
- Quais chaves de integração foram utilizadas?
- Quais registros foram perdidos durante a integração?
- Quais variáveis foram derivadas?
- Qual conjunto final sustentou a análise?
- Quais resultados foram produzidos?
- As fontes originais continuam reconhecíveis?
Se o percurso não puder ser explicado, a documentação ainda precisa ser aperfeiçoada.
Em resumo
Dados secundários, arquivos, repositórios Git, conjuntos combinados e datasets derivados exigem uma distinção permanente entre identidade bibliográfica e procedimento metodológico. O formato do arquivo não substitui a fonte; o GitHub não substitui automaticamente os criadores; a combinação de bases não apaga suas origens; e a transformação de dados não elimina a necessidade de preservar sua proveniência.
Exemplos de como citar base de dados e dataset nas normas ABNT
Os exemplos a seguir foram organizados para mostrar como o raciocínio muda conforme o objeto utilizado.
Eles não devem ser copiados mecanicamente.
Em cada caso, substitua os campos pelos metadados reais do recurso consultado e confira as regras adotadas pela sua instituição.
Atenção
Os modelos abaixo são estruturais. Não invente DOI, versão, autoria, data, título, repositório ou qualquer outro elemento apenas para fazer sua referência parecer mais completa.
1. Dataset com autor pessoal e DOI
Quando o conjunto possui um criador claramente identificado e DOI próprio:
SOBRENOME, Nome. Título do dataset. Versão, quando pertinente. Repositório, ano. DOI: [DOI do dataset].
Confirme que o DOI pertence ao dataset e não a um artigo associado.
2. Dataset com vários autores
Quando vários pesquisadores aparecem como criadores:
SOBRENOME, Nome; SOBRENOME, Nome; SOBRENOME, Nome. Título do dataset. Versão. Repositório, ano. DOI: [DOI].
A representação dos responsáveis deve seguir o padrão bibliográfico adotado no trabalho.
3. Dataset com autoria institucional
Quando uma instituição é claramente responsável pelo conjunto:
INSTITUIÇÃO RESPONSÁVEL. Título do dataset. Versão, quando existente. Repositório ou instituição, ano. [identificador/acesso].
Não substitua a instituição por uma plataforma apenas porque o arquivo está hospedado nela.
4. Dataset com DOI e versão explícita
Quando o registro informa a versão utilizada:
AUTOR/INSTITUIÇÃO. Título do dataset. Versão 2.1. Repositório, ano. DOI: [DOI da versão utilizada].
Se os resultados foram produzidos com a versão 2.1, não troque silenciosamente para a versão 3.0.
5. Dataset sem DOI
Quando não existe DOI:
AUTOR/INSTITUIÇÃO. Título do dataset. Versão, quando pertinente. Instituição ou repositório, ano. Disponível em: [endereço estável]. Acesso em: [data], quando aplicável.
Procure outros identificadores persistentes antes de depender apenas de uma URL comum.
6. Dataset com Handle
Quando o repositório utiliza Handle:
AUTOR/INSTITUIÇÃO. Título do dataset. Repositório, ano. Handle: [identificador].
O fato de não existir DOI não impede a identificação persistente do recurso.
7. Dataset no Zenodo com DOI da versão específica
Se a análise foi realizada com determinada versão:
AUTOR/RESPONSÁVEL. Título do dataset. Versão [X]. Zenodo, ano. DOI: [DOI da versão utilizada].
Esse nível de especificidade pode ser especialmente útil para reprodutibilidade.
8. Dataset no Zenodo com identificador que representa o conjunto de versões
Quando a intenção é mencionar o recurso de maneira mais ampla, pode existir um identificador associado ao conjunto das versões.
Antes de utilizá-lo, verifique se essa granularidade corresponde à função da citação.
Para uma análise reproduzível vinculada a arquivos específicos, a versão efetivamente utilizada pode ser mais informativa.
9. Dataset no SciELO Data
Estrutura adaptável:
AUTOR/RESPONSÁVEL. Título do dataset. Versão, quando pertinente. SciELO Data, ano. DOI: [DOI do dataset].
Confira o registro específico e não apenas a página inicial do repositório.
10. Dataset no SciELO Data associado a artigo científico
Se você utilizou tanto os dados quanto o artigo:
- faça a referência do dataset como objeto de dados;
- faça a referência do artigo como publicação científica.
Não transforme os dois objetos em uma única referência híbrida.
11. Dataset no Kaggle produzido pelo próprio publicador
Se a documentação indica que o responsável pelo registro criou o conjunto:
RESPONSÁVEL. Título do dataset. Versão, quando pertinente. Kaggle, ano. [identificador/endereço pertinente].
Confirme autoria, versão e proveniência.
12. Dataset no Kaggle copiado de uma fonte institucional
Se o arquivo apenas reproduz dados de uma instituição:
fonte institucional → cópia disponibilizada no Kaggle.
Investigue a fonte primária e determine qual objeto precisa ser identificado para documentar adequadamente a análise.
13. Dataset derivado publicado no Kaggle
Se o publicador combinou, limpou ou transformou dados de terceiros:
fontes originais → transformação pelo publicador → dataset derivado no Kaggle.
A documentação deve preservar essa proveniência.
14. Dataset em repositório institucional
Modelo estrutural:
AUTOR/RESPONSÁVEL. Título do dataset. Versão. Nome do repositório institucional, ano. [DOI, Handle ou outro identificador].
Não transforme automaticamente a universidade que mantém o repositório em autora.
15. Dataset em Dataverse
Identifique os criadores e os metadados do registro específico:
AUTOR/RESPONSÁVEL. Título do dataset. Versão, quando pertinente. Dataverse/repositório responsável, ano. [identificador persistente].
16. Dataset no Figshare
Estrutura geral:
AUTOR/RESPONSÁVEL. Título do dataset. Versão. Figshare, ano. DOI: [DOI], quando existente.
Confira se o recurso está classificado como dataset e qual versão foi utilizada.
17. Dataset no Dryad
Estrutura adaptável:
AUTOR/RESPONSÁVEL. Título do dataset. Dryad, ano. DOI: [DOI].
Se houver versões, identifique o estado efetivamente analisado.
18. Dataset no OSF
Projetos no OSF podem conter vários componentes.
Identifique se você utilizou:
- o projeto;
- um registro;
- um arquivo;
- um conjunto de dados;
- documentação.
A referência deve corresponder ao objeto relevante.
Exemplos com IBGE e SIDRA
19. Tabela do SIDRA
Identifique:
- IBGE;
- pesquisa;
- número da tabela;
- título;
- período;
- consulta.
Na metodologia, registre os filtros efetivamente utilizados.
20. Dados do Censo
Não cite apenas “IBGE”.
Identifique o produto censitário utilizado e, conforme o caso:
- edição;
- tabela;
- arquivo;
- variáveis;
- recorte territorial.
21. Microdados de pesquisa do IBGE
Estrutura metodológica:
Foram utilizados microdados da [pesquisa], edição/período [X], disponibilizados pelo IBGE. Foram selecionados os arquivos [arquivos] e as variáveis [variáveis].
A referência identifica o recurso; a metodologia explica o recorte e o processamento.
22. Série histórica do IBGE
Registre:
- indicador;
- período;
- unidade;
- território;
- eventuais quebras metodológicas.
23. Arquivo XLSX do IBGE
Não cite “Excel” como fonte.
Identifique a pesquisa, tabela, série ou produto do qual a planilha faz parte.
Na metodologia:
Os dados foram obtidos em arquivo XLSX disponibilizado pelo IBGE […].
24. Dados do IBGE obtidos por API
Identifique a fonte institucional e documente:
- API;
- recurso;
- parâmetros;
- período;
- território;
- data da extração.
Exemplos com DATASUS
25. Dados do SIM
Identifique o Sistema de Informações sobre Mortalidade e documente o recorte.
Exemplo metodológico:
Foram utilizados dados do Sistema de Informações sobre Mortalidade (SIM), referentes a [localidade], no período de [X a Y], selecionados segundo [critérios].
26. Dados do SINASC
Identifique o Sistema de Informações sobre Nascidos Vivos e registre as variáveis e filtros pertinentes.
27. Dados do SIH/SUS
Informe que os registros utilizados são provenientes do Sistema de Informações Hospitalares do SUS e descreva o recorte analítico.
28. Dados do SIA/SUS
Identifique o Sistema de Informações Ambulatoriais do SUS e registre, conforme necessário:
- procedimentos;
- competências;
- território;
- estabelecimentos;
- filtros.
29. Dados do SINAN
Identifique o Sistema de Informação de Agravos de Notificação e o agravo ou grupo analisado.
Documente período, localidade e critérios de seleção.
30. Dados do CNES
Identifique o Cadastro Nacional de Estabelecimentos de Saúde e registre a competência ou período utilizado.
31. Microdados ou arquivos processados localmente do DATASUS
Registre:
- sistema;
- arquivos;
- período;
- data de obtenção;
- processamento;
- seleção de variáveis;
- tratamento.
Exemplos com Banco Mundial e APIs
32. Indicador do Banco Mundial
Identifique:
- instituição;
- nome do indicador;
- código;
- país ou território;
- período utilizado.
Evite registrar apenas “Banco Mundial”.
33. Indicador pertencente ao World Development Indicators
Quando pertinente, identifique a coleção e o indicador específico.
A metodologia deve explicar o recorte temporal e geográfico.
34. Dados do Banco Mundial obtidos por API
Registre a fonte e documente a consulta.
Exemplo metodológico:
Os dados foram recuperados por meio da API do Banco Mundial para o indicador [código], considerando [países] e o período [X a Y].
35. Resposta JSON de uma API
Não trate “JSON” como autor ou fonte.
A cadeia é:
fonte → API → requisição → resposta JSON.
Identifique a fonte e documente a requisição.
Exemplos com arquivos e GitHub
36. Arquivo CSV pertencente a um dataset
Identifique o dataset.
Na metodologia:
Foi utilizado o arquivo [nome.csv], integrante do dataset [título], obtido em [data].
37. Planilha Excel disponibilizada por instituição
Identifique a instituição e o produto representado pela planilha.
Não utilize “Microsoft Excel” como fonte.
38. Dataset em uma release do GitHub
Se a release representa uma versão formal do conjunto, registre:
- responsável;
- repositório;
- release;
- versão;
- data;
- arquivos pertinentes.
39. Dataset identificado por commit do GitHub
Quando não existe release e a análise depende de um estado específico, registre o commit de maneira apropriada na documentação metodológica ou técnica.
A cadeia pode ser:
repositório → commit → arquivos utilizados → análise.
40. Release do GitHub arquivada no Zenodo
Se a release foi arquivada com DOI, o registro persistente pode identificar a versão utilizada com maior estabilidade.
Documente também o GitHub quando ele for relevante para o histórico, código ou documentação.
Exemplos com dados próprios, restritos e derivados
41. Dados próprios não publicados
Não invente uma referência bibliográfica para uma planilha privada.
Explique na metodologia:
- coleta;
- participantes ou unidades;
- instrumento;
- período;
- tratamento;
- análise.
42. Dataset próprio publicado com DOI
Se os dados da pesquisa foram posteriormente depositados em repositório:
AUTOR/RESPONSÁVEL. Título do dataset. Versão. Repositório, ano. DOI: [DOI].
A metodologia continua necessária para explicar como os dados foram produzidos.
43. Dataset de acesso restrito
Quando os registros não são públicos, identifique o conjunto pelos metadados que podem ser divulgados e explique as condições de acesso.
Não exponha informações confidenciais.
44. Dataset dinâmico
Registre o estado utilizado por meio dos elementos disponíveis:
- versão;
- data de extração;
- snapshot;
- release;
- período;
- parâmetros.
45. Apenas parte de um dataset foi utilizada
Referencie o conjunto apropriado e descreva o recorte na metodologia.
Exemplo:
Do conjunto original foram selecionados apenas registros referentes a [população/período/território], conforme os critérios […].
46. Base criada pelo estudante a partir de IBGE e DATASUS
Preserve as duas fontes.
Exemplo de fonte de tabela:
Fonte: elaboração própria a partir de dados do IBGE e do [sistema do DATASUS].
Na metodologia, explique a integração.
47. Dataset derivado produzido por terceiro
Se você utiliza um conjunto que já foi transformado por outra pessoa:
fontes originais → processamento por terceiro → dataset derivado → sua análise.
Não elimine a camada intermediária quando ela altera materialmente os dados utilizados.
Exemplos com tabelas, gráficos, artigos e documentação
48. Tabela criada a partir de dados externos
Modelo adaptável:
Fonte: elaboração própria a partir de dados de [fonte], [período].
A referência completa da fonte deve aparecer conforme o padrão adotado no trabalho.
49. Gráfico criado a partir de indicador do Banco Mundial
Exemplo:
Fonte: elaboração própria a partir de dados do World Bank, indicador [código], [período].
Adapte a identificação ao recurso efetivamente utilizado.
50. Gráfico criado com dados de duas instituições
Exemplo:
Fonte: elaboração própria a partir de dados de [instituição A] e [instituição B].
A metodologia deve explicar como as séries foram compatibilizadas.
51. Artigo científico e dataset utilizados juntos
Faça referências separadas quando os dois objetos exercerem funções distintas.
O artigo pode fundamentar o método; o dataset pode fornecer os registros reanalisados.
52. Apenas o artigo foi utilizado
Se você não acessou ou reutilizou o dataset, não precisa afirmar que o utilizou.
Cite o artigo de acordo com a função que ele exerce no texto.
53. Dataset utilizado sem consultar artigo associado
Se o dataset é autossuficiente para sua finalidade e foi efetivamente utilizado, identifique-o adequadamente.
Entretanto, verifique se a documentação necessária para interpretar os dados está disponível.
54. Arquivo individual com identificador persistente
Quando um arquivo possui metadados e identificador próprios, ele pode exigir tratamento mais granular do que um arquivo comum dentro de um dataset.
Verifique como o repositório define o objeto.
55. README utilizado como fonte metodológica
Se uma definição, instrução ou descrição metodológica utilizada no TCC vem especificamente do README, esse documento pode exercer função de fonte.
Não confunda essa função com a do dataset que fornece os registros.
Exemplos metodológicos e técnicos avançados
56. Dicionário de dados utilizado para interpretar variáveis
Se o significado das variáveis depende de um dicionário ou codebook, registre adequadamente essa documentação.
Exemplo metodológico:
As categorias das variáveis foram interpretadas conforme o dicionário de dados disponibilizado pela instituição responsável.
57. API com paginação
Documente como todos os registros foram recuperados.
Exemplo:
A API retornava os registros de forma paginada; por isso, o script percorreu sucessivamente as páginas até atingir o total informado pela resposta.
Isso evita que uma extração parcial seja confundida com o conjunto completo.
58. API com dados atualizados em tempo real
Registre data e, quando necessário, horário da extração.
Preserve a resposta ou snapshot quando isso for permitido e importante para a reprodutibilidade.
59. Dataset corrigido depois da análise
Se a instituição publicou uma correção:
- identifique o que mudou;
- verifique se os registros utilizados foram afetados;
- avalie se os resultados precisam ser recalculados.
Não trate uma correção material como simples atualização bibliográfica.
60. Registros excluídos por dados ausentes
Exemplo metodológico:
Foram excluídos os registros sem informação para as variáveis [X] e [Y], resultando em uma base analítica com [N] observações.
Adapte a descrição ao procedimento realmente realizado.
61. Variável calculada pelo pesquisador
Exemplo:
A variável [X] foi calculada a partir das variáveis [A] e [B] por meio da expressão […].
Não atribua à fonte original uma variável que você criou.
62. Conversão de moeda
Exemplo metodológico:
Os valores originalmente expressos em [moeda A] foram convertidos para [moeda B] utilizando [fonte/taxa] referente a [período].
63. Valores deflacionados
Exemplo:
Os valores monetários foram convertidos para preços de [período-base] utilizando o índice [nome], obtido em [fonte].
Identifique separadamente a fonte dos valores e a fonte do índice quando forem diferentes.
64. Variáveis padronizadas
Exemplo:
As variáveis [X, Y e Z] foram padronizadas antes da análise por meio de [procedimento].
A transformação pertence à metodologia, não à referência do dataset.
65. Dataset utilizado em machine learning
Além de citar o conjunto, documente:
- versão;
- pré-processamento;
- divisão treino/validação/teste;
- balanceamento;
- variáveis;
- exclusões;
- transformações.
66. Dataset de imagens
Identifique o conjunto e documente, conforme necessário:
- classes;
- quantidade de imagens;
- seleção;
- anotações;
- pré-processamento;
- licença.
67. Dataset de textos
Identifique:
- origem;
- período;
- idioma;
- critérios de seleção;
- processamento textual;
- eventuais restrições.
68. Dataset geográfico
Além da fonte, registre quando relevante:
- ano da malha;
- sistema de referência de coordenadas;
- escala;
- resolução;
- recorte espacial;
- transformações geográficas.
69. Dataset atualizado depois que a análise foi concluída
Mantenha a correspondência entre a versão ou estado utilizado e os resultados apresentados.
Não substitua automaticamente a identificação pela versão mais recente.
70. Dataset corrigido depois que o TCC já estava praticamente finalizado
Primeiro determine se a correção afeta os dados utilizados.
Se não afetar, documente o estado analisado de maneira coerente.
Se afetar, avalie a necessidade de:
- refazer a extração;
- reprocessar a base;
- recalcular resultados;
- atualizar tabelas;
- atualizar gráficos;
- reavaliar conclusões.
Atenção
Uma referência atualizada não transforma automaticamente resultados antigos em resultados produzidos com os dados novos. Quando a fonte muda de maneira material, a consistência entre dados, método e resultado precisa ser reavaliada.
Regra prática para adaptar qualquer exemplo
Em vez de procurar um modelo idêntico ao seu caso, aplique esta sequência.
1. Identifique o responsável
Quem criou ou responde pelo objeto?
2. Identifique o título
Qual é o título oficial do dataset, base, tabela, série ou recurso?
3. Verifique data e versão
Qual estado dos dados participou da análise?
4. Procure DOI ou outro identificador
Existe DOI, Handle, código, URL persistente ou outro identificador útil?
5. Identifique o repositório, sistema ou ambiente
Onde o objeto está disponibilizado?
6. Registre como os dados foram obtidos
Download, API, consulta, microdados ou acesso controlado?
7. Monte a referência
Utilize os metadados reais do objeto.
8. Explique o uso na metodologia
Documente recorte, filtros, variáveis e tratamento.
9. Preserve a proveniência
Se os dados foram transformados ou combinados, mantenha a ligação com as fontes originais.
10. Confira as regras institucionais
Antes da entrega, verifique manual, biblioteca, programa, periódico ou orientações específicas aplicáveis ao seu trabalho.
Visão do especialista
O modelo deve se adaptar ao objeto. O objeto não deve ser deformado para caber no modelo.
Essa regra evita grande parte dos erros encontrados em referências de bases de dados e datasets.
Qual dos 70 exemplos devo usar?
Não escolha pelo formato visual da referência.
Escolha pela natureza do objeto.
| Se você utilizou… | Comece verificando… |
|---|---|
| Dataset científico com DOI | Exemplos 1 a 10 |
| Kaggle | Exemplos 11 a 13 |
| Repositórios científicos/institucionais | Exemplos 14 a 18 |
| IBGE/SIDRA | Exemplos 19 a 24 |
| DATASUS | Exemplos 25 a 31 |
| Banco Mundial/API | Exemplos 32 a 35 |
| CSV, Excel ou GitHub | Exemplos 36 a 40 |
| Dados próprios/restritos/derivados | Exemplos 41 a 47 |
| Tabelas, gráficos, artigos e documentação | Exemplos 48 a 55 |
| Situações metodológicas avançadas | Exemplos 56 a 70 |
Teste rápido antes de copiar qualquer modelo
Antes de adaptar um exemplo, responda:
- O responsável do meu recurso é realmente o mesmo tipo de responsável mostrado no exemplo?
- Estou citando um dataset, uma base, uma tabela, um arquivo, um artigo ou uma página?
- Existe versão?
- Existe DOI ou outro identificador?
- O DOI pertence realmente ao objeto utilizado?
- O repositório é diferente do autor?
- Os dados mudam com o tempo?
- Meu recorte precisa ser explicado na metodologia?
- Eu transformei os dados?
- A instituição possui orientação complementar?
Se você não consegue responder às primeiras perguntas, ainda não é hora de formatar a referência.
Volte aos metadados e identifique o objeto.
Em resumo
Os 70 exemplos mostram que não existe uma única fórmula capaz de representar qualquer fonte de dados. O caminho mais seguro é identificar o objeto, recuperar seus metadados, registrar versão e identificadores quando existirem, preservar a proveniência e utilizar a metodologia para explicar o percurso entre os dados originais e os resultados do TCC.
Como interpretar os 70 exemplos de citação de bases de dados e datasets
Os exemplos apresentados neste guia abrangem diferentes situações de uso de dados em trabalhos acadêmicos. Entretanto, existe um cuidado fundamental: um exemplo não deve ser utilizado como fórmula automática sem verificar a identidade do objeto consultado.
Uma referência construída para um dataset publicado com DOI pode não ser adequada para uma consulta dinâmica em sistema estatístico. Da mesma maneira, um modelo utilizado para microdados institucionais pode não representar corretamente um conjunto derivado publicado por pesquisadores.
Por isso, antes de copiar a estrutura de qualquer exemplo, identifique qual situação ele representa.
Os exemplos são modelos estruturais, não substitutos dos metadados reais
Quando um exemplo apresenta campos como [AUTOR], [TÍTULO], [ANO] ou [DOI], esses elementos precisam ser preenchidos com informações efetivamente verificadas.
Não se deve inventar:
- autoria;
- responsabilidade institucional;
- data de publicação;
- versão;
- identificador persistente;
- local de publicação;
- endereço eletrônico.
Se determinado elemento não estiver disponível, a solução deve respeitar as regras bibliográficas aplicáveis ao caso, e não simplesmente criar uma informação para completar o modelo.
Atenção
Os exemplos deste artigo têm finalidade didática. Para uma referência definitiva, confira os metadados do recurso e a edição aplicável da ABNT NBR 6023, além das orientações da instituição.
Como escolher o modelo de referência mais adequado ao seu caso?
O primeiro passo é identificar a natureza do objeto utilizado.
Uma decisão inadequada nessa etapa pode comprometer toda a referência, mesmo quando a pontuação e a apresentação parecem corretas.
Situação 1 — Dataset publicado em repositório científico
Esse caso ocorre quando um conjunto de dados possui registro próprio em ambientes como Zenodo, SciELO Data, Dataverse, Dryad ou outros repositórios.
Procure:
- criadores;
- título oficial;
- data;
- versão, quando existente;
- DOI ou outro identificador;
- repositório;
- arquivos disponibilizados.
O modelo deve identificar o dataset como objeto bibliográfico, sem confundi-lo com a página inicial do repositório.
Situação 2 — Consulta em base estatística institucional
Esse caso é frequente em sistemas governamentais e plataformas estatísticas.
O recurso utilizado pode ser:
- uma pesquisa;
- uma tabela;
- uma série;
- um indicador;
- uma consulta específica.
O modelo deve refletir o nível de identificação disponível.
Na metodologia, documente os parâmetros que definiram a extração.
Situação 3 — Arquivo baixado de um portal institucional
Um arquivo CSV, XLSX ou ZIP pode integrar uma publicação maior.
Antes de utilizar o nome do arquivo como título, verifique se existe um recurso oficial que o identifica.
Se houver um dataset ou pesquisa com título próprio, esse contexto pode ser bibliograficamente mais apropriado.
Situação 4 — Dados obtidos por API
Uma API pode disponibilizar registros de uma base institucional.
Nesse caso, diferencie:
- responsável pelos dados;
- recurso consultado;
- serviço de acesso;
- parâmetros utilizados;
- resposta obtida.
Não transforme automaticamente uma URL extensa de requisição em referência bibliográfica completa.
Situação 5 — Dataset publicado no GitHub
Verifique se o projeto contém dados, código ou ambos.
Procure:
- responsáveis;
- título do projeto;
- release;
- tag;
- commit relevante;
- DOI associado, quando existir;
- documentação de citação.
A identificação deve corresponder ao recurso utilizado.
Situação 6 — Dataset derivado de outras fontes
Quando um pesquisador transforma dados existentes e publica um novo conjunto, pode existir um objeto derivado com identidade própria.
Entretanto, a documentação deve preservar a proveniência das fontes originais.
Situação 7 — Dados próprios não publicados
Quando os registros foram produzidos pelo próprio estudante e não constituem uma publicação independente, a documentação pode concentrar-se na metodologia, conforme a natureza do estudo.
Não é necessário inventar uma referência bibliográfica para uma planilha interna apenas para preencher a lista de referências.
Situação 8 — Dados restritos
Se os dados não estão disponíveis publicamente, documente sua origem e condições de uso dentro dos limites éticos, legais e institucionais aplicáveis.
Não invente DOI ou URL pública.
Matriz prática: qual informação deve receber maior atenção?
| Situação | Principal cuidado bibliográfico | Principal cuidado metodológico |
|---|---|---|
| Dataset com DOI | Identificador e versão correta | Arquivos e recorte utilizados |
| Dataset sem DOI | Responsável, título e localização | Estado e extração |
| Base dinâmica | Identificação da fonte | Data e estado dos registros |
| SIDRA | Pesquisa e tabela | Variáveis, período e filtros |
| DATASUS/TABNET | Sistema e recurso | Consulta e recorte |
| Banco Mundial | Indicador e fonte | Países, anos e extração |
| Kaggle | Responsabilidade e proveniência | Versão e transformações |
| GitHub | Objeto e versão | Arquivos e processamento |
| API | Fonte e recurso | Endpoint, parâmetros e resposta |
| Dataset derivado | Identidade do conjunto publicado | Fontes e transformações |
| Dados próprios | Existência ou não de objeto publicado | Produção e tratamento |
| Dados restritos | Identificação permitida | Condições de acesso e proteção |
A matriz não substitui a análise do objeto. Ela serve para identificar quais elementos merecem atenção prioritária.
Exemplo comentado: quando duas referências aparentemente semelhantes identificam objetos diferentes
Imagine que uma pesquisa científica produza:
- um artigo publicado em periódico;
- um dataset depositado em repositório;
- um código de análise disponibilizado no GitHub.
Os três objetos podem ter:
- títulos diferentes;
- responsabilidades diferentes;
- datas diferentes;
- identificadores diferentes;
- versões diferentes.
Se você utilizou os resultados interpretativos do artigo
O artigo sustenta essa informação.
Se você reutilizou os registros
O dataset sustenta a análise.
Se você executou o código disponibilizado
O software ou código pode constituir outro objeto relevante para a documentação.
Não existe vantagem em substituir os três por uma única referência apenas porque pertencem ao mesmo projeto científico.
Visão do especialista
A pergunta correta não é “qual dessas referências parece mais acadêmica?”, mas “qual objeto efetivamente sustenta esta parte do meu trabalho?”.
Exemplo comentado: dataset atualizado depois da análise
Considere um dataset hipotético que possui três versões.
| Versão | Alteração | Situação |
|---|---|---|
| 1.0 | Publicação inicial | Dados originais |
| 1.1 | Correção de registros | Versão utilizada no TCC |
| 2.0 | Inclusão de novo período | Versão posterior |
O estudante realizou os cálculos com a versão 1.1.
Na etapa de redação, encontra a versão 2.0 como a mais recente.
Qual é o problema de citar apenas a versão 2.0?
O leitor pode tentar reproduzir a análise utilizando registros diferentes.
O que deve ser feito?
Identificar o estado efetivamente utilizado e verificar se existe um registro ou identificador correspondente à versão 1.1.
É necessário atualizar toda a pesquisa para a versão 2.0?
Não automaticamente.
Essa decisão depende dos objetivos, da metodologia e da relevância das alterações.
O essencial é não apresentar uma versão diferente como se tivesse produzido os resultados existentes.
Exemplo comentado: dataset sem DOI
Imagine que uma instituição disponibilize uma planilha estatística com:
- nome da instituição;
- título do recurso;
- ano;
- página oficial;
- arquivo XLSX.
O recurso não possui DOI.
Isso impede sua utilização?
Não necessariamente.
A ausência de DOI não significa ausência de responsabilidade ou impossibilidade de identificação.
Como proceder?
Utilize os elementos disponíveis para construir a referência conforme a natureza do recurso e as regras aplicáveis.
Na metodologia, registre o arquivo utilizado, a extração e os tratamentos relevantes.
O que não fazer?
Não crie um DOI fictício nem utilize o DOI de outra publicação apenas para completar um modelo.
Exemplo comentado: duas consultas diferentes na mesma tabela do SIDRA
Imagine que dois estudantes utilizem a mesma tabela do SIDRA.
O primeiro seleciona:
- Brasil;
- um período de dez anos;
- uma variável específica.
O segundo seleciona:
- um estado;
- um período de três anos;
- outra variável.
Ambos podem partir do mesmo recurso institucional, mas os conjuntos analíticos resultantes são diferentes.
A referência precisa reproduzir todos os filtros?
Não necessariamente.
A referência identifica o recurso, enquanto a metodologia documenta as escolhas que produziram cada extração.
Por que isso importa?
Porque a identificação da tabela, isoladamente, pode não permitir reproduzir os números apresentados no TCC.
Exemplo comentado: DATASUS e identificação do sistema correto
Imagine um estudante que deseja analisar informações relacionadas à mortalidade.
Ele utiliza dados disponibilizados em ambiente do DATASUS.
Uma descrição genérica seria:
Os dados foram obtidos no DATASUS.
Essa informação pode ser insuficiente para compreender o recurso efetivamente utilizado.
Uma descrição metodológica mais informativa identificaria:
- sistema de informação;
- indicador ou conteúdo;
- período;
- território;
- filtros;
- data da extração.
Se o recurso utilizado for o Sistema de Informações sobre Mortalidade, essa identificação é metodologicamente relevante.
O mesmo raciocínio vale para outros sistemas disponibilizados no ambiente.
Exemplo comentado: dataset do Kaggle que reproduz dados de outra instituição
Imagine que um usuário publique no Kaggle um conjunto baseado em registros de uma instituição pública.
O estudante baixa os arquivos do Kaggle e realiza sua análise.
Quem produziu os dados originais?
Essa informação deve ser investigada.
O usuário do Kaggle realizou transformações?
Se houve limpeza, integração, seleção ou criação de variáveis, essa etapa pode ser relevante.
É correto afirmar que os dados foram baixados diretamente da instituição?
Não, se o pesquisador efetivamente utilizou a versão intermediária disponibilizada no Kaggle.
Como preservar a proveniência?
Documente a origem declarada, o objeto efetivamente utilizado e as transformações conhecidas.
Quando pertinente, reconheça bibliograficamente os objetos que contribuíram para a pesquisa.
Exemplo comentado: API que retorna apenas a primeira página
Considere uma API que disponibiliza 20.000 registros, mas limita cada resposta a 500.
O pesquisador executa uma requisição e recebe uma resposta válida.
Entretanto, o script não percorre as páginas seguintes.
Qual é o problema?
A análise utiliza apenas parte dos registros esperados.
Uma referência correta resolveria essa falha?
Não.
A referência poderia identificar perfeitamente a fonte, mas o procedimento de coleta continuaria incompleto.
O que deveria ser verificado?
- documentação da paginação;
- quantidade total de registros;
- limites por resposta;
- mecanismo para recuperar páginas seguintes;
- quantidade efetivamente obtida.
Esse exemplo demonstra por que a qualidade metodológica não pode ser reduzida à formatação bibliográfica.
Exemplo comentado: combinação de datasets com períodos incompatíveis
Imagine uma pesquisa que combina:
- indicadores econômicos de 2024;
- indicadores educacionais de 2022;
- indicadores demográficos de 2025.
Os três conjuntos podem estar corretamente referenciados.
Entretanto, a integração exige uma justificativa metodológica.
Qual é o risco?
O pesquisador pode apresentar como simultâneas informações referentes a momentos diferentes.
O que deve ser explicado?
Dependendo do desenho:
- motivo da escolha dos períodos;
- compatibilidade temporal;
- tratamento das diferenças;
- limitações interpretativas.
Uma lista de referências completa não substitui essa explicação.
Exemplo comentado: dataset derivado com identidade própria
Imagine que um pesquisador combine duas fontes, elimine registros incompletos, crie indicadores e publique a base resultante em repositório científico.
O conjunto publicado recebe título e identificador próprios.
O dataset derivado pode ser citado?
Sim, quando constitui um objeto identificável pertinente à pesquisa.
As fontes originais deixam de importar?
Não.
Elas continuam integrando a proveniência.
O que deve aparecer na metodologia?
As informações necessárias para compreender as transformações e a relação entre os dados originais e o conjunto final.
Exemplo comentado: dados coletados pelo próprio estudante
Um estudante aplica questionários, organiza as respostas em planilha e produz tabelas para o TCC.
A planilha precisa receber uma referência bibliográfica independente?
Não automaticamente.
Se os dados não foram publicados como objeto separado, a metodologia pode ser o espaço principal para documentar sua produção.
O que precisa ser explicado?
Conforme o desenho:
- instrumento;
- participantes;
- critérios de seleção;
- procedimentos;
- período;
- tratamento;
- cuidados éticos.
E se os dados forem depositados posteriormente em repositório?
O depósito pode criar um objeto identificável que passa a admitir referência própria, conforme os metadados e a natureza da publicação.
Exemplo comentado: dados institucionais obtidos mediante autorização
Imagine que uma instituição permita ao estudante analisar registros internos, mas proíba sua divulgação pública.
É possível documentar a origem?
Sim, dentro dos limites autorizados.
É necessário publicar os registros?
Não se deve presumir essa obrigação.
Restrições legais, contratuais, éticas e institucionais precisam ser respeitadas.
O que não fazer?
Não invente endereço público, DOI ou disponibilidade irrestrita.
Também não publique informações confidenciais para tentar demonstrar reprodutibilidade.
O que cada exemplo deve ensinar sobre referência, citação e metodologia?
Os exemplos práticos podem ser analisados em três camadas principais.
Camada bibliográfica
Responde:
Qual objeto está sendo identificado?
Camada de atribuição
Responde:
Como a fonte é reconhecida no texto?
Camada metodológica
Responde:
Como os dados foram obtidos, selecionados e utilizados?
Em pesquisas que apresentam tabelas e gráficos, acrescenta-se uma quarta camada: a indicação da origem dos dados utilizados na visualização.
As camadas devem permanecer coerentes, mas não precisam repetir integralmente as mesmas informações.
Como comparar dois modelos antes de escolher um?
Quando encontrar dois exemplos aparentemente diferentes, não escolha automaticamente o mais curto ou o mais detalhado.
Compare os seguintes elementos:
- Os modelos identificam o mesmo tipo de objeto?
- Um deles foi elaborado para artigo e outro para dataset?
- A autoria está representada corretamente?
- Existe versão?
- Existe DOI?
- O identificador pertence ao objeto correto?
- O título corresponde ao recurso?
- O repositório foi confundido com autor?
- A data representa o evento correto?
- As regras institucionais exigem alguma apresentação específica?
Essa comparação evita a adaptação mecânica de modelos incompatíveis.
Por que um modelo de referência nunca deve inventar informações ausentes?
Uma referência deve representar o recurso real.
Se o dataset não apresenta versão, não se deve criar uma.
Se não possui DOI, não se deve utilizar o DOI de um artigo associado como substituto.
Se a autoria é institucional, não é necessário atribuir artificialmente a responsabilidade a uma pessoa.
Se a página não apresenta determinado elemento, sua ausência deve ser tratada conforme as regras aplicáveis.
Erro comum
Adaptar o objeto ao modelo em vez de adaptar o modelo às características verificadas do objeto.
Checklist de validação dos exemplos antes de utilizar no TCC
Antes de transformar um dos modelos deste artigo em referência definitiva, verifique:
- [ ] Identifiquei o objeto efetivamente utilizado.
- [ ] Confirmei os responsáveis.
- [ ] Registrei o título oficial.
- [ ] Verifiquei a data.
- [ ] Confirmei a versão, quando existente.
- [ ] Verifiquei DOI ou outro identificador.
- [ ] Confirmei a página do recurso.
- [ ] Não confundi plataforma e autoria.
- [ ] Não confundi dataset e artigo.
- [ ] Não confundi software e fonte dos dados.
- [ ] Registrei os arquivos utilizados.
- [ ] Documentei o recorte metodológico.
- [ ] Registrei as transformações relevantes.
- [ ] Mantive coerência entre referência e citação.
- [ ] Mantive coerência entre referência e metodologia.
- [ ] Conferi as orientações da instituição.
Síntese: o que os 70 exemplos demonstram?
Os diferentes cenários apresentados neste guia mostram que não existe uma única estrutura capaz de representar adequadamente todos os objetos de dados.
Um dataset versionado com DOI, uma tabela estatística dinâmica, um arquivo institucional, um conjunto do Kaggle e uma extração por API possuem características diferentes.
Por isso, a escolha do modelo deve partir da identificação do recurso.
Depois, é necessário verificar responsabilidade, título, data, versão, identificadores e localização.
Por fim, a metodologia deve explicar como os registros foram utilizados.
Em resumo
Os 70 exemplos não devem ser tratados como 70 fórmulas independentes para decorar. Eles representam aplicações de um mesmo princípio: identificar corretamente o objeto, atribuir sua responsabilidade, preservar sua versão ou estado e documentar o uso realizado na pesquisa.
O modelo deve se adaptar ao objeto. O objeto não deve ser deformado para caber no modelo.
Erros comuns ao citar base de dados e dataset nas normas ABNT
Os erros na citação de dados nem sempre aparecem na pontuação ou na ordem dos elementos da referência.
Muitos começam antes disso, quando o pesquisador identifica incorretamente o objeto utilizado, confunde plataforma com autoria, perde a versão analisada ou não documenta o caminho entre a fonte e os resultados.
Os 100 erros abaixo funcionam como uma auditoria prática para TCCs, monografias, dissertações, teses e artigos que utilizam bases de dados ou datasets.
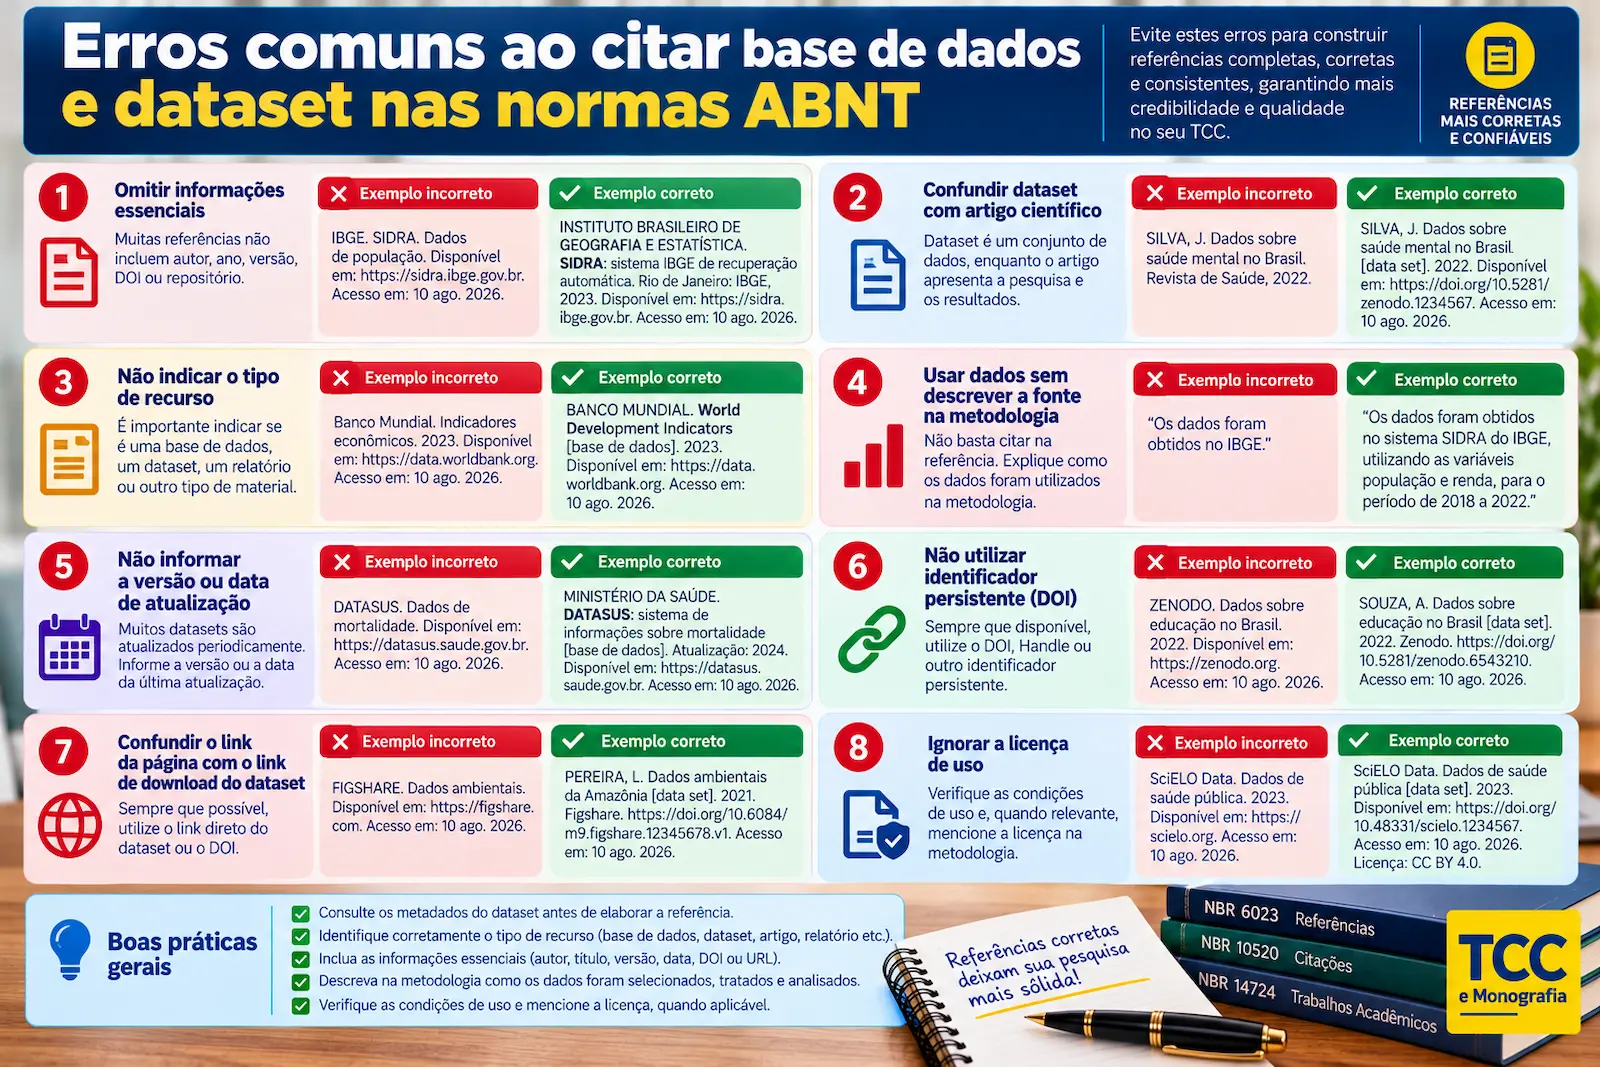
Erro 1 — Escrever apenas “Fonte: IBGE”
O IBGE disponibiliza inúmeros produtos.
Identifique, conforme o caso:
- pesquisa;
- censo;
- tabela;
- série;
- microdados;
- indicador;
- arquivo.
Erro 2 — Escrever apenas “Fonte: DATASUS”
Procure identificar o sistema que originou os registros, como SIM, SINASC, SIH/SUS, SIA/SUS, SINAN ou CNES, quando aplicável.
Erro 3 — Escrever apenas “Fonte: Banco Mundial”
Identifique o indicador ou recurso utilizado e preserve código, período e território quando relevantes.
Erro 4 — Confundir DATASUS com TABNET
O ambiente utilizado para tabular os dados e o sistema que originou os registros não devem ser tratados automaticamente como o mesmo objeto.
Erro 5 — Citar apenas a página inicial da instituição
Uma homepage genérica raramente identifica adequadamente o dataset, tabela ou recurso específico utilizado.
Erro 6 — Tratar Zenodo como autor automático
Zenodo pode ser o repositório, enquanto os criadores do dataset são outros responsáveis.
Erro 7 — Tratar SciELO Data como autor automático
O repositório e os responsáveis intelectuais pelo conjunto podem ser entidades diferentes.
Erro 8 — Tratar Kaggle como autor automático
Investigue quem produziu ou transformou os dados.
Erro 9 — Tratar GitHub como autor do dataset
GitHub é uma plataforma de hospedagem. Identifique os responsáveis pelo projeto ou recurso.
Erro 10 — Tratar Google como fonte dos dados
Encontrar um arquivo por meio de um mecanismo de busca não transforma o buscador no produtor da informação.
Erro 11 — Confundir dataset com página web
A página pode apenas apresentar ou disponibilizar o conjunto.
Identifique qual objeto está sendo efetivamente utilizado.
Erro 12 — Confundir dataset com arquivo baixado
Um CSV pode ser apenas um componente de um conjunto maior.
Erro 13 — Confundir dataset com artigo científico
Artigo e conjunto de dados podem estar relacionados, mas continuam sendo objetos distintos.
Erro 14 — Usar o DOI do artigo como se fosse o DOI do dataset
Verifique sempre a página de destino do identificador.
Erro 15 — Inventar um DOI
Nunca complete manualmente um identificador com base em padrões aparentes.
Utilize apenas o DOI efetivamente atribuído ao objeto.
Erro 16 — Inventar uma versão
Se o recurso não informa versão, não crie “v1.0” apenas para preencher a referência.
Erro 17 — Omitir uma versão materialmente relevante
Se diferentes versões contêm dados diferentes, a versão pode ser essencial para a rastreabilidade.
Erro 18 — Citar a versão mais recente em vez da versão analisada
A referência precisa permanecer coerente com os dados que produziram os resultados.
Erro 19 — Confundir identificador de versão com identificador do conjunto de versões
Quando o repositório distingue essas funções, escolha a granularidade adequada ao uso realizado.
Erro 20 — Achar que o identificador mais geral é sempre melhor
Para reprodução de uma análise, uma versão específica pode ser mais útil.
Erro 21 — Achar que o identificador mais específico é sempre obrigatório
A necessidade depende do objeto, do contexto e da função da referência.
Não transforme uma boa prática contextual em falsa regra universal.
Erro 22 — Ignorar que o dataset é dinâmico
Se a base muda continuamente, documente o estado utilizado.
Erro 23 — Não registrar a data de extração de uma base dinâmica
Sem essa informação, pode ser difícil reconstruir os valores analisados.
Erro 24 — Confundir data de acesso com data de extração
Elas podem coincidir, mas representam conceitos diferentes.
Erro 25 — Não preservar uma cópia dos dados extraídos quando isso é possível e apropriado
Em fontes dinâmicas, preservar o material bruto utilizado pode ajudar na rastreabilidade.
Erro 26 — Citar CSV como se “CSV” fosse a fonte
CSV é formato.
Identifique o dataset ou instituição responsável.
Erro 27 — Citar Excel como fonte
Excel pode ser ferramenta ou formato de trabalho, não necessariamente a origem dos dados.
Erro 28 — Citar JSON como fonte
JSON é formato de representação.
Identifique a API, dataset ou sistema que forneceu os registros.
Erro 29 — Confundir software com fonte dos dados
R, Python, SPSS, Stata ou Excel podem processar dados sem terem produzido esses dados.
Erro 30 — Colocar todos os parâmetros de uma API dentro da referência bibliográfica
Muitos detalhes técnicos pertencem à metodologia, ao script ou à documentação suplementar.
Erro 31 — Não registrar os parâmetros da API em lugar nenhum
Se os parâmetros definem quais registros foram obtidos, eles precisam ser preservados de forma apropriada.
Erro 32 — Ignorar paginação da API
O pesquisador pode recuperar apenas uma fração dos registros acreditando possuir o conjunto completo.
Erro 33 — Não registrar o período consultado
Isso é particularmente grave em séries temporais e bases atualizadas continuamente.
Erro 34 — Não registrar o território analisado
Brasil, estado, município, país ou região podem alterar completamente o significado do resultado.
Erro 35 — Não registrar as variáveis utilizadas
Em grandes datasets, o leitor precisa saber quais campos participaram da análise.
Erro 36 — Não registrar os filtros
Filtros podem alterar substancialmente a população analisada.
Erro 37 — Não registrar critérios de inclusão
O leitor precisa compreender quais registros entraram na análise.
Erro 38 — Não registrar critérios de exclusão
Exclusões podem alterar tamanho, composição e resultados da amostra.
Erro 39 — Ignorar o dicionário de dados
Nomes de variáveis nem sempre explicam adequadamente seu significado.
Erro 40 — Interpretar códigos sem consultar a documentação
Valores como 0, 9, 99 ou 999 podem representar categorias especiais e não valores quantitativos comuns.
Erro 41 — Ignorar mudanças metodológicas na série
Uma série histórica pode conter quebras de comparabilidade.
Erro 42 — Combinar bases sem explicar como
Documente chaves, critérios e procedimentos de integração.
Erro 43 — Perder a origem das variáveis depois de combinar datasets
Depois da junção, preserve qual fonte forneceu cada informação relevante.
Erro 44 — Chamar a base combinada de “dados próprios” sem reconhecer as fontes originais
O processamento pode ser seu; os dados de origem continuam tendo proveniência.
Erro 45 — Usar “elaboração própria” para esconder a origem dos dados
Se a tabela ou gráfico utiliza dados externos, reconheça essa origem.
Erro 46 — Atribuir à instituição um indicador calculado pelo pesquisador
Se você criou a variável, deixe claro que ela foi derivada dos dados originais.
Erro 47 — Não explicar como uma variável derivada foi calculada
Registre fórmula, unidades e procedimentos quando relevantes.
Erro 48 — Excluir registros sem documentar o critério
Isso prejudica a reprodutibilidade e pode esconder decisões analíticas importantes.
Erro 49 — Corrigir dados manualmente sem registrar as alterações
Correções precisam ser rastreáveis quando influenciam a análise.
Erro 50 — Sobrescrever o arquivo bruto
Quando possível e permitido, preserve o material original e trabalhe em cópias ou etapas derivadas.
Boa prática
Mantenha uma separação clara entre dados brutos → dados tratados → base analítica. Isso facilita auditoria, correções e reprodução do fluxo.
Erro 51 — Confundir dataset com software
O programa utilizado para analisar os registros não é o conjunto de dados.
Erro 52 — Confundir código-fonte com dataset
Um repositório pode conter os dois objetos.
Identifique cada um conforme sua função.
Erro 53 — Ignorar o README
Ele pode conter informações essenciais sobre origem, estrutura e limitações.
Erro 54 — Copiar a referência sugerida pelo README sem conferir os metadados
Verifique se ela corresponde à versão e ao objeto utilizados.
Erro 55 — Copiar CITATION.cff sem verificar o que ele descreve
O arquivo pode descrever software, dataset ou outro objeto do projeto.
Erro 56 — Achar que CITATION.cff é uma exigência da ABNT
Ele é uma ferramenta útil para metadados de citação, não uma condição universal para referências ABNT.
Erro 57 — Copiar automaticamente a referência gerada pelo repositório
Ferramentas automáticas ajudam, mas a saída precisa ser conferida e adaptada ao padrão utilizado.
Erro 58 — Tratar a licença como autoria
Licença informa condições de uso; não substitui os responsáveis pelo objeto.
Erro 59 — Achar que uma licença aberta elimina a necessidade de citar
Possibilidade de reutilização e atribuição bibliográfica são questões diferentes.
Erro 60 — Achar que dados públicos não precisam ser citados
A disponibilidade pública não elimina a proveniência.
Erro 61 — Achar que dados gratuitos não possuem condições de uso
Consulte licença e termos aplicáveis quando necessário.
Erro 62 — Confundir mantenedor com autor
Quem mantém um sistema não é necessariamente quem produziu o dataset.
Erro 63 — Confundir financiador com autor
Financiamento e responsabilidade intelectual são papéis diferentes.
Erro 64 — Confundir instituição afiliada com responsável pelo dataset
Confira os papéis declarados nos metadados.
Erro 65 — Omitir autoria institucional quando ela está claramente indicada
Não procure um autor pessoal artificialmente se a responsabilidade é institucional.
Erro 66 — Inventar autoria pessoal quando apenas a instituição é responsável
Utilize os metadados reais.
Erro 67 — Utilizar nome de usuário de plataforma como autoria sem verificar a proveniência
Um perfil pode apenas ter republicado dados de terceiros.
Erro 68 — Ignorar que o dataset é derivado
Procure compreender quais fontes e transformações produziram o conjunto utilizado.
Erro 69 — Citar apenas as fontes originais e ignorar uma transformação material feita por terceiro
Se você utilizou especificamente o conjunto transformado, essa camada pode ser relevante.
Erro 70 — Citar apenas o dataset derivado e apagar completamente as fontes originais
A proveniência precisa permanecer compreensível.
Erro 71 — Tratar dados restritos como se não pudessem ser citados
Um conjunto pode possuir metadados públicos mesmo quando os registros são protegidos.
Erro 72 — Expor informações confidenciais em nome da reprodutibilidade
Não publique dados, credenciais ou detalhes proibidos por obrigações éticas, legais ou contratuais.
Erro 73 — Publicar token ou chave de API
Credenciais privadas não pertencem à referência nem à metodologia pública.
Erro 74 — Citar uma planilha privada de dados próprios como se fosse publicação formal
Dados próprios não publicados são normalmente documentados principalmente na metodologia.
Erro 75 — Publicar um dataset próprio e continuar tratando-o como se não tivesse identidade bibliográfica
Quando o conjunto recebe título, metadados e identificador, ele pode passar a ser um produto citável.
Erro 76 — Confundir anonimização com ausência de proveniência
Dados anonimizados continuam tendo origem e percurso metodológico.
Erro 77 — Não documentar transformações realizadas antes da análise
Limpeza, recodificação, padronização e integração podem afetar resultados.
Erro 78 — Não registrar conversão de unidades
Se quilômetros foram convertidos em metros ou valores foram convertidos entre unidades, documente quando relevante.
Erro 79 — Não registrar conversão de moeda
Informe fonte da taxa, período e procedimento quando a transformação for material para a análise.
Erro 80 — Não registrar deflacionamento
Valores reais e nominais não devem ser confundidos.
Erro 81 — Não registrar ponderação
Em pesquisas amostrais, pesos podem ser essenciais para as estimativas.
Erro 82 — Ignorar desenho amostral
Uma referência correta não corrige uma análise que desconsidera características essenciais da amostra.
Erro 83 — Tratar microdados como se fossem uma tabela pronta
Microdados geralmente exigem seleção, interpretação e processamento.
Erro 84 — Não registrar tratamento de duplicidades
A remoção de duplicatas pode alterar o número de observações e os resultados.
Erro 85 — Não registrar tratamento de valores ausentes
Exclusão, imputação ou outras estratégias precisam ser explicadas quando relevantes.
Erro 86 — Fazer edições manuais sem manter registro
Alterações realizadas diretamente em planilhas podem ser difíceis de reproduzir.
Quando possível, documente ou automatize transformações importantes.
Erro 87 — Usar uma URL temporária de download como referência permanente
Prefira a página persistente do registro ou identificador estável quando disponível.
Erro 88 — Utilizar uma URL de sessão
Endereços gerados temporariamente por consultas podem deixar de funcionar.
Erro 89 — Confundir fonte abaixo da tabela com lista de referências
A indicação de fonte do elemento e a referência bibliográfica exercem funções relacionadas, mas diferentes.
Erro 90 — Colocar um dataset nas referências sem tê-lo utilizado
Não inclua recursos apenas para aumentar artificialmente a lista de fontes.
Erro 91 — Utilizar um dataset e não incluí-lo na documentação bibliográfica quando isso é necessário
Se o conjunto exerceu papel de fonte, sua identificação precisa ser preservada adequadamente.
Erro 92 — Achar que DOI é prova de qualidade
DOI facilita identificação persistente; não substitui avaliação metodológica.
Erro 93 — Achar que ausência de DOI torna o dataset inutilizável
Outros identificadores e metadados podem permitir documentação adequada.
Erro 94 — Ignorar erratas e correções
Antes da entrega final, verifique se houve atualização material do conjunto quando isso for relevante.
Erro 95 — Citar o conjunto inteiro quando a granularidade relevante é um arquivo identificado separadamente
Verifique como o repositório organiza seus objetos.
Erro 96 — Citar apenas o arquivo e perder a identidade do dataset
O problema inverso também ocorre.
Um arquivo comum dentro de um conjunto não deve necessariamente substituir a referência do dataset.
Erro 97 — Ignorar documentação metodológica do produtor
Sem compreender como os dados foram produzidos, o pesquisador pode interpretar variáveis ou limitações de maneira incorreta.
Erro 98 — Achar que existe uma única fórmula ABNT para qualquer dataset
Datasets variam em autoria, versão, identificadores, repositórios e formas de publicação.
O modelo precisa ser adaptado ao objeto real.
Erro 99 — Transformar boas práticas de ciência aberta em exigências universais da ABNT
DOI de versão, snapshots, scripts, repositórios persistentes e documentação de proveniência podem melhorar a rastreabilidade, mas nem todos esses elementos constituem automaticamente uma obrigação normativa universal para qualquer referência.
Erro 100 — Achar que uma referência perfeita substitui uma metodologia incompleta
Este é um dos erros mais importantes de todo o capítulo.
Uma referência pode identificar corretamente o dataset e ainda deixar sem resposta:
- qual período foi analisado;
- quais registros foram selecionados;
- quais variáveis foram utilizadas;
- quais filtros foram aplicados;
- quais transformações ocorreram;
- como os resultados foram calculados.
Por isso:
A referência identifica a fonte. A metodologia explica o percurso dos dados.
Auditoria rápida: sua citação de dados contém algum desses erros?
Antes de finalizar o trabalho, faça esta auditoria.
- Identifiquei o objeto exato que utilizei?
- Diferenciei instituição, autor e repositório?
- Confirmei o título oficial?
- Verifiquei se existe versão?
- Registrei a versão efetivamente analisada?
- Confirmei que o DOI pertence ao dataset?
- Verifiquei outros identificadores quando não há DOI?
- Evitei usar uma homepage genérica como única identificação?
- Registrei a data de extração quando a base é dinâmica?
- Documentei período, território e população?
- Registrei as variáveis utilizadas?
- Registrei filtros e critérios de seleção?
- Documentei exclusões e dados ausentes?
- Documentei transformações importantes?
- Preservei a origem ao combinar bases?
- Diferenciei dataset, artigo e software?
- Indiquei adequadamente a fonte de tabelas e gráficos?
- Conferi a referência automática fornecida pelo repositório?
- Verifiquei as orientações da minha instituição?
- Consigo reconstruir o caminho entre a fonte e o resultado?
Se alguma resposta for “não”, revise essa etapa antes da entrega.
Na prática
A melhor hora para descobrir que faltam versão, filtros ou data de extração é durante a pesquisa — não na noite anterior à entrega do TCC.
Como evitar erros ao citar datasets durante a pesquisa?
O método mais eficiente é não deixar a referência para o final.
Crie um registro para cada fonte de dados assim que ela entrar no projeto.
Ficha mínima de controle
| Campo | O que registrar |
|---|---|
| Responsável | Autor pessoal ou instituição |
| Título | Título oficial do recurso |
| Tipo de objeto | Dataset, base, tabela, arquivo, API etc. |
| Versão | Versão efetivamente utilizada |
| Data | Publicação/atualização pertinente |
| Identificador | DOI, Handle, código ou equivalente |
| Repositório/sistema | Onde o recurso está disponibilizado |
| Extração | Data e procedimento |
| Arquivos | Arquivos efetivamente utilizados |
| Período | Recorte temporal |
| Território | Recorte geográfico |
| Variáveis | Campos utilizados |
| Filtros | Critérios aplicados |
| Transformações | Limpeza, junções, cálculos etc. |
| Software/script | Ferramentas relevantes |
| Observações | Limitações, correções, decisões |
Salve os metadados junto com os dados
Uma estrutura de projeto pode separar:
- dados brutos;
- dados tratados;
- scripts;
- documentação;
- metadados;
- resultados.
O objetivo não é impor uma organização única, mas impedir que a origem dos arquivos seja perdida.
Não renomeie arquivos sem preservar a identificação original
Transformar:
dados_2025_versao_2.csv
em:
planilha_final.csv
pode parecer conveniente, mas pode destruir informações úteis se nenhum registro adicional for mantido.
Se precisar renomear arquivos, preserve a correspondência com a origem.
Registre transformações em vez de depender da memória
Se você:
- excluiu 127 registros;
- corrigiu códigos;
- converteu moedas;
- agregou municípios;
- criou indicadores,
registre essas etapas enquanto trabalha.
Automatize quando fizer sentido
Scripts podem melhorar a reprodutibilidade de transformações repetitivas.
Isso não significa que toda pesquisa precise programar.
Se o tratamento for manual, documente adequadamente as decisões importantes.
Teste final de rastreabilidade do dataset
Antes de considerar a documentação concluída, tente percorrer esta cadeia:
instituição ou responsável → dataset/base → versão ou estado → arquivos/consulta → recorte → transformação → base analítica → resultado.
Agora responda às perguntas abaixo.
1. Consigo identificar a origem?
Se você não consegue dizer quem produziu ou responde pelos dados, existe uma lacuna.
2. Consigo identificar o objeto?
Você sabe se utilizou:
- dataset;
- base;
- tabela;
- microdados;
- arquivo;
- API;
- dataset derivado?
3. Consigo identificar o estado utilizado?
Versão, release, commit, data de extração ou outro elemento permite situar os dados?
4. Consigo reconstruir o recorte?
Estão registrados:
- período;
- território;
- população;
- variáveis;
- filtros?
5. Consigo reconstruir as transformações?
Está claro o que ocorreu entre os dados originais e a base analítica?
6. Consigo ligar a base analítica aos resultados?
É possível compreender quais dados produziram cada tabela, gráfico, indicador ou modelo?
7. As referências correspondem aos objetos realmente utilizados?
Verifique se não existem referências de:
- versões diferentes;
- artigos no lugar de datasets;
- homepages no lugar de recursos;
- plataformas no lugar de autores;
- arquivos que não foram utilizados.
8. A metodologia corresponde ao processamento realmente realizado?
Remova procedimentos que não foram executados e acrescente etapas relevantes que estejam faltando.
9. Tabelas e gráficos preservam a origem dos números?
Confira se “elaboração própria” não apagou as fontes externas.
10. Outra pessoa compreenderia o percurso dos dados?
Esse é o teste final.
Visão do especialista
Uma boa documentação de dados não é aquela que acumula o maior número possível de elementos. É aquela que permite compreender, com precisão proporcional à pesquisa, de onde vieram os dados, qual estado foi utilizado, o que aconteceu com eles e como chegaram aos resultados apresentados.
A regra que evita a maioria dos erros
Quando surgir dúvida sobre onde colocar uma informação, volte às quatro funções:
| Elemento | Função principal |
|---|---|
| Referência | Identificar o objeto utilizado |
| Citação | Atribuir informação ou dado à fonte |
| Metodologia | Explicar como os dados foram obtidos e utilizados |
| Fonte de tabela/gráfico | Indicar a origem dos dados apresentados no elemento |
Essas funções se complementam.
Não tente fazer uma única referência carregar todo o histórico metodológico da pesquisa.
Da mesma forma, não utilize uma metodologia detalhada como justificativa para deixar o dataset sem identificação bibliográfica adequada.
Em resumo
Grande parte dos erros ao citar bases de dados nasce da identificação incorreta do objeto ou da perda de proveniência. Verifique autoria, título, versão, DOI ou outro identificador, fonte de acesso, data de extração quando pertinente, recorte, transformações e correspondência com os resultados. O objetivo não é produzir uma referência artificialmente longa, mas construir uma documentação coerente do início ao fim da pesquisa.
Como diagnosticar os erros mais graves ao citar bases de dados e datasets?
Os erros de referência e citação de dados nem sempre são problemas de pontuação, ordem dos elementos ou apresentação bibliográfica.
Em muitos casos, o problema começa antes: o pesquisador não identifica corretamente o objeto utilizado, confunde responsabilidades ou deixa de registrar informações fundamentais sobre a obtenção dos dados.
Por isso, a revisão deve considerar duas dimensões complementares:
- correção bibliográfica: a referência representa adequadamente o recurso utilizado?
- rastreabilidade metodológica: a documentação permite compreender como os dados foram obtidos e utilizados?
Uma referência pode estar visualmente bem formatada e, ainda assim, apontar para o objeto errado.
Da mesma forma, um dataset pode estar corretamente identificado, mas a metodologia pode omitir filtros, versões ou transformações essenciais.
Visão do especialista
Antes de revisar vírgulas, pontos e destaques tipográficos, confirme se a referência identifica o objeto certo. A correção formal não compensa um erro de identidade bibliográfica.
Erros de identidade bibliográfica: quando a referência aponta para o objeto errado
Essa categoria reúne problemas que comprometem a correspondência entre a referência e o recurso efetivamente utilizado.
Erro 1 — Citar a plataforma no lugar do dataset
O estudante utiliza um conjunto de dados publicado em repositório científico, mas referencia apenas a página inicial da plataforma.
Consequência: o leitor pode não conseguir localizar o conjunto específico.
Correção: identificar o registro do dataset, seus responsáveis, título, data, versão e identificador, quando disponíveis.
Erro 2 — Citar o artigo associado no lugar do dataset
O pesquisador reutiliza registros disponibilizados separadamente, mas referencia somente o artigo que descreve a pesquisa.
Consequência: a origem dos registros analisados fica parcialmente oculta.
Correção: reconhecer o dataset como objeto próprio quando ele foi efetivamente utilizado.
Erro 3 — Utilizar o DOI de outro objeto
Um DOI pode pertencer ao artigo, ao dataset, a uma versão específica ou a outro recurso relacionado.
Consequência: o identificador conduz a um objeto diferente daquele descrito na referência.
Correção: abrir o DOI e verificar o registro de destino antes de finalizar a referência.
Erro 4 — Transformar o nome do arquivo em título oficial
Um arquivo denominado dados_finais.csv pode integrar um dataset cujo título oficial é completamente diferente.
Consequência: a referência perde correspondência com os metadados publicados.
Correção: verificar o título do recurso e registrar o nome do arquivo na metodologia quando pertinente.
Erro 5 — Confundir instituição hospedeira e autoria
Uma universidade pode hospedar um dataset produzido por pesquisadores específicos.
Consequência: a responsabilidade intelectual pode ser atribuída incorretamente.
Correção: diferenciar criadores, publicadores, mantenedores e repositório.
Erros de versionamento: quando a referência identifica um estado diferente dos dados
O versionamento merece atenção especial em pesquisas que utilizam datasets atualizados ao longo do tempo.
Erro 6 — Citar a versão mais recente em vez da utilizada
O pesquisador analisa a versão 1.2 e, posteriormente, referencia a versão 2.0 porque ela aparece como atual.
Consequência: o leitor pode tentar reproduzir os resultados com dados diferentes.
Correção: identificar a versão efetivamente utilizada.
Erro 7 — Confundir versão da API com versão dos dados
Uma API pode manter a mesma versão técnica enquanto os registros são atualizados.
Consequência: a documentação não identifica o estado analisado.
Correção: registrar separadamente o mecanismo de acesso e o estado ou a extração dos dados.
Erro 8 — Omitir a data de extração de uma base dinâmica
Em fontes sujeitas a atualização, a ausência dessa informação pode dificultar a interpretação de diferenças entre consultas.
Correção: registrar a extração quando ela for metodologicamente relevante.
Erro 9 — Substituir silenciosamente arquivos durante a redação
O estudante baixa novamente o dataset e sobrescreve os arquivos anteriores.
Consequência: perde-se a correspondência entre os dados originalmente analisados e os arquivos disponíveis no projeto.
Correção: preservar o conjunto utilizado e documentar eventuais atualizações.
Atenção
A versão mais recente nem sempre é a versão que deve representar uma análise já realizada. A identificação precisa corresponder aos dados que efetivamente produziram os resultados.
Erros de proveniência: quando a origem dos registros desaparece
Proveniência é o conjunto de informações que permite compreender de onde os dados vieram e quais transformações sofreram.
Erro 10 — Citar apenas o Kaggle sem investigar a origem
Um dataset pode ter sido republicado por usuário que não produziu os registros originais.
Correção: investigar a descrição, a documentação, a fonte declarada e eventuais transformações.
Erro 11 — Apresentar dados transformados como se fossem os originais
Uma versão intermediária pode ter eliminado registros, alterado categorias ou criado variáveis.
Correção: documentar a etapa intermediária quando ela participa da cadeia de produção do conjunto utilizado.
Erro 12 — Combinar bases e citar apenas uma delas
O pesquisador utiliza duas fontes para construir um indicador, mas reconhece somente uma.
Correção: preservar a identificação das fontes relevantes e explicar o procedimento de integração.
Erro 13 — Atribuir à instituição um indicador criado pelo pesquisador
Uma tabela apresenta um índice calculado pelo estudante a partir de registros externos, mas sugere que o índice foi publicado diretamente pela instituição.
Correção: diferenciar dados de entrada, cálculo e elaboração do resultado.
Erro 14 — Não documentar transformações relevantes
Operações como agregação, recodificação e exclusão de registros podem alterar os resultados.
Correção: descrever as decisões metodológicas relevantes e preservar scripts ou documentação complementar quando apropriado.
Erros de extração: quando a consulta não representa o conjunto pretendido
Essa categoria envolve falhas na obtenção dos dados.
Erro 15 — Selecionar o período incorreto
Uma consulta pode retornar dados de anos diferentes dos pretendidos.
Correção: conferir os períodos solicitados e os efetivamente retornados.
Erro 16 — Selecionar território inadequado
Confundir município, estado, região ou agregado nacional pode comprometer comparações.
Correção: validar códigos e níveis territoriais.
Erro 17 — Ignorar classificações e categorias
Uma tabela pode apresentar diversas categorias, e a seleção de apenas uma altera o conjunto analisado.
Correção: registrar filtros, classificações e categorias relevantes.
Erro 18 — Recuperar somente a primeira página de uma API
Uma resposta válida pode conter apenas parte dos registros.
Correção: verificar paginação, quantidade total e completude da extração.
Erro 19 — Confundir resposta vazia com inexistência de dados
Uma consulta vazia pode decorrer de erro de parâmetro, autenticação, limitação ou falha temporária.
Correção: validar a requisição e consultar a documentação técnica.
Erro 20 — Não conferir o arquivo exportado
O pesquisador presume que a exportação corresponde exatamente à seleção realizada.
Correção: conferir estrutura, quantidade de registros, variáveis e período antes da análise.
Erros de interpretação: quando os números são utilizados fora de contexto
Uma referência correta não garante interpretação adequada.
Erro 21 — Confundir quantidade e taxa
Valores absolutos e indicadores relativos representam medidas diferentes.
Correção: verificar a definição oficial da variável e a unidade.
Erro 22 — Ignorar mudanças metodológicas em séries históricas
Uma série pode apresentar rupturas de classificação ou revisão de procedimentos.
Correção: consultar notas metodológicas e avaliar a comparabilidade.
Erro 23 — Interpretar códigos sem dicionário
Valores numéricos podem representar categorias e não quantidades.
Correção: utilizar a documentação correspondente ao dataset e à edição analisada.
Erro 24 — Ignorar pesos ou desenho amostral quando necessários
Microdados de pesquisas amostrais podem exigir procedimentos específicos de análise.
Correção: seguir a documentação metodológica e empregar técnicas adequadas ao desenho da pesquisa.
Erro 25 — Tratar ausência de registro como valor zero
Uma célula vazia pode representar ausência de informação, supressão, não aplicabilidade ou outra condição.
Correção: verificar o significado dos valores especiais antes de transformá-los.
Erros de documentação: quando a pesquisa não pode ser reconstruída
Mesmo que a análise tenha sido executada corretamente, a ausência de documentação pode impedir que outras pessoas compreendam o procedimento.
Erro 26 — Metodologia genérica
Exemplo insuficiente:
Os dados foram coletados em fontes oficiais e analisados em planilhas.
Correção: identificar fontes, recortes, extração, variáveis e tratamentos relevantes.
Erro 27 — Referência excessivamente detalhada e metodologia vazia
O pesquisador tenta inserir todos os filtros na referência, mas não explica como os dados foram utilizados.
Correção: distribuir as informações entre identificação bibliográfica e documentação metodológica.
Erro 28 — Omitir os arquivos utilizados
Um dataset contém diversos arquivos, mas o estudante não informa quais foram analisados.
Correção: registrar os componentes relevantes na metodologia.
Erro 29 — Não preservar documentação técnica
O pesquisador utiliza um dicionário de variáveis, mas não guarda sua identificação ou versão.
Correção: manter documentação correspondente ao estado analisado.
Erro 30 — Não registrar exclusões
Registros são removidos durante a limpeza, mas não existe justificativa.
Correção: documentar critérios e, quando pertinente, quantidades antes e depois do tratamento.
Erros éticos e de acesso: quando a documentação ultrapassa os limites permitidos
A busca por rastreabilidade não elimina responsabilidades relacionadas à proteção dos dados.
Erro 31 — Divulgar informações confidenciais
O pesquisador publica registros protegidos para demonstrar a origem dos resultados.
Correção: respeitar condições de acesso e divulgar apenas informações permitidas.
Erro 32 — Expor credenciais de API
Chaves e tokens podem permitir acesso indevido ou gerar custos.
Correção: documentar o método de autenticação sem divulgar segredos.
Erro 33 — Presumir que dados públicos podem ser redistribuídos sem restrições
Disponibilidade para consulta não equivale automaticamente a autorização irrestrita de reutilização.
Correção: verificar licença e condições de uso.
Erro 34 — Afirmar anonimização sem avaliação adequada
A remoção de identificadores diretos pode ser insuficiente para impedir reidentificação.
Correção: avaliar os riscos e seguir as exigências éticas, legais e institucionais aplicáveis.
Atenção
Rastreabilidade científica não autoriza a divulgação de dados pessoais, arquivos confidenciais ou credenciais protegidas. A documentação deve respeitar os limites aplicáveis à pesquisa.
Matriz de gravidade: quais erros devem ser corrigidos primeiro?
Nem todos os problemas apresentam o mesmo impacto.
Uma referência com detalhe tipográfico inadequado exige correção, mas pode representar um risco menor do que utilizar o dataset errado ou perder a proveniência dos registros.
| Problema | Impacto principal | Prioridade sugerida |
|---|---|---|
| Objeto bibliográfico errado | Identificação incorreta da fonte | Crítica |
| DOI de outro objeto | Direcionamento incorreto | Crítica |
| Versão incompatível | Resultados potencialmente diferentes | Crítica |
| Extração incompleta | Base analítica incorreta | Crítica |
| Exposição de dados protegidos | Risco ético, legal ou contratual | Crítica |
| Fonte original omitida | Perda de proveniência | Alta |
| Filtros não documentados | Baixa rastreabilidade | Alta |
| Transformações não documentadas | Dificuldade de reconstrução | Alta |
| Data de extração ausente em base dinâmica | Estado dos dados incerto | Alta |
| Pequena inconsistência tipográfica | Problema formal | Revisão final |
Essa matriz é uma ferramenta editorial de priorização, não uma classificação oficial estabelecida pela ABNT.
Procedimento de correção: como revisar uma referência problemática?
Quando uma referência de dataset apresenta inconsistências, é recomendável corrigir o problema a partir da fonte original.
Etapa 1 — Identifique o objeto
Determine se o recurso é um dataset, artigo, tabela, sistema, arquivo, software ou outro objeto.
Etapa 2 — Abra o registro oficial
Evite depender exclusivamente de referências copiadas de outros trabalhos.
Etapa 3 — Confira a responsabilidade
Verifique criadores, instituição e demais funções apresentadas nos metadados.
Etapa 4 — Confira título e data
Utilize informações correspondentes ao objeto.
Etapa 5 — Confira versão e identificador
Certifique-se de que o DOI, Handle ou URL conduz ao recurso correto.
Etapa 6 — Compare com os arquivos utilizados
Verifique se a referência representa o conjunto efetivamente analisado.
Etapa 7 — Revise a metodologia
Confirme período, território, variáveis, filtros, extração e transformações.
Etapa 8 — Revise tabelas e gráficos
Verifique se a indicação da fonte reconhece adequadamente os dados externos.
Etapa 9 — Ajuste a apresentação bibliográfica
Somente depois de confirmar a identidade e a coerência do recurso, revise os elementos formais conforme as normas aplicáveis.
Etapa 10 — Faça uma verificação cruzada
Compare referência, citação no texto, metodologia e indicação de fonte das visualizações.
Auditoria cruzada: referência, citação, metodologia e resultados
Uma pesquisa pode apresentar quatro camadas documentais que precisam ser coerentes.
| Camada | Pergunta de auditoria |
|---|---|
| Referência | Qual recurso foi utilizado? |
| Citação no texto | Como sua contribuição é reconhecida? |
| Metodologia | Como os registros foram obtidos e tratados? |
| Resultados | Como os dados sustentam tabelas, gráficos e conclusões? |
Inconsistência entre referência e metodologia
A referência identifica um dataset versionado, mas a metodologia descreve uma consulta dinâmica a outro sistema.
É necessário verificar se houve confusão de fontes.
Inconsistência entre metodologia e resultados
A metodologia informa um período, enquanto os gráficos apresentam outro.
É necessário revisar o recorte.
Inconsistência entre tabela e referência
A tabela apresenta dados combinados de duas instituições, mas apenas uma é reconhecida.
É necessário revisar a proveniência.
Inconsistência entre DOI e título
O DOI direciona para um artigo, mas a referência apresenta um dataset.
É necessário identificar o objeto correto.
Boa prática
Faça a auditoria cruzada depois da revisão formal. Ela pode revelar problemas de identidade e metodologia que não aparecem durante a conferência isolada da lista de referências.
Checklist de emergência: 20 erros que não devem permanecer no TCC
Antes de entregar o trabalho, confirme:
- [ ] Nenhum dataset foi substituído pela página inicial do repositório.
- [ ] Nenhum DOI pertence a objeto diferente.
- [ ] Nenhuma versão posterior foi apresentada como a utilizada.
- [ ] Nenhuma instituição hospedeira foi confundida automaticamente com autoria.
- [ ] Nenhum arquivo local foi tratado como título oficial sem verificação.
- [ ] Nenhuma fonte original relevante foi omitida.
- [ ] Nenhuma transformação importante ficou sem documentação.
- [ ] Nenhum recorte temporal foi apresentado incorretamente.
- [ ] Nenhum território foi confundido.
- [ ] Nenhuma variável foi interpretada sem documentação adequada.
- [ ] Nenhuma API foi considerada completa sem verificar paginação.
- [ ] Nenhum valor ausente foi automaticamente tratado como zero.
- [ ] Nenhuma base foi combinada sem avaliar compatibilidade.
- [ ] Nenhum indicador derivado foi atribuído incorretamente à fonte.
- [ ] Nenhuma tabela perdeu a identificação dos dados externos.
- [ ] Nenhum dado restrito foi divulgado indevidamente.
- [ ] Nenhuma credencial de acesso foi publicada.
- [ ] Nenhuma URL ou DOI foi inventado.
- [ ] Nenhuma referência ficou desconectada da metodologia.
- [ ] Nenhum resultado depende de arquivos cuja origem não possa ser identificada.
Síntese dos erros comuns: o que deve ser corrigido antes da formatação?
Os erros mais graves em referências de bases de dados frequentemente não começam na apresentação bibliográfica.
Eles começam quando o pesquisador:
- identifica o objeto errado;
- confunde autoria e hospedagem;
- utiliza identificador incompatível;
- omite a versão analisada;
- perde a proveniência;
- documenta inadequadamente a extração;
- não registra transformações;
- apresenta resultados sem reconhecer a origem dos registros.
Por isso, a ordem de revisão mais segura é:
identidade do objeto → responsabilidade → versão/estado → identificador → proveniência → metodologia → coerência das citações → apresentação bibliográfica.
Essa sequência não representa uma ordem normativa obrigatória da ABNT. É um procedimento prático de auditoria para reduzir erros relevantes.
Em resumo
Uma boa revisão não pergunta apenas se a referência está formatada corretamente. Ela verifica se o recurso foi identificado, se a versão corresponde aos dados utilizados, se a proveniência foi preservada e se a metodologia permite compreender o caminho entre a fonte e os resultados.
Corrigir a pontuação é importante. Corrigir o objeto errado é indispensável.
Como citar base de dados e dataset nas normas ABNT: passo a passo definitivo
Depois de compreender as diferenças entre base de dados, dataset, repositório, arquivo, artigo, software e documentação, podemos transformar todo o processo em uma sequência prática.
O objetivo deste passo a passo não é criar uma fórmula rígida para qualquer fonte de dados.
Ele funciona como um roteiro de decisão para que você identifique corretamente o objeto, monte a referência e documente o uso dos dados na metodologia.
Passo 1 — Identifique exatamente o objeto utilizado
Antes de formatar qualquer referência, responda:
- é um dataset?
- uma base de dados?
- uma tabela?
- uma série histórica?
- um conjunto de microdados?
- um arquivo específico?
- uma API?
- um dataset derivado?
- um artigo que descreve os dados?
- uma documentação metodológica?
Essa identificação é a base de todas as decisões seguintes.
Atenção
Se você ainda não sabe qual objeto utilizou, não comece copiando um modelo de referência. Primeiro resolva a identidade da fonte.
Passo 2 — Identifique quem é responsável pelo objeto
Procure nos metadados:
- autores;
- criadores;
- instituição responsável;
- contribuidores;
- mantenedores.
Não confunda automaticamente:
- repositório com autor;
- plataforma com produtor;
- financiador com criador;
- instituição afiliada com responsável pelo dataset.
Passo 3 — Registre o título oficial
Utilize o título apresentado nos metadados do recurso.
Não substitua o título oficial pelo nome local do arquivo salvo no computador.
Por exemplo:
dados_final_v2.csv
pode ser apenas o nome do arquivo, e não o título bibliográfico do dataset.
Passo 4 — Verifique a data
Identifique qual data está sendo apresentada:
- publicação;
- criação;
- atualização;
- release;
- extração;
- acesso.
Essas datas não exercem necessariamente a mesma função.
Passo 5 — Verifique se existe versão
Procure:
- versão explícita;
- release;
- edição;
- commit;
- snapshot;
- estado temporal identificável.
Se não houver versão, não invente uma.
Passo 6 — Procure DOI ou outro identificador persistente
Verifique se o objeto possui:
- DOI;
- Handle;
- ARK;
- identificador institucional;
- código de tabela;
- código de indicador;
- URL persistente.
Se houver DOI, confirme que ele pertence ao objeto efetivamente utilizado.
Passo 7 — Identifique o repositório, sistema ou ambiente de acesso
Exemplos:
- Zenodo;
- SciELO Data;
- Dataverse;
- Figshare;
- Dryad;
- OSF;
- SIDRA;
- DATASUS;
- Kaggle;
- GitHub;
- repositório institucional.
Lembre-se: ambiente de acesso e autoria são dimensões diferentes.
Passo 8 — Registre como os dados foram obtidos
Os registros vieram de:
- download direto;
- API;
- consulta interativa;
- microdados;
- exportação;
- acesso controlado;
- coleta própria?
Essa informação será especialmente útil na metodologia.
Passo 9 — Defina o recorte utilizado
Registre:
- período;
- território;
- população;
- unidade de análise;
- variáveis;
- filtros;
- critérios de inclusão;
- critérios de exclusão.
Passo 10 — Registre as transformações
Documente as etapas que possam afetar a interpretação ou reprodução dos resultados:
- limpeza;
- remoção de duplicidades;
- tratamento de ausentes;
- recodificação;
- conversão de unidades;
- conversão monetária;
- deflacionamento;
- padronização;
- junção de bases;
- criação de variáveis;
- correções.
Passo 11 — Monte a referência
Somente depois das etapas anteriores monte a referência bibliográfica.
Utilize os metadados reais do objeto e adapte a estrutura ao padrão adotado.
Não tente transportar toda a metodologia para dentro da referência.
Passo 12 — Faça a citação no texto
Quando dados, informações ou afirmações provenientes do conjunto forem utilizados no texto, faça a atribuição correspondente conforme o sistema de citação adotado.
A citação no texto e a referência precisam apontar de forma coerente para o mesmo responsável ou objeto.
Passo 13 — Explique o uso dos dados na metodologia
A metodologia deve responder:
- de onde vieram os dados;
- como foram obtidos;
- qual recorte foi utilizado;
- como foram tratados;
- como foram analisados.
Passo 14 — Preserve a origem em tabelas e gráficos
Se você criou uma tabela ou gráfico a partir de dados externos, não apague sua proveniência sob a expressão “elaboração própria”.
Uma estrutura adaptável é:
Fonte: elaboração própria a partir de dados de [fonte].
Passo 15 — Faça uma auditoria de correspondência
Antes da entrega, verifique se:
- a versão citada é a versão analisada;
- o DOI pertence ao dataset;
- os arquivos mencionados foram realmente utilizados;
- os filtros descritos correspondem ao processamento;
- as tabelas correspondem à base analítica;
- as referências correspondem às fontes efetivamente utilizadas.
Em resumo
O passo a passo definitivo não começa pela pontuação da referência. Ele começa pela identificação do objeto e termina pela verificação da correspondência entre fonte, método e resultado.
Matriz de decisão: o que devo citar?
Use a tabela abaixo como ponto de partida para identificar o objeto principal e as informações metodológicas complementares.
| Situação | Objeto principal a identificar | O que complementar na metodologia |
|---|---|---|
| Dataset científico com DOI | Dataset | Versão, recorte e tratamento utilizados |
| Tabela do SIDRA | Tabela/recurso do IBGE | Filtros, período, território e variáveis |
| Microdados do IBGE | Pesquisa/conjunto de microdados | Arquivos, variáveis, período, pesos e tratamento |
| Consulta pelo TABNET | Sistema/fonte dos dados | Configuração da consulta e recorte |
| Dados do DATASUS | Sistema específico | Período, território, variáveis e filtros |
| Indicador do Banco Mundial | Indicador/recurso | Código, países, período e transformações |
| API | Fonte/recurso de dados | Endpoint, parâmetros, data, paginação e processamento |
| CSV | Dataset ou fonte que originou o arquivo | Arquivo utilizado e processamento |
| Planilha XLSX | Dataset, tabela ou fonte institucional | Arquivo e tratamento |
| Resposta JSON | Fonte/API | Consulta, parâmetros e processamento |
| Dataset no Zenodo | Dataset | Versão e arquivos utilizados |
| Dataset no SciELO Data | Dataset | Versão, arquivos e relação com artigo, quando pertinente |
| Dataset no Kaggle | Dataset e sua proveniência | Versão, fonte original e transformações |
| Dataset no GitHub | Dataset/repositório ou release pertinente | Tag, release, commit e arquivos |
| GitHub com versão arquivada no Zenodo | Versão persistente do objeto | Relação com o repositório de desenvolvimento |
| Artigo com dataset associado | Artigo e/ou dataset conforme o uso | Explicar qual objeto forneceu dados e qual forneceu informação |
| Reanálise de dataset publicado | Dataset reutilizado | Novo recorte, tratamento e análise |
| Apenas artigo utilizado | Artigo | Não afirmar que o dataset foi reutilizado |
| Tabela criada com dados externos | Fonte dos dados | Procedimento de elaboração |
| Gráfico criado com dados externos | Fonte dos dados | Cálculos e transformações |
| Duas ou mais bases combinadas | Cada fonte relevante | Chaves, harmonização e integração |
| Dataset derivado publicado | Dataset derivado | Preservar também a proveniência das fontes originais |
| Dados próprios não publicados | Coleta da própria pesquisa | Procedimentos de produção e análise |
| Dados próprios depositados | Dataset publicado | Procedimentos de coleta e análise |
| Dados restritos | Dataset/metadados públicos, quando existentes | Forma de acesso e proteção dos dados |
Boa prática
Se uma situação envolve mais de um objeto — por exemplo, artigo, dataset e software — não tente escolher um único objeto apenas para reduzir o número de referências. Identifique cada componente que exerceu função relevante no trabalho.
Referência, metodologia ou fonte da tabela: onde colocar cada informação?
Uma das maiores dificuldades não é descobrir a informação, mas saber onde ela deve aparecer.
| Informação | Referência | Metodologia | Fonte da tabela/gráfico |
|---|---|---|---|
| Autor/responsável | Sim | Pode aparecer | Pode aparecer |
| Título do dataset | Sim | Recomendável na identificação | Normalmente resumido |
| Data do recurso | Quando pertinente | Quando relevante | Normalmente não |
| Versão | Quando pertinente | Importante quando afeta a análise | Somente quando necessário |
| DOI/identificador | Sim, quando disponível e aplicável | Pode ser mencionado | Normalmente não |
| Repositório | Quando pertinente | Pode ser mencionado | Normalmente não |
| Data de extração | Conforme o objeto e padrão | Especialmente importante em bases dinâmicas | Às vezes |
| Período analisado | Se integrar a identidade do objeto | Sim | Frequentemente útil |
| Território | Se integrar a identidade do objeto | Sim | Frequentemente útil |
| Variáveis selecionadas | Normalmente não | Sim | Não necessariamente |
| Filtros | Normalmente não | Sim | Quando necessários à compreensão |
| Exclusões | Não | Sim | Normalmente não |
| Limpeza | Não | Sim | Não |
| Junção de bases | Não como procedimento | Sim | Pode exigir múltiplas fontes |
| Variável calculada | Não como procedimento | Sim | Pode exigir indicação de elaboração própria |
| Software | Em referência própria, quando pertinente | Sim, se relevante | Normalmente não |
Essa distribuição evita dois extremos:
- referências excessivamente carregadas com detalhes metodológicos;
- metodologias vagas que transferem toda a responsabilidade de documentação para a lista de referências.
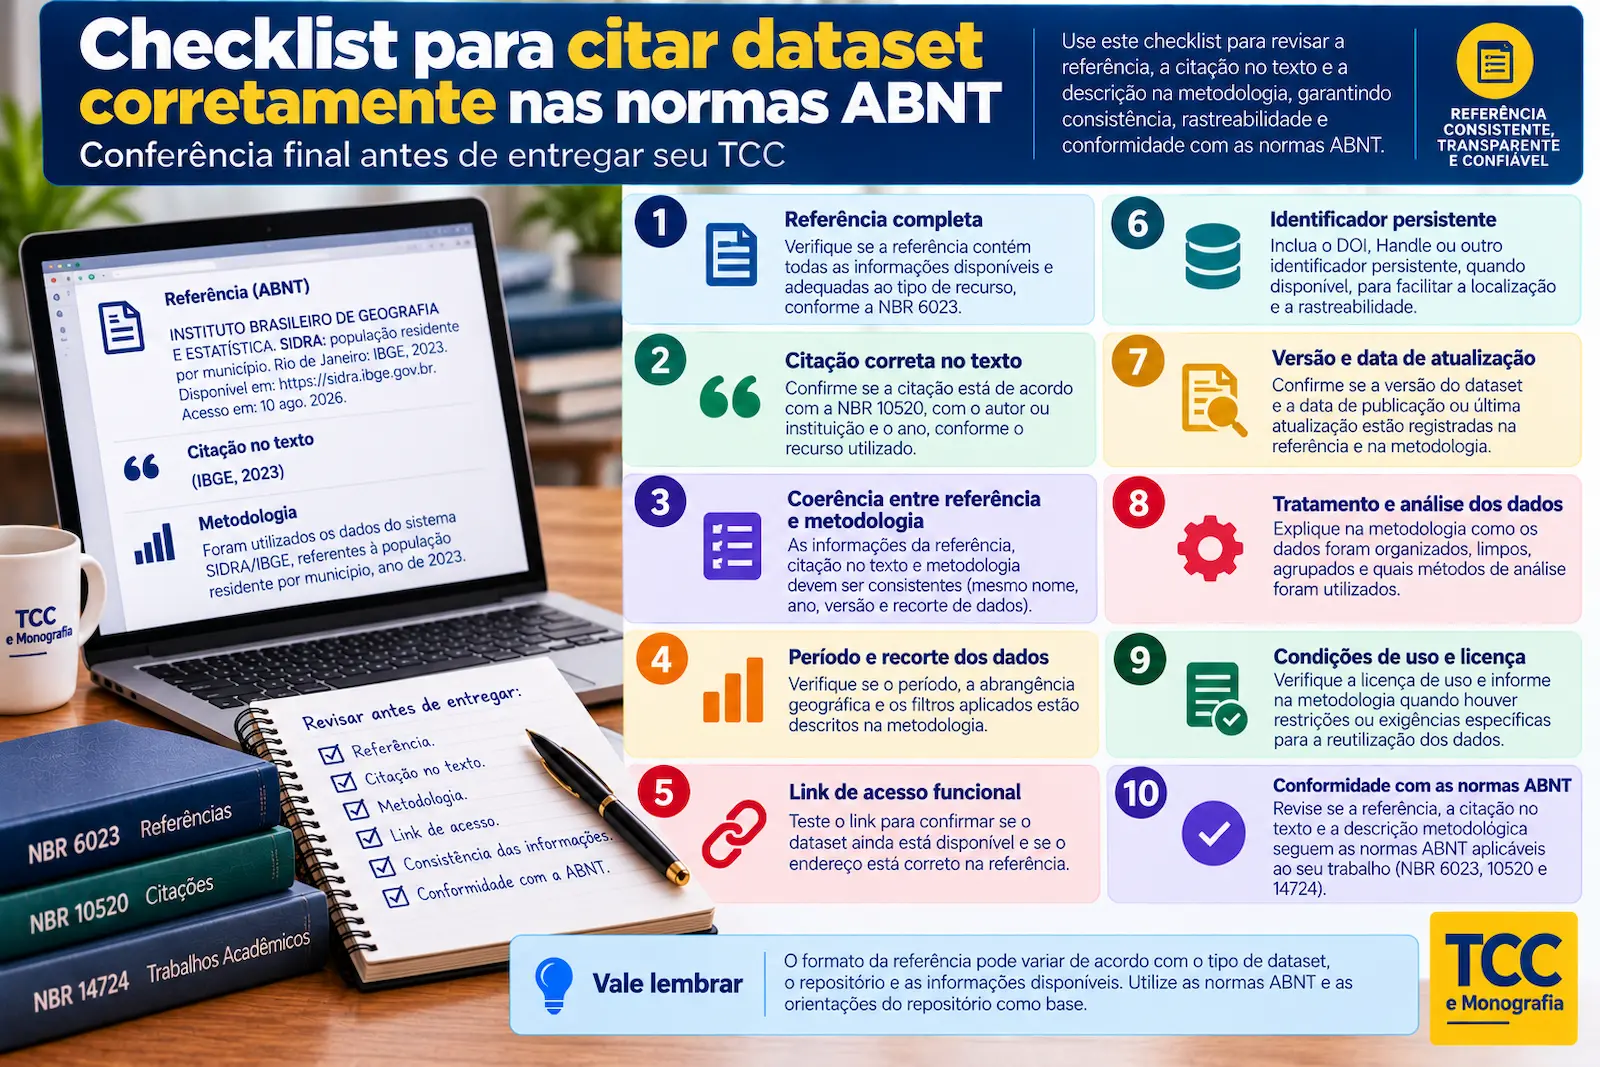
Checklist para citar dataset corretamente nas normas ABNT
Use este checklist antes da entrega do TCC.
1. Objeto
- Sei exatamente o que utilizei?
- Diferenciei dataset, base, tabela, arquivo, artigo, software e página?
- Evitei citar apenas a plataforma?
2. Responsabilidade
- Identifiquei os criadores?
- Verifiquei se a autoria é pessoal ou institucional?
- Diferenciei autor, repositório, mantenedor e financiador?
3. Título e metadados
- Utilizei o título oficial?
- Evitei substituir o título pelo nome local do arquivo?
- Conferi os metadados no registro oficial?
4. Versão
- Existe versão?
- Registrei a versão efetivamente analisada?
- Evitei atualizar a referência para uma versão diferente dos dados utilizados?
5. Identificadores
- Existe DOI?
- Confirmei que ele pertence ao dataset?
- Existe Handle, ARK, código ou outro identificador?
- Utilizei página persistente quando disponível?
6. Obtenção dos dados
- Registrei como os dados foram obtidos?
- Download?
- API?
- Consulta?
- Microdados?
- Acesso controlado?
7. Recorte metodológico
- Registrei o período?
- Registrei o território?
- Registrei a população?
- Registrei as variáveis?
- Registrei filtros?
- Registrei critérios de inclusão e exclusão?
8. Tratamento
- Documentei limpeza?
- Documentei duplicidades?
- Documentei dados ausentes?
- Documentei recodificações?
- Documentei conversões?
- Documentei variáveis calculadas?
9. Integração
- Combinei mais de uma base?
- Registrei as chaves?
- Expliquei a harmonização?
- Preservei a origem de cada variável relevante?
10. Proveniência
- Consigo reconstruir a origem dos dados?
- Consigo identificar transformações feitas por terceiros?
- Consigo separar fonte original e dataset derivado?
11. Referência
- A referência identifica corretamente o objeto?
- Os elementos foram conferidos?
- Evitei inventar metadados?
- A referência automática do repositório foi revisada?
12. Citação
- A atribuição no texto corresponde à referência?
- Evitei atribuir ao repositório dados produzidos por outra entidade?
- As citações são coerentes ao longo do trabalho?
13. Metodologia
- Expliquei de onde vieram os dados?
- Expliquei como foram obtidos?
- Expliquei o recorte?
- Expliquei o tratamento?
- Expliquei a análise?
14. Tabelas e gráficos
- As fontes estão indicadas?
- “Elaboração própria” preserva a origem dos dados?
- Os cálculos derivados estão claramente identificados?
15. Ética, licença e acesso
- Os dados possuem restrições?
- Respeitei as condições de acesso?
- Evitei expor informações confidenciais?
- Evitei publicar credenciais?
- Verifiquei a licença quando necessário?
16. Auditoria final
- A versão citada corresponde à analisada?
- A metodologia corresponde ao que realmente fiz?
- As tabelas correspondem à base final?
- As fontes citadas foram efetivamente utilizadas?
- Consigo reconstruir o caminho da fonte ao resultado?
Na prática
Se você consegue marcar todos os itens aplicáveis sem depender da memória, sua documentação está muito mais preparada para a revisão final.
Fluxo rápido: estou citando o objeto certo?
Use este fluxo quando estiver em dúvida.
Etapa 1 — Utilizei dados ou apenas li uma publicação?
Se apenas leu uma publicação, talvez o objeto principal seja artigo, relatório, livro ou documento.
Se reutilizou dados, continue.
Etapa 2 — Existe um dataset formalmente identificado?
Se sim, examine seus metadados.
Se não, identifique a base, tabela, sistema ou arquivo que forneceu os registros.
Etapa 3 — O dataset possui versão?
Se sim, registre a versão utilizada.
Se não, procure outros elementos que situem o estado dos dados.
Etapa 4 — Existe DOI ou outro identificador?
Se sim, confirme que ele pertence ao objeto.
Etapa 5 — O recurso está em uma plataforma?
Diferencie plataforma, repositório e autoria.
Etapa 6 — Os dados foram obtidos por consulta ou API?
Registre os parâmetros e filtros metodologicamente relevantes.
Etapa 7 — Utilizei apenas parte dos dados?
Explique o recorte na metodologia.
Etapa 8 — Transformei os dados?
Documente as transformações importantes.
Etapa 9 — Combinei fontes?
Preserve a proveniência de cada uma.
Etapa 10 — Os resultados podem ser ligados aos dados utilizados?
Se não, existe uma lacuna de rastreabilidade a ser corrigida.
Modelo de ficha para documentar um dataset durante o TCC
Copie esta estrutura para seu arquivo de controle e preencha assim que uma nova fonte de dados entrar na pesquisa.
| Campo | Preenchimento |
|---|---|
| Tipo de objeto | [dataset/base/tabela/API/microdados/outro] |
| Responsável | [preencher] |
| Título oficial | [preencher] |
| Data | [preencher] |
| Versão | [preencher] |
| DOI | [preencher] |
| Outro identificador | [preencher] |
| Repositório/sistema | [preencher] |
| Página persistente | [preencher] |
| Data de acesso | [preencher] |
| Data de extração | [preencher] |
| Forma de obtenção | [download/API/consulta/outro] |
| Arquivos utilizados | [preencher] |
| Período analisado | [preencher] |
| Território | [preencher] |
| População/unidade | [preencher] |
| Variáveis | [preencher] |
| Filtros | [preencher] |
| Inclusões/exclusões | [preencher] |
| Dados ausentes | [preencher] |
| Transformações | [preencher] |
| Junções | [preencher] |
| Variáveis derivadas | [preencher] |
| Software/script | [preencher] |
| Licença/restrições | [preencher] |
| Documentação consultada | [README/dicionário/manual/outro] |
| Observações | [preencher] |
Por que preencher a ficha durante a pesquisa?
Porque vários elementos desaparecem facilmente da memória:
- qual arquivo foi utilizado;
- qual versão estava disponível;
- quais filtros foram selecionados;
- quando a extração ocorreu;
- qual transformação foi aplicada.
Registrar essas informações imediatamente reduz retrabalho na etapa de escrita.
O teste das três camadas: referência, metodologia e resultado
Antes da entrega, teste seu trabalho em três níveis.
Camada 1 — Referência: qual objeto utilizei?
A lista de referências deve permitir identificar adequadamente a fonte ou objeto utilizado.
Pergunte:
- quem é responsável?
- qual é o título?
- qual versão?
- qual identificador?
- onde o objeto está disponível?
Camada 2 — Metodologia: o que fiz com os dados?
A metodologia deve explicar:
- como os dados foram obtidos;
- qual recorte foi utilizado;
- quais registros entraram;
- quais transformações ocorreram;
- como os dados foram analisados.
Camada 3 — Resultado: o que obtive?
Os resultados devem ser rastreáveis até a base analítica.
Pergunte:
- de quais dados surgiu esta tabela?
- de quais dados surgiu este gráfico?
- como este indicador foi calculado?
- qual base alimentou este modelo?
As três camadas precisam conversar
Uma inconsistência típica ocorre quando:
referência = versão 3
metodologia = descreve versão 2
resultado = calculado com versão 1.
Mesmo que cada seção pareça correta isoladamente, o trabalho apresenta um problema de correspondência.
Visão do especialista
O objetivo da auditoria final não é apenas perguntar se a referência “está em ABNT”. É verificar se referência, metodologia e resultado descrevem a mesma pesquisa.
Resumo operacional: como citar qualquer dataset
Quando precisar resolver rapidamente uma nova situação, siga esta sequência:
Identifique o objeto → encontre os responsáveis → registre o título → confira a versão → verifique a data → localize DOI ou identificador → registre a fonte de acesso → documente a extração → defina o recorte → registre as transformações → monte a referência → faça a citação → explique o uso na metodologia → preserve a origem em tabelas e gráficos → audite a correspondência final.
Essa sequência funciona melhor do que procurar uma fórmula pronta porque parte do objeto real.
Se ainda houver dúvida, faça quatro perguntas
- O que exatamente utilizei?
- Quem responde por esse objeto?
- O que precisa aparecer na referência?
- O que precisa ser explicado na metodologia?
Na maioria das situações, essas quatro perguntas revelam onde está a dificuldade.
Em resumo
Uma boa citação de dados depende de coerência entre objeto, metadados, referência, citação, metodologia e resultados. Quanto mais complexo o percurso dos dados, mais importante se torna preservar sua proveniência. O objetivo não é burocratizar a pesquisa, mas permitir que o leitor compreenda exatamente quais dados foram utilizados e como eles produziram os resultados apresentados.
Como saber se o procedimento de referência de um dataset foi executado corretamente?
Seguir uma sequência de etapas é importante, mas isso não garante, por si só, que a referência final esteja correta.
Um estudante pode preencher todos os campos de um modelo e ainda assim identificar o objeto errado, utilizar um DOI incompatível ou atribuir a autoria à instituição que apenas hospeda os arquivos.
Por isso, depois de aplicar o procedimento apresentado neste guia, é recomendável realizar uma segunda verificação: a validação do resultado.
Essa validação deve considerar três dimensões:
- identidade bibliográfica: a referência representa o recurso efetivamente utilizado?
- correção normativa: a apresentação foi construída conforme as regras bibliográficas aplicáveis?
- coerência metodológica: a documentação explica como os dados participaram da pesquisa?
Essas dimensões se complementam, mas não devem ser confundidas.
Resumo rápido
Uma referência de dataset está pronta para revisão final quando o pesquisador consegue identificar o objeto, confirmar seus metadados, verificar o endereço ou identificador e demonstrar coerência entre referência, citação e metodologia.
Os cinco pontos de controle antes de aprovar uma referência de dataset
Uma maneira prática de revisar o trabalho é utilizar cinco pontos de controle.
Cada um responde a uma pergunta diferente.
Controle 1 — O objeto está corretamente identificado?
Antes de conferir qualquer detalhe formal, responda:
Estou referenciando o dataset, a base de dados, uma tabela, um indicador, um arquivo, um artigo ou outro recurso?
Se essa resposta estiver indefinida, a referência ainda não está pronta.
É necessário retornar à fonte e verificar qual objeto foi efetivamente utilizado.
Controle 2 — A responsabilidade corresponde ao objeto?
Confira se os nomes apresentados representam:
- criadores;
- autores institucionais;
- organizações responsáveis;
- publicadores;
- mantenedores;
- instituições hospedeiras.
Nem todas essas funções são equivalentes.
Uma plataforma que hospeda um conjunto não se transforma automaticamente em sua autora.
Controle 3 — A versão ou o estado corresponde aos dados analisados?
Verifique se o conjunto possui versão, release, data de atualização ou outro mecanismo de identificação temporal.
Quando se tratar de uma base dinâmica, confirme se a extração foi documentada adequadamente.
Controle 4 — O identificador conduz ao recurso correto?
Abra o DOI, Handle, endereço persistente ou página oficial.
Confira:
- título;
- responsabilidade;
- versão;
- tipo de recurso;
- arquivos associados.
Um link funcional não é suficiente se direcionar para o objeto errado.
Controle 5 — A referência está coerente com a metodologia?
Compare o objeto referenciado com os procedimentos descritos no trabalho.
Se a metodologia informa que foram utilizados microdados de determinada pesquisa, a referência deve permitir reconhecer a fonte pertinente.
Se os dados foram obtidos por API, a metodologia deve apresentar os elementos necessários para compreender a consulta.
Boa prática
Não aprove uma referência apenas porque ela parece visualmente correta. Verifique primeiro identidade, responsabilidade, versão e identificador; depois, examine a apresentação bibliográfica.
Como resolver casos ambíguos que não se encaixam perfeitamente em um modelo?
Nem todos os recursos digitais apresentam metadados completos ou organização bibliográfica evidente.
Algumas bases possuem múltiplas camadas de identificação. Outras oferecem apenas páginas dinâmicas, arquivos para download ou registros institucionais pouco detalhados.
Nessas situações, o objetivo não deve ser forçar o recurso a caber em um modelo previamente escolhido.
O caminho mais seguro é investigar a natureza do objeto.
Caso A — Existe uma página institucional e um arquivo para download
Verifique se a página representa um recurso publicado com identidade própria.
O arquivo pode ser apenas um componente do conjunto.
Se o arquivo possuir identificação independente, avalie se essa identidade é a mais pertinente.
Caso B — Existe um artigo associado ao dataset
Determine se você utilizou:
- os argumentos e resultados do artigo;
- os registros disponibilizados no dataset;
- ambos.
Essa distinção orienta a identificação dos objetos relevantes.
Caso C — A plataforma apresenta um responsável e o arquivo menciona outro
Investigue a diferença.
O nome exibido pela plataforma pode corresponder ao depositante, enquanto o arquivo apresenta a instituição produtora.
Não escolha automaticamente um dos nomes sem verificar sua função.
Caso D — Existe DOI geral e DOI de versão
Verifique qual identificador corresponde ao objeto efetivamente utilizado.
Em determinados repositórios, um identificador pode representar o conjunto de versões, enquanto outro identifica uma publicação específica.
O funcionamento depende da plataforma.
Caso E — Não existe DOI
Utilize os elementos bibliográficos disponíveis e adequados à natureza do recurso.
Não invente identificadores.
Caso F — A fonte foi atualizada depois da coleta
Preserve a correspondência com o estado analisado.
Se a atualização alterar substancialmente os resultados, avalie metodologicamente a necessidade de nova análise.
Caso G — Os dados não são públicos
Documente a origem dentro dos limites permitidos.
Não apresente o recurso como publicamente acessível quando ele não é.
Matriz de decisão expandida: qual caminho seguir em cada situação?
A tabela abaixo complementa a matriz de decisão apresentada anteriormente no artigo.
| Situação encontrada | Primeira verificação | Decisão operacional |
|---|---|---|
| Dataset com DOI | Objeto e versão | Usar os metadados correspondentes ao conjunto analisado |
| DOI de artigo associado | Tipo de recurso | Não utilizar como se fosse DOI do dataset |
| Dataset sem DOI | Responsabilidade, título e localização | Construir identificação com os elementos disponíveis |
| Base dinâmica | Estado dos registros | Documentar extração e recorte |
| Tabela estatística | Pesquisa e identificação da tabela | Preservar identidade do recurso e filtros metodológicos |
| Microdados | Pesquisa, edição e arquivos | Documentar componentes utilizados |
| API | Fonte, recurso e consulta | Separar referência e documentação técnica |
| GitHub | Natureza do objeto e versão | Identificar dataset, software ou recurso efetivamente utilizado |
| Kaggle | Proveniência | Distinguir publicador e produtor original |
| Dataset derivado | Fontes e transformações | Preservar a cadeia de proveniência |
| Dados próprios | Existência de publicação independente | Documentar produção e eventual objeto publicado |
| Dados restritos | Condições de acesso | Identificar sem expor informações protegidas |
A matriz é um instrumento didático de decisão. Não representa uma classificação oficial estabelecida pela ABNT.
Quando uma referência de dataset pode ser considerada pronta?
Uma referência pode ser considerada preparada para a revisão final quando atende às seguintes condições:
- o objeto foi identificado corretamente;
- a responsabilidade foi verificada;
- o título corresponde ao recurso;
- a data foi conferida;
- a versão foi considerada quando pertinente;
- o identificador ou endereço foi validado;
- a apresentação foi adaptada ao padrão bibliográfico aplicável;
- a citação no texto está coerente;
- a metodologia reconhece o recurso utilizado;
- não existem informações inventadas.
Essa lista não deve ser interpretada como um conjunto de elementos obrigatórios em toda referência.
Alguns recursos não possuem versão ou DOI, por exemplo.
O objetivo é verificar os elementos aplicáveis ao objeto real.
Quando a metodologia está suficientemente documentada?
Uma metodologia não precisa reproduzir todos os detalhes técnicos de uma base de dados, mas deve permitir compreender as decisões que sustentam os resultados.
Para avaliar sua suficiência, pergunte:
- O leitor consegue identificar a fonte?
- Consegue reconhecer o período analisado?
- Consegue compreender o recorte territorial?
- Consegue identificar as variáveis relevantes?
- Consegue entender como os registros foram obtidos?
- Consegue reconhecer os principais tratamentos?
- Consegue compreender a construção da base analítica?
- Consegue identificar limitações importantes?
Se respostas essenciais estiverem ausentes, a metodologia pode precisar de complementação.
Detalhamento proporcional ao tipo de pesquisa
Uma pesquisa descritiva baseada em uma tabela pública pode exigir documentação diferente daquela necessária em um estudo que combina dezenas de datasets e executa procedimentos computacionais complexos.
O nível de detalhamento deve acompanhar a complexidade do método e a relevância das decisões.
Visão do especialista
Uma metodologia adequada não é necessariamente a mais extensa. É aquela que apresenta as informações necessárias para compreender, avaliar e, quando viável, reconstruir o procedimento utilizado.
Como verificar a coerência entre referência, metodologia e resultados?
A coerência documental é uma das etapas mais importantes da auditoria final.
Ela exige verificar se diferentes partes do TCC descrevem a mesma fonte e o mesmo procedimento.
Verificação 1 — Referência e fonte utilizada
A referência identifica o recurso que realmente forneceu os dados?
Verificação 2 — Referência e citação no texto
As chamadas no texto correspondem aos responsáveis e datas apresentados nas referências, conforme as regras aplicáveis?
Verificação 3 — Referência e metodologia
O recurso descrito na metodologia corresponde ao objeto referenciado?
Verificação 4 — Metodologia e base analítica
Os filtros, variáveis e períodos descritos correspondem aos arquivos efetivamente utilizados?
Verificação 5 — Base analítica e resultados
As tabelas e os gráficos foram produzidos a partir do conjunto documentado?
Verificação 6 — Resultados e indicação das fontes
As visualizações reconhecem adequadamente a origem dos dados externos?
Essa conferência pode revelar problemas que não aparecem durante a revisão isolada da bibliografia.
Exemplo comentado: auditoria completa de uma pesquisa com dados públicos
Considere um estudo hipotético sobre indicadores municipais.
O estudante utiliza duas fontes públicas, combina os registros e produz um gráfico comparativo.
Primeira camada — Identificação bibliográfica
As duas fontes devem permanecer identificáveis.
É necessário verificar a natureza de cada recurso e os metadados correspondentes.
Segunda camada — Extração
A metodologia deve explicar:
- períodos;
- territórios;
- variáveis;
- procedimentos de obtenção;
- datas de extração, quando relevantes.
Terceira camada — Integração
O pesquisador precisa documentar como os registros foram combinados.
Isso pode incluir chaves de integração, compatibilidade temporal e tratamento de observações sem correspondência.
Quarta camada — Transformação
Se o gráfico apresenta um indicador calculado, deve ficar claro que esse indicador foi produzido pelo pesquisador a partir dos dados obtidos.
Quinta camada — Apresentação
A indicação da fonte do gráfico deve reconhecer as origens externas.
Modelo estrutural:
Fonte: elaboração própria a partir de dados de [Fonte A] e [Fonte B].
Sexta camada — Auditoria
Antes da entrega, o estudante deve conferir se as referências, a metodologia e o gráfico descrevem o mesmo percurso.
Esse exemplo demonstra que uma referência correta integra um processo maior de documentação científica.
Ficha de aprovação final de referência de dataset
A ficha abaixo pode ser utilizada durante a revisão bibliográfica.
| Item | Conferência |
|---|---|
| Objeto identificado | [ ] Sim [ ] Revisar |
| Responsabilidade conferida | [ ] Sim [ ] Revisar |
| Título oficial conferido | [ ] Sim [ ] Revisar |
| Data verificada | [ ] Sim [ ] Revisar |
| Versão considerada | [ ] Sim [ ] Não se aplica [ ] Revisar |
| Identificador validado | [ ] Sim [ ] Não disponível [ ] Revisar |
| Localização conferida | [ ] Sim [ ] Revisar |
| Modelo bibliográfico adequado | [ ] Sim [ ] Revisar |
| Citação no texto coerente | [ ] Sim [ ] Revisar |
| Metodologia coerente | [ ] Sim [ ] Revisar |
| Fontes de tabelas e gráficos conferidas | [ ] Sim [ ] Não se aplica [ ] Revisar |
| Orientações institucionais verificadas | [ ] Sim [ ] Revisar |
Essa ficha é uma ferramenta de revisão, não um formulário normativo obrigatório.
Como priorizar correções quando o prazo de entrega está próximo?
Em períodos de revisão final, é comum encontrar diferentes tipos de problemas.
Para evitar gastar tempo excessivo em ajustes superficiais enquanto inconsistências graves permanecem, organize as correções por impacto.
Prioridade crítica — Problemas que comprometem a identificação ou a pesquisa
- dataset errado;
- DOI de outro objeto;
- versão incompatível;
- extração incompleta;
- dados protegidos divulgados indevidamente;
- fonte essencial não identificada.
Prioridade alta — Problemas que prejudicam a rastreabilidade
- filtros não documentados;
- transformações omitidas;
- fontes de bases combinadas incompletas;
- incoerência entre metodologia e resultados;
- ausência de informações relevantes sobre extração.
Prioridade de revisão formal — Problemas de apresentação
- inconsistência de pontuação;
- padronização tipográfica;
- organização dos elementos;
- uniformidade das referências;
- detalhes de apresentação exigidos pela instituição.
Todos os problemas devem ser corrigidos quando aplicáveis. A classificação serve apenas para organizar a revisão.
Checklist final de entrega: referência, citação, metodologia e resultados
Utilize a lista abaixo como verificação complementar ao checklist definitivo apresentado anteriormente.
Identidade bibliográfica
- [ ] O objeto utilizado está corretamente identificado.
- [ ] A autoria ou responsabilidade foi conferida.
- [ ] O título corresponde ao registro oficial.
- [ ] A data foi verificada.
- [ ] A versão utilizada foi identificada quando aplicável.
- [ ] O DOI ou endereço conduz ao recurso correto.
Apresentação normativa
- [ ] O modelo corresponde à natureza do objeto.
- [ ] A referência foi revisada conforme as normas aplicáveis.
- [ ] As chamadas no texto estão coerentes.
- [ ] As orientações da instituição foram consideradas.
Metodologia
- [ ] A fonte foi identificada.
- [ ] O período foi informado.
- [ ] O recorte territorial foi documentado.
- [ ] As variáveis relevantes foram descritas.
- [ ] O procedimento de obtenção foi explicado.
- [ ] A data de extração foi registrada quando pertinente.
- [ ] As transformações relevantes foram documentadas.
- [ ] As limitações foram consideradas.
Resultados
- [ ] As tabelas reconhecem a origem dos dados.
- [ ] Os gráficos reconhecem a origem dos dados.
- [ ] Indicadores derivados foram distinguidos dos originais.
- [ ] Os resultados correspondem ao conjunto documentado.
Integridade e cuidados éticos
- [ ] Os arquivos utilizados permanecem identificáveis.
- [ ] As condições de uso foram consideradas.
- [ ] Informações protegidas não foram divulgadas indevidamente.
- [ ] Não foram inventados metadados ou identificadores.
Síntese operacional: quando encerrar a revisão de um dataset?
A revisão pode ser considerada suficientemente amadurecida quando o pesquisador consegue responder com segurança a cinco perguntas:
- O que utilizei? — identidade do objeto.
- Quem responde por ele? — responsabilidade.
- Qual estado utilizei? — versão ou extração.
- Como utilizei? — metodologia.
- Onde reconheci a fonte? — referência, citação e resultados.
Se alguma dessas respostas permanece indefinida, pode existir uma lacuna relevante.
Quando todas estão documentadas de maneira coerente, o trabalho apresenta condições melhores de rastreabilidade e avaliação.
Em resumo
O procedimento definitivo de referência de datasets não termina quando os campos bibliográficos são preenchidos. Ele termina com a verificação da correspondência entre objeto, responsabilidade, versão ou estado, identificador, metodologia e resultados.
Uma referência bem construída identifica a fonte. Uma pesquisa bem documentada mostra como essa fonte contribuiu para os resultados.
Como citar base de dados nas normas ABNT?
Primeiro identifique exatamente qual objeto foi utilizado
Para citar uma base de dados corretamente, comece identificando o recurso efetivamente utilizado: base, dataset, tabela, série histórica, microdados, arquivo, API ou outro objeto.
Depois, procure nos metadados elementos como:
- autor ou instituição responsável;
- título;
- data;
- versão, quando existente;
- repositório ou sistema;
- DOI ou outro identificador;
- endereço persistente.
A referência deve identificar o objeto utilizado. Já informações como recorte, filtros, variáveis e tratamento dos dados pertencem principalmente à metodologia.
Como citar um dataset nas normas ABNT?
Utilize os metadados reais do conjunto de dados
Um dataset pode apresentar autoria pessoal ou institucional, título próprio, versão, data, repositório e identificador persistente.
Uma estrutura adaptável é:
AUTOR/INSTITUIÇÃO. Título do dataset. Versão, quando pertinente. Repositório, ano. DOI ou outro identificador, quando existente.
O modelo precisa ser adaptado ao registro real. Não invente elementos ausentes apenas para preencher uma estrutura.
Base de dados e dataset são a mesma coisa?
Nem sempre
Os termos podem ser utilizados de maneira próxima em determinados contextos, mas não precisam representar exatamente o mesmo objeto.
Uma base de dados pode ser um sistema amplo, continuamente atualizado e composto por diversos registros, tabelas ou conjuntos.
Um dataset costuma representar um conjunto de dados delimitado que pode possuir identidade própria, versão, criadores, arquivos e identificador.
Para a referência, o mais importante é descobrir qual objeto foi efetivamente utilizado.
Todo dataset precisa ter DOI para ser citado?
Não
DOI é um identificador persistente muito útil, mas não é condição universal para que um conjunto de dados possa ser utilizado ou identificado.
Um dataset sem DOI pode possuir:
- Handle;
- ARK;
- identificador institucional;
- código;
- URL persistente;
- metadados suficientes para sua identificação.
A ausência de DOI também não significa automaticamente que a fonte tenha baixa qualidade.
Posso usar o DOI do artigo para citar o dataset?
Somente se o DOI realmente identificar o objeto que está sendo citado
Um artigo e um dataset associado podem possuir DOIs diferentes.
O DOI do artigo identifica o artigo. O DOI do dataset identifica o conjunto de dados.
Não transfira o DOI de um objeto para outro apenas porque eles fazem parte do mesmo projeto científico.
Como citar dataset sem DOI?
Utilize os demais elementos de identificação disponíveis
Procure:
- responsável;
- título;
- data;
- versão;
- repositório;
- Handle;
- código institucional;
- página persistente.
O objetivo continua sendo permitir que o leitor identifique o objeto utilizado.
Quem é o autor de um dataset?
Depende dos metadados e da responsabilidade pelo conjunto
A autoria pode ser:
- pessoal;
- coletiva;
- institucional.
Consulte o registro oficial do dataset e procure campos como criadores, autores ou responsáveis.
Não presuma que a plataforma de hospedagem seja a autora.
Uma instituição pode ser autora de um dataset?
Sim, quando a responsabilidade pelo conjunto é institucional
Órgãos públicos, institutos de pesquisa, organizações internacionais, universidades e outras entidades podem aparecer como responsáveis pelos dados.
Não é necessário inventar um autor pessoal quando os metadados indicam claramente responsabilidade institucional.
O repositório deve aparecer como autor do dataset?
Não automaticamente
O repositório pode hospedar, preservar e disponibilizar o conjunto sem ser seu criador.
Por isso, diferencie:
quem criou os dados ≠ quem hospeda os dados.
Preciso informar a versão do dataset?
A versão merece ser registrada quando é pertinente à identificação e à rastreabilidade
Se diferentes versões contêm dados diferentes, a versão utilizada pode ser essencial para compreender e reproduzir a análise.
Se o recurso não possui versão explícita, não invente uma.
Devo sempre citar a versão mais recente do dataset?
Não se a análise foi realizada com outra versão
A referência deve permanecer coerente com os dados que produziram seus resultados.
Atualizar a referência sem atualizar a análise pode criar uma inconsistência entre fonte e resultado.
O que fazer se o dataset foi atualizado depois da minha análise?
Verifique se a atualização altera os registros utilizados
Compare as versões ou estados.
Se a mudança não afeta o material analisado, preserve a identificação coerente com o estado utilizado.
Se altera valores, variáveis ou registros relevantes, pode ser necessário refazer parte do processamento e avaliar os resultados.
Data de acesso e data de extração são a mesma coisa?
Não necessariamente
A data de acesso registra quando um recurso foi consultado.
A data de extração registra quando os dados efetivamente utilizados foram obtidos.
Em uma base dinâmica, essa diferença pode ser importante.
Dados públicos precisam ser citados?
Sim, quando são utilizados como fonte
O fato de os dados estarem disponíveis publicamente não elimina sua origem.
Dados governamentais, estatísticos e institucionais continuam possuindo proveniência e precisam ser identificados adequadamente.
Dados abertos precisam ser citados?
A abertura dos dados não elimina a atribuição da fonte
Licença aberta e referência bibliográfica exercem funções diferentes.
Consulte também as condições de reutilização quando forem pertinentes à pesquisa.
Como citar dados coletados por mim?
Dados próprios não publicados são documentados principalmente na metodologia
Explique:
- como foram coletados;
- quando;
- com qual instrumento;
- qual população ou amostra;
- como foram tratados;
- como foram analisados.
Não crie artificialmente uma referência bibliográfica para uma planilha privada apenas para fazê-la parecer um dataset publicado.
E se eu publicar meus próprios dados em um repositório?
O dataset pode adquirir identidade bibliográfica própria
Se o conjunto recebe título, criadores, versão, data, repositório e DOI ou outro identificador, ele pode ser referenciado como produto de pesquisa.
Isso não elimina a necessidade de explicar a coleta e a análise na metodologia.
Como citar dados de acesso restrito?
Identifique o conjunto sem expor informações protegidas
Quando existem metadados públicos, eles podem permitir a identificação do recurso mesmo que os registros estejam protegidos.
Na metodologia, explique as condições de acesso e os procedimentos pertinentes dentro dos limites éticos, legais, contratuais e institucionais.
Devo citar o dataset ou o artigo associado?
Depende do que foi utilizado
Se você reutilizou os dados, o dataset exerce função própria.
Se utilizou afirmações, metodologia, resultados ou discussão do artigo, o artigo também exerce função própria.
Quando ambos foram utilizados, pode ser necessário citar os dois.
Se eu citei o artigo, preciso citar o dataset mesmo assim?
Se o dataset foi efetivamente reutilizado e possui identidade própria relevante, o artigo não necessariamente substitui sua identificação
O artigo comunica a pesquisa. O dataset representa os dados reutilizados.
Analise a função exercida por cada objeto.
Como citar dados do IBGE?
Identifique o produto específico utilizado
Evite utilizar apenas “IBGE” quando for possível identificar:
- pesquisa;
- censo;
- tabela;
- série;
- microdados;
- indicador;
- arquivo.
Na metodologia, registre o recorte utilizado.
Como citar uma tabela do SIDRA?
Identifique a tabela e documente a consulta
Registre, conforme pertinente:
- IBGE;
- pesquisa;
- número da tabela;
- título;
- período;
- território;
- variáveis;
- classificações;
- filtros.
Os detalhes da consulta pertencem principalmente à documentação metodológica.
Como citar microdados do IBGE?
Identifique a pesquisa e a edição ou período utilizados
Na metodologia, informe também:
- arquivos utilizados;
- variáveis;
- recorte;
- pesos, quando pertinentes;
- tratamentos realizados.
Como citar dados do DATASUS?
Procure identificar o sistema que originou os registros
Dependendo da pesquisa, os dados podem vir de sistemas como:
- SIM;
- SINASC;
- SIH/SUS;
- SIA/SUS;
- SINAN;
- CNES.
Evite utilizar apenas “DATASUS” quando a origem puder ser especificada.
DATASUS e TABNET são a mesma fonte?
Não necessariamente
O TABNET pode funcionar como ambiente de tabulação e consulta, enquanto os registros pertencem a determinado sistema de informação.
Documente tanto a origem quanto a forma de obtenção quando essa distinção for relevante.
Como citar dados do Banco Mundial?
Identifique o indicador ou recurso específico utilizado
Registre:
- nome do indicador;
- código;
- país ou território;
- período;
- forma de obtenção.
Se os dados foram obtidos por API, documente também a consulta.
Como citar dataset do Zenodo?
Utilize os metadados do registro correspondente ao conjunto utilizado
Confira:
- criadores;
- título;
- versão;
- data;
- DOI;
- arquivos.
Não utilize “Zenodo” como autoria automática.
No Zenodo, devo usar o DOI da versão ou o identificador geral?
Escolha a granularidade que corresponde à função da citação
Quando a reprodução da análise depende de uma versão específica, identificar essa versão pode ser especialmente útil.
Quando o objetivo é mencionar o recurso de forma mais ampla, outro nível de identificação pode ser adequado.
Não transforme essa escolha em uma regra mecânica aplicável a qualquer situação.
Como citar dataset do SciELO Data?
Utilize o registro específico do dataset
Confira autoria, título, data, versão, DOI e demais metadados disponibilizados.
Se existir artigo associado e ele também for utilizado, trate artigo e dataset conforme suas funções próprias.
Como citar dataset do Kaggle?
Primeiro investigue a proveniência
O conjunto pode ter sido:
- produzido pelo publicador;
- copiado de uma fonte institucional;
- transformado a partir de outras fontes.
Não presuma que Kaggle seja o autor nem que o perfil que publicou os arquivos seja necessariamente o produtor original dos dados.
Como citar dataset do GitHub?
Identifique o projeto, os responsáveis e o estado utilizado
Registre conforme pertinente:
- repositório;
- responsáveis;
- release;
- tag;
- commit;
- arquivos;
- DOI associado.
GitHub é a plataforma, não automaticamente o autor.
Como citar um arquivo CSV?
Identifique a fonte que originou o arquivo
CSV é formato de arquivo.
Se ele pertence a um dataset, identifique o conjunto. Se foi exportado de uma base institucional, identifique essa fonte.
Na metodologia, informe que os dados foram obtidos em CSV quando isso for relevante.
Como citar uma planilha Excel?
Não utilize Excel como fonte apenas porque os dados estavam em XLS ou XLSX
Procure identificar a instituição, dataset, tabela ou recurso que originou a planilha.
O formato pode ser documentado na metodologia.
Como citar dados em JSON?
Identifique a fonte ou API que gerou a resposta
JSON é formato de representação de dados.
A cadeia correta costuma ser:
fonte → API → consulta → resposta JSON.
Como citar dados obtidos por API?
Identifique a fonte dos dados e documente a requisição
Conforme a pesquisa, registre:
- API;
- recurso ou endpoint;
- parâmetros;
- período;
- data de extração;
- paginação;
- processamento posterior.
Nem todos esses detalhes precisam aparecer dentro da referência bibliográfica.
Preciso colocar a URL completa da API na referência?
Não existe uma resposta única para qualquer API
Uma URL contendo dezenas de parâmetros pode ser tecnicamente útil para reproduzir a consulta, mas não necessariamente é a melhor forma de representar bibliograficamente a fonte.
Dependendo do caso, preserve a página oficial ou identificação estável na referência e documente endpoint e parâmetros na metodologia, script ou material suplementar.
Como indicar a fonte de uma tabela criada a partir de dataset?
Preserve a origem dos dados
Uma estrutura adaptável é:
Fonte: elaboração própria a partir de dados de [fonte].
Adapte a formulação ao objeto utilizado e às regras institucionais.
Como indicar a fonte de um gráfico criado com dados externos?
Informe a origem dos dados que alimentaram o gráfico
Se houve cálculos próprios, você pode deixar claro que a elaboração é sua sem apagar a fonte externa.
Exemplo estrutural:
Fonte: elaboração própria a partir de dados de [fonte], [período].
Posso escrever apenas “Fonte: elaboração própria”?
Depende da origem dos dados
Se os dados foram produzidos integralmente pela própria pesquisa, a indicação pode fazer sentido conforme o contexto e as regras adotadas.
Se a tabela ou gráfico foi construído com dados externos, escrever apenas “elaboração própria” pode apagar a proveniência.
Como citar uma tabela criada com duas ou mais bases?
Identifique as fontes relevantes
Uma estrutura adaptável é:
Fonte: elaboração própria a partir de dados de [fonte A] e [fonte B].
Na metodologia, explique como as bases foram combinadas.
Como citar dataset derivado?
Identifique o conjunto derivado sem apagar as fontes que o originaram
Se o dataset derivado foi formalmente publicado, ele pode possuir autoria, título, versão, repositório e DOI próprios.
A proveniência das fontes originais, porém, continua relevante para compreender como o conjunto foi produzido.
Preciso colocar os filtros utilizados na referência?
Normalmente os filtros analíticos pertencem principalmente à metodologia
A referência identifica o objeto.
A metodologia explica como você selecionou parte dele.
Não transforme a referência em uma descrição completa de todos os cliques e filtros realizados.
Como citar apenas parte de um dataset?
Identifique o conjunto pertinente e explique o recorte
Se você utilizou apenas determinadas variáveis, períodos ou regiões, documente essa seleção na metodologia.
Se o subconjunto possui identidade própria no repositório, avalie essa granularidade específica.
Preciso citar cada arquivo de um dataset?
Não necessariamente
Se os arquivos são apenas componentes de um conjunto identificado como unidade, a referência do dataset pode ser suficiente, acompanhada da documentação dos arquivos utilizados na metodologia.
Se um arquivo possui identificador e identidade próprios, a situação pode exigir tratamento mais granular.
README deve ser citado?
Depende da função que ele exerceu
Se o README apenas ajudou você a localizar um arquivo, talvez não precise exercer papel bibliográfico próprio.
Se ele forneceu definições, procedimentos ou informações metodológicas utilizadas no trabalho, pode funcionar como uma fonte documental relevante.
Dicionário de dados precisa ser citado?
Ele deve ser adequadamente reconhecido quando sustenta a interpretação das variáveis
Um dicionário ou codebook pode ser essencial para compreender:
- códigos;
- categorias;
- unidades;
- valores ausentes;
- universo das variáveis.
Não interprete microdados ignorando sua documentação.
Dataset e software devem ser citados separadamente?
Podem precisar de referências distintas porque são objetos diferentes
O dataset fornece os dados.
O software pode fornecer a ferramenta utilizada para processá-los ou analisá-los.
Quando ambos exercem funções relevantes, trate-os separadamente. Consulte também Como Citar Software nas Normas ABNT.
A referência do dataset substitui a metodologia?
Não
A referência identifica o objeto.
A metodologia explica:
- como os dados foram obtidos;
- qual recorte foi utilizado;
- quais filtros foram aplicados;
- quais transformações ocorreram;
- como os dados foram analisados.
Uma metodologia detalhada substitui a referência?
Também não
Mesmo que você explique detalhadamente o processamento, o leitor ainda precisa conseguir identificar a fonte dos dados.
As duas camadas são complementares.
Dataset deve aparecer na lista de referências?
Quando ele exerce função de fonte e é tratado como objeto bibliográfico pertinente, sua identificação precisa ser preservada adequadamente
A forma exata depende do objeto, dos metadados e do padrão adotado.
Evite tanto omitir fontes realmente utilizadas quanto incluir datasets que não participaram da pesquisa.
Como saber se um dataset é confiável?
Avalie mais do que a aparência da referência
Considere:
- responsabilidade;
- metodologia de produção;
- documentação;
- cobertura;
- atualização;
- consistência;
- limitações;
- adequação ao problema de pesquisa.
DOI, repositório conhecido ou formato profissional não substituem essa avaliação.
A ABNT exige DOI para todo dataset?
Não trate DOI como requisito universal para qualquer conjunto de dados
Quando existe e identifica corretamente o objeto, ele pode melhorar sua identificação e persistência.
Mas bases oficiais, tabelas, sistemas e datasets podem não possuir DOI e ainda assim serem documentados adequadamente.
A ABNT exige versão para todo dataset?
Não invente versionamento onde ele não existe
A versão é especialmente relevante quando o objeto possui versões formalmente identificadas ou quando diferentes estados dos dados precisam ser distinguidos.
A documentação deve refletir os metadados reais do recurso.
Quais normas ABNT são importantes para citar datasets em trabalhos acadêmicos?
A documentação precisa ser compreendida dentro do conjunto de normas aplicáveis ao trabalho
Entre as normas relevantes para este tema estão:
- ABNT NBR 6023, relacionada à elaboração de referências;
- ABNT NBR 10520, relacionada às citações;
- ABNT NBR 14724, relacionada à apresentação de trabalhos acadêmicos.
Além das normas, a instituição pode possuir manual próprio com orientações complementares.
O que a FORCE11 tem a ver com citação de dados?
Ela oferece princípios de boas práticas para citação de dados
Os princípios de citação de dados associados à FORCE11 ajudam a compreender temas como:
- importância dos dados como produtos de pesquisa;
- crédito;
- identificação;
- acesso;
- persistência;
- especificidade;
- verificabilidade.
Esses princípios são úteis para ciência aberta e rastreabilidade, mas não devem ser apresentados como se fossem normas ABNT.
Boas práticas de ciência aberta são exigências da ABNT?
Não automaticamente
Práticas como versionamento rigoroso, snapshots, scripts reproduzíveis, depósito em repositório e identificadores persistentes podem melhorar significativamente a pesquisa.
Entretanto, é importante distinguir:
- exigência normativa;
- regra institucional;
- recomendação do repositório;
- boa prática científica.
A universidade pode exigir um formato diferente?
Sim, podem existir orientações institucionais complementares
Bibliotecas, programas de pós-graduação, cursos, periódicos e orientadores podem estabelecer procedimentos específicos para situações não detalhadas em modelos gerais.
Antes da entrega, confira o manual vigente da instituição.
Posso copiar um modelo pronto de referência de dataset?
Use modelos como estrutura, não como substitutos dos metadados reais
Antes de copiar qualquer modelo, confira:
- se o tipo de objeto é o mesmo;
- se existe autoria equivalente;
- se existe versão;
- se existe DOI;
- se o repositório exerce a mesma função;
- se a fonte é dinâmica.
Copiar um exemplo inadequado pode produzir uma referência visualmente convincente, mas bibliograficamente incorreta.
Qual é a regra mais importante para citar base de dados e dataset corretamente?
Identifique o objeto antes de tentar formatá-lo
Quando houver dúvida, percorra esta sequência:
objeto → responsável → título → versão → identificador → acesso → recorte → transformação → resultado.
Depois distribua as informações conforme suas funções:
- referência: identifica o objeto;
- citação: atribui a informação;
- metodologia: explica o uso dos dados;
- fonte de tabela ou gráfico: preserva a origem dos números apresentados.
Esse raciocínio é mais seguro do que tentar encaixar qualquer dataset em uma única fórmula pronta.
Em resumo
Para citar bases de dados e datasets com consistência, não comece perguntando apenas “qual é o modelo ABNT?”. Comece perguntando qual objeto foi realmente utilizado. A partir daí, identifique os responsáveis, confira os metadados, preserve versão e identificadores quando pertinentes e mantenha coerência entre referência, citação, metodologia e resultados.
Dúvidas avançadas sobre referências de datasets: como resolver situações que não seguem um modelo simples?
As perguntas frequentes apresentadas anteriormente abordam os principais procedimentos para citar bases de dados e datasets nas normas ABNT.
Entretanto, algumas situações exigem uma análise mais cuidadosa porque envolvem múltiplos objetos, metadados incompletos, atualizações, restrições de acesso ou diferenças entre a referência bibliográfica e a documentação metodológica.
Esta seção complementa o FAQ com critérios de decisão e exemplos comentados. O objetivo não é estabelecer regras novas, mas ajudar o leitor a aplicar corretamente os princípios apresentados ao longo do guia.
Resumo rápido
Quando surgir uma dúvida complexa, comece identificando o objeto utilizado. Depois, confira responsabilidade, título, data, versão, identificador e condições de acesso. Por fim, verifique se a metodologia descreve adequadamente como os registros foram obtidos e analisados.
O que fazer quando o artigo e o dataset possuem DOIs diferentes?
Identifique qual objeto foi efetivamente utilizado e preserve os identificadores correspondentes
Um artigo científico e um dataset associado podem constituir publicações independentes.
O artigo pode apresentar objetivos, procedimentos, análises e interpretações. O dataset pode disponibilizar os registros utilizados ou produzidos pela pesquisa.
Quando cada objeto possui DOI próprio, esses identificadores não devem ser tratados como intercambiáveis.
Se o estudante utiliza os dados para produzir uma análise independente, a identificação do dataset é relevante.
Se também utiliza explicações metodológicas ou interpretações do artigo, pode ser pertinente reconhecer os dois objetos.
Exemplo hipotético: um artigo descreve um levantamento e o repositório associado disponibiliza os registros coletados. O estudante utiliza os registros e consulta o artigo para compreender a amostragem.
Nessa situação, os dois recursos desempenham funções distintas na pesquisa.
Erro comum
Copiar o DOI do artigo para uma referência apresentada como dataset, fazendo o identificador conduzir a um objeto diferente daquele descrito.
Qual DOI utilizar quando o repositório apresenta um DOI geral e outro para uma versão específica?
Verifique a política do repositório e identifique a versão efetivamente analisada
Alguns repositórios distinguem o identificador de um conjunto de versões do identificador atribuído a uma publicação específica.
Essa organização pode facilitar tanto a localização geral do projeto quanto a identificação de determinado estado dos dados.
Quando os resultados dependem de uma versão concreta, o identificador correspondente a ela pode oferecer maior precisão.
Entretanto, a escolha deve considerar os metadados, a política de versionamento e a recomendação de citação do próprio repositório.
Não se deve presumir que todos os ambientes utilizam o mesmo sistema.
Como citar um dataset quando não encontro a data de publicação?
Investigue os metadados e aplique as regras bibliográficas pertinentes sem inventar datas
Antes de concluir que a data está ausente, examine:
- registro principal do dataset;
- metadados exportáveis;
- documentação;
- histórico de versões;
- página institucional;
- informações de publicação.
Também é importante diferenciar data de publicação, atualização, extração e acesso.
Esses eventos não são equivalentes.
Se a data necessária não puder ser identificada, utilize o tratamento previsto nas regras bibliográficas aplicáveis, considerando a natureza do recurso.
Não atribua arbitrariamente o ano atual apenas porque a página foi acessada recentemente.
Como proceder quando aparecem autores individuais e uma instituição no mesmo registro?
Distinga os papéis apresentados nos metadados
Um registro pode apresentar pesquisadores como criadores, uma universidade como instituição de vínculo e um repositório como publicador ou hospedeiro.
Essas informações não representam necessariamente a mesma responsabilidade.
Antes de montar a referência, verifique qual função é atribuída a cada agente.
Uma instituição pode ser autora em determinados recursos e exercer apenas uma função de hospedagem em outros.
O critério decisivo é a responsabilidade efetivamente apresentada para o objeto.
Preciso refazer meu TCC quando o dataset é atualizado depois da coleta?
Não automaticamente: avalie o impacto da atualização sobre o desenho e os resultados
A atualização posterior de uma base não torna automaticamente inválida uma análise realizada com um estado anterior.
Entretanto, é necessário considerar:
- qual versão foi utilizada;
- quais registros foram alterados;
- se houve correções relevantes;
- se as mudanças afetam os resultados;
- se a metodologia permite reconhecer o estado analisado.
Uma atualização que acrescenta um período posterior pode ter impacto diferente de uma correção que modifica diretamente os registros utilizados.
A decisão de refazer a análise deve considerar a relevância metodológica da mudança, o objetivo do trabalho e as orientações acadêmicas aplicáveis.
Boa prática
Em pesquisas com bases atualizadas periodicamente, preserve a identificação do conjunto analisado e registre a extração. Isso permite distinguir alterações posteriores dos dados efetivamente utilizados.
Como citar uma base que muda todos os dias e não possui versões arquivadas?
Identifique a fonte e documente o estado da consulta com os elementos disponíveis
Quando a base não oferece versões preservadas, a referência pode identificar o recurso institucional, enquanto a metodologia descreve a extração realizada.
Dependendo do sistema, registre:
- data e, se necessário, horário;
- período consultado;
- território;
- variáveis;
- filtros;
- parâmetros;
- arquivo exportado;
- outras informações necessárias para compreender a consulta.
Se o sistema permitir a preservação de um arquivo ou snapshot, essa prática pode melhorar a rastreabilidade, respeitando as condições de uso.
A data de acesso não substitui automaticamente a documentação metodológica da extração.
Preciso colocar a URL completa da API na referência bibliográfica?
Depende da natureza do recurso e da função da URL na identificação
Uma requisição de API pode conter muitos parâmetros e representar uma consulta específica.
Em determinadas situações, a URL identifica diretamente um recurso recuperável. Em outras, funciona principalmente como registro técnico de uma extração.
Por isso, é necessário distinguir:
- endereço da fonte;
- identificador do recurso;
- endpoint;
- parâmetros de consulta;
- resposta obtida.
A referência bibliográfica deve identificar adequadamente o objeto utilizado.
Os detalhes técnicos da requisição podem ser documentados na metodologia, em apêndice ou em material complementar, quando pertinentes.
Não inclua credenciais ou tokens privados em URLs publicadas.
Como demonstrar que uma extração por API pode ser reproduzida?
Documente os parâmetros, o estado dos dados e os procedimentos de validação
Uma extração por API pode depender de:
- endpoint;
- parâmetros;
- paginação;
- limites de requisição;
- autenticação;
- formato de resposta;
- estado da base;
- tratamento posterior.
Quando essas informações afetam o conjunto analisado, devem ser documentadas.
Entretanto, uma base dinâmica pode não permitir que uma consulta futura retorne exatamente os mesmos registros.
Nesses casos, a preservação permitida da extração original pode ajudar a demonstrar o estado utilizado.
Se baixei os dados do Kaggle, devo citar o usuário que publicou ou a fonte original?
Investigue a proveniência e a contribuição de cada responsável
O Kaggle pode hospedar datasets produzidos diretamente por seus usuários, conjuntos derivados ou reproduções de fontes externas.
Antes de decidir, verifique:
- quem produziu os registros originais;
- quem organizou a publicação;
- se houve transformações;
- qual versão foi utilizada;
- se existe fonte original identificável;
- qual objeto foi efetivamente baixado e analisado.
Se o usuário do Kaggle modificou substancialmente os dados, sua publicação pode integrar a cadeia de proveniência.
Se o conjunto reproduz uma fonte institucional, essa origem também pode precisar ser reconhecida.
Não atribua automaticamente a autoria dos registros ao usuário que realizou o upload.
É melhor citar a página principal do GitHub ou um commit específico?
Quando o estado dos arquivos é relevante, uma identificação estável pode oferecer maior precisão
A página principal de um projeto pode refletir alterações posteriores.
Um commit, tag ou release pode ajudar a identificar o estado utilizado.
Se houver uma publicação arquivada com DOI correspondente à versão, ela também merece avaliação.
Entretanto, o identificador técnico não substitui automaticamente os demais elementos bibliográficos.
É necessário reconhecer a natureza do recurso: dataset, software, documentação ou outro objeto.
Posso copiar diretamente a citação apresentada no arquivo CITATION.cff?
Utilize os metadados como apoio, mas confira o objeto e adapte a apresentação
O arquivo CITATION.cff pode apresentar informações úteis sobre responsabilidade, título, versão e identificadores.
Entretanto, uma citação sugerida pelo projeto pode estar estruturada em outro estilo bibliográfico.
Antes de utilizá-la:
- verifique se corresponde ao recurso utilizado;
- confira a versão;
- valide o identificador;
- identifique os responsáveis;
- adapte a apresentação às regras aplicáveis ao TCC.
O CITATION.cff não substitui a ABNT NBR 6023.
Se utilizei apenas três variáveis de um dataset, preciso citar cada variável?
Em geral, a referência identifica o recurso, enquanto a metodologia descreve a seleção
Um dataset pode possuir identidade bibliográfica própria, mesmo quando o pesquisador utiliza apenas parte dos registros.
As variáveis selecionadas devem ser documentadas quando forem relevantes para compreender a análise.
Não existe necessidade automática de criar uma referência independente para cada variável.
Entretanto, se o sistema disponibiliza subconjuntos ou tabelas como objetos independentes, essa organização deve ser considerada.
Como citar um dataset composto por vários arquivos CSV ou Excel?
Verifique se os arquivos pertencem a um conjunto com identidade bibliográfica própria
Um repositório pode disponibilizar diversos arquivos sob um único registro de dataset.
Nesse caso, a referência pode identificar o conjunto publicado, enquanto a metodologia especifica quais arquivos foram utilizados.
Se determinados arquivos possuírem registros independentes, a identificação bibliográfica poderá exigir outra análise.
O número de arquivos, isoladamente, não determina o número de referências.
Se criei um dataset derivado, devo citar apenas a minha nova base?
Não elimine a proveniência das fontes utilizadas na construção do conjunto
Um dataset derivado pode possuir identidade própria quando é publicado como recurso independente.
Entretanto, isso não significa que os dados de entrada deixaram de ter origem.
Quando as fontes originais são relevantes para compreender a construção do conjunto, sua identificação deve ser preservada.
A metodologia precisa explicar as transformações realizadas.
Isso pode envolver:
- seleção;
- limpeza;
- integração;
- recodificação;
- agregação;
- criação de indicadores.
Como citar duas bases utilizadas para produzir uma única tabela?
Reconheça as fontes de entrada e diferencie a elaboração própria dos dados originais
Quando uma tabela resulta da combinação de dois datasets, é importante preservar a origem de ambos.
Uma indicação estrutural possível é:
Fonte: elaboração própria a partir de dados de [Fonte A] e [Fonte B].
As referências devem identificar adequadamente os recursos utilizados.
A metodologia deve explicar a integração e os cálculos relevantes.
A indicação da fonte da tabela não substitui automaticamente a documentação bibliográfica.
Preciso incluir nas referências a planilha que criei com respostas do meu questionário?
Não automaticamente: diferencie dados internos de um dataset publicado
Se o estudante coleta respostas e organiza uma planilha apenas para a própria pesquisa, a metodologia deve documentar a produção e o tratamento desses dados.
Não é necessário presumir que toda planilha interna constitui uma publicação independente que exige referência bibliográfica própria.
Se o conjunto for posteriormente depositado em repositório com identidade própria, a situação muda.
Também devem ser observadas as exigências éticas e de proteção de dados aplicáveis.
Como documentar dados restritos sem disponibilizar os arquivos?
Identifique a origem e o procedimento dentro dos limites permitidos
A metodologia pode explicar a natureza dos dados, o contexto de obtenção, os critérios de seleção e os tratamentos realizados, desde que isso não viole restrições aplicáveis.
Quando houver uma página pública de descrição do recurso, ela pode auxiliar sua identificação.
Não invente disponibilidade pública.
Também não divulgue:
- dados pessoais protegidos;
- credenciais;
- arquivos confidenciais;
- informações cuja publicação não foi autorizada.
Rastreabilidade deve ser compatível com as responsabilidades éticas, legais e institucionais da pesquisa.
Por que uma referência correta não substitui a descrição da metodologia?
Porque identificar a fonte é diferente de explicar como os dados foram utilizados
A referência bibliográfica responde principalmente:
Qual recurso foi utilizado?
A metodologia responde:
Como os registros foram obtidos, selecionados, tratados e analisados?
Um dataset pode estar perfeitamente identificado, mas o leitor ainda não saber:
- quais variáveis foram selecionadas;
- qual período foi analisado;
- quais filtros foram aplicados;
- quais registros foram excluídos;
- quais transformações foram realizadas.
Por isso, as duas camadas são complementares.
A indicação da fonte abaixo de uma tabela substitui a referência bibliográfica?
Não se deve presumir essa equivalência
A indicação da fonte de uma tabela ou gráfico tem função de atribuição e esclarecimento da origem dos dados apresentados.
A referência bibliográfica identifica o recurso utilizado conforme as regras aplicáveis.
Essas funções podem estar relacionadas, mas não são idênticas.
Quando a tabela utiliza dados externos, é importante manter coerência entre:
- indicação da fonte;
- referência;
- citação no texto, quando pertinente;
- metodologia.
O que fazer quando encontro modelos diferentes para citar o mesmo dataset?
Compare a natureza do objeto, os metadados e as normas aplicáveis
Modelos diferentes podem surgir porque:
- foram elaborados para tipos distintos de recursos;
- seguem estilos bibliográficos diferentes;
- utilizam edições normativas diferentes;
- interpretam responsabilidades de maneira distinta;
- foram produzidos com metadados incompletos.
Antes de escolher, verifique o registro original.
Em seguida, confira a ABNT NBR 6023 aplicável e o manual acadêmico da instituição.
Não escolha um modelo apenas porque aparece em primeiro lugar em uma busca na internet.
Posso usar inteligência artificial para montar referências de datasets?
Como apoio à organização, desde que todos os metadados sejam verificados
Ferramentas de inteligência artificial podem auxiliar na organização de informações bibliográficas e na revisão preliminar de modelos.
Entretanto, podem produzir:
- autores inexistentes;
- datas incorretas;
- DOIs inventados;
- títulos alterados;
- confusão entre artigo e dataset;
- informações incompatíveis com a versão utilizada.
Por isso, a referência final deve ser conferida diretamente nos metadados do recurso.
O estudante também deve observar as orientações institucionais relativas ao uso de inteligência artificial em atividades acadêmicas.
Para aprofundar esse tema, consulte o guia sobre como citar inteligência artificial nas normas ABNT.
Qual é a pergunta mais importante antes de finalizar a referência de um dataset?
Verifique se a referência identifica exatamente o objeto que sustentou sua pesquisa
Essa é a pergunta central porque orienta todas as demais decisões.
Depois de identificar o objeto, torna-se possível verificar:
- responsabilidade;
- título;
- data;
- versão;
- identificador;
- localização;
- forma de citação;
- documentação metodológica.
Sem essa identificação inicial, uma referência pode apresentar todos os elementos formais e ainda assim apontar para o recurso errado.
Em resumo
As dúvidas mais complexas sobre citação de datasets não são resolvidas pela simples cópia de modelos. Elas exigem identificar o objeto, compreender os metadados, distinguir responsabilidades, preservar versões e documentar o uso dos registros.
O princípio permanece o mesmo: a referência deve representar o objeto real, e a metodologia deve explicar o percurso dos dados até os resultados.
Conclusão: como citar base de dados e dataset nas normas ABNT com segurança
Citar uma base de dados ou um dataset corretamente exige mais do que encontrar um modelo de referência e substituir alguns campos.
O primeiro passo é descobrir qual objeto foi realmente utilizado na pesquisa.
Esse objeto pode ser:
- uma base de dados;
- um dataset;
- uma tabela;
- uma série histórica;
- um conjunto de microdados;
- um arquivo;
- uma resposta obtida por API;
- um dataset derivado;
- um documento metodológico;
- um artigo associado aos dados.
Esses objetos podem estar relacionados, mas não devem ser tratados automaticamente como equivalentes.
A identificação do objeto vem antes da formatação
Ao longo deste guia, vimos que muitos erros surgem porque o pesquisador começa pelo final.
Ele procura uma fórmula pronta antes de descobrir:
- quem é responsável pelos dados;
- qual é o título oficial;
- qual versão foi utilizada;
- se existe DOI ou outro identificador;
- qual repositório ou sistema disponibiliza o recurso;
- qual estado dos dados participou da análise.
Por isso, quando surgir uma dúvida, volte primeiro aos metadados.
Depois, determine qual estrutura bibliográfica representa adequadamente o objeto encontrado.
Visão do especialista
A pergunta mais importante não é simplesmente “qual é o modelo ABNT para dataset?”. A pergunta anterior é: “qual objeto estou tentando identificar?”
Para compreender melhor a importância dos identificadores persistentes na identificação e localização de conjuntos de dados científicos, consulte as orientações da DOI Foundation, organização responsável pelo sistema DOI, amplamente utilizado em publicações acadêmicas e repositórios de pesquisa.
Referência, citação e metodologia não são a mesma coisa
Outra conclusão fundamental é que a documentação dos dados acontece em diferentes camadas.
A referência ajuda a identificar o objeto.
A citação atribui ao responsável uma informação, dado ou ideia utilizada no texto.
A metodologia explica como os dados entraram na pesquisa e o que aconteceu com eles.
A fonte de uma tabela ou gráfico ajuda a preservar a origem dos números apresentados naquele elemento.
Essas camadas se complementam.
Uma referência bibliográfica não precisa carregar todos os filtros, transformações e decisões analíticas.
Ao mesmo tempo, uma metodologia extremamente detalhada não elimina a necessidade de identificar adequadamente as fontes utilizadas.
Versão e estado dos dados podem ser decisivos
Datasets podem mudar.
Uma nova versão pode:
- acrescentar registros;
- corrigir valores;
- modificar variáveis;
- alterar documentação;
- substituir arquivos;
- corrigir erros metodológicos.
Por isso, sempre que o estado dos dados puder afetar os resultados, registre elementos que permitam situar aquilo que foi efetivamente analisado.
Dependendo da fonte, isso pode envolver:
- versão;
- release;
- DOI específico;
- commit;
- snapshot;
- data de extração;
- período;
- arquivos utilizados.
Isso não significa que todos esses elementos sejam obrigatórios em qualquer referência.
Significa que a documentação precisa ser proporcional à natureza do recurso e às necessidades de rastreabilidade da pesquisa.
DOI ajuda, mas não resolve tudo
Um DOI pode facilitar significativamente a identificação persistente de um dataset.
Entretanto:
- nem todo dataset possui DOI;
- um dataset sem DOI não é automaticamente inadequado;
- um dataset com DOI não é automaticamente confiável;
- o DOI do artigo não deve ser confundido com o DOI do dataset;
- um DOI não substitui a avaliação metodológica dos dados.
O identificador é uma peça da documentação, não um certificado universal de qualidade.
Plataforma não significa autoria
Zenodo, SciELO Data, Kaggle, GitHub, Dataverse, Figshare, Dryad, OSF e outros ambientes podem exercer funções importantes na disponibilização dos dados.
Isso não significa que sejam automaticamente os autores dos conjuntos hospedados.
Antes de montar a referência, diferencie:
criador → instituição responsável → repositório → plataforma → arquivo.
Essas funções podem coincidir em determinadas situações, mas não devem ser presumidas como equivalentes.
O formato do arquivo também não é a fonte
CSV, XLSX, JSON, XML, Parquet, SAV, DTA, RData e RDS descrevem formatos de armazenamento ou representação.
Eles não respondem automaticamente:
- quem produziu os dados;
- qual dataset está sendo utilizado;
- qual versão foi analisada;
- qual instituição responde pelo recurso.
Da mesma forma, Excel, R, Python, SPSS ou Stata podem participar do processamento sem serem a origem dos registros.
Dados transformados continuam tendo uma história
Quando o pesquisador:
- limpa registros;
- remove duplicidades;
- trata ausentes;
- recodifica variáveis;
- calcula indicadores;
- converte unidades;
- deflaciona valores;
- combina bases;
- cria um dataset derivado,
o produto final pode ficar bastante diferente dos arquivos originais.
Mesmo assim, a proveniência não desaparece.
A cadeia precisa permanecer compreensível:
fonte → objeto → versão ou estado → recorte → tratamento → análise → resultado.
Quanto mais complexa a análise, mais importante é a proveniência
Uma pesquisa que utiliza uma única tabela pode exigir documentação relativamente simples.
Outra pode envolver:
API A + dataset B + microdados C → limpeza → harmonização → integração → variáveis derivadas → base analítica → modelo estatístico → resultados.
Nesse segundo caso, apenas uma lista de referências bibliográficas não consegue explicar todo o percurso.
A metodologia passa a exercer papel central na rastreabilidade.
O objetivo não é complicar artificialmente a referência
Documentação rigorosa não significa transformar cada referência em um parágrafo gigantesco.
O objetivo é distribuir corretamente as informações.
| Camada | Pergunta principal |
|---|---|
| Referência | Qual objeto foi utilizado? |
| Citação | A quem esta informação está sendo atribuída? |
| Metodologia | Como os dados foram obtidos, selecionados e tratados? |
| Fonte da tabela/gráfico | De onde vieram os números apresentados? |
| Proveniência | Como os dados chegaram da origem ao resultado? |
Essa separação deixa o trabalho mais claro e reduz tanto a omissão de informações importantes quanto o excesso de detalhes no lugar errado.
Se estiver em dúvida, volte ao objeto
Quando uma nova situação não se encaixar perfeitamente em nenhum exemplo deste guia, não tente forçá-la.
Volte às perguntas fundamentais:
- O que exatamente utilizei?
- Quem responde por esse objeto?
- Qual é seu título oficial?
- Existe versão ou estado identificável?
- Existe DOI ou outro identificador?
- Onde o recurso está disponível?
- Qual parte foi utilizada?
- O que foi transformado?
- Como esses dados chegaram aos resultados?
A partir dessas respostas, fica muito mais fácil decidir o que pertence à referência e o que deve ser explicado na metodologia.
Em resumo
Para citar uma base de dados ou dataset com consistência, identifique primeiro o objeto, preserve seus metadados reais e mantenha correspondência entre referência, citação, metodologia e resultados. DOI, versão, repositório, data de extração, scripts e outros elementos devem ser utilizados quando forem pertinentes ao recurso e à pesquisa — não como campos artificiais que precisam aparecer em qualquer situação.
Continue aprendendo sobre citações e referências ABNT
A citação de dados frequentemente se conecta a outros tipos de fontes utilizadas em trabalhos acadêmicos. Os guias abaixo ajudam a resolver situações relacionadas.
- Como citar software nas normas ABNT — para programas, aplicativos, bibliotecas e ferramentas utilizadas na pesquisa.
- Como citar inteligência artificial nas normas ABNT — para compreender os cuidados necessários ao documentar ferramentas de IA em trabalhos acadêmicos.
- Como citar imagens, figuras, gráficos e tabelas nas normas ABNT — especialmente útil quando datasets são transformados em elementos visuais.
- Como fazer referência de site nas normas ABNT — importante para diferenciar uma página web comum de um dataset disponibilizado online.
- Como citar relatório nas normas ABNT — útil quando os dados aparecem acompanhados de relatórios estatísticos, técnicos ou institucionais.
- Como citar documento institucional nas normas ABNT — para documentos produzidos por órgãos públicos, universidades, organizações e instituições.
- Referências ABNT — para revisar a estrutura geral das referências utilizadas no trabalho.
- Citações ABNT — para compreender como atribuir corretamente informações e fontes no corpo do texto.
- Como fazer referências ABNT — guia complementar para organizar diferentes tipos de documentos na lista de referências.
Boa prática
Quando um mesmo projeto utiliza dataset, software, artigo científico e documentação institucional, trate cada objeto de acordo com a função que exerceu na pesquisa. Evite transformar todos eles em uma única referência genérica.
Referências normativas e técnicas
Este guia foi estruturado considerando normas de documentação acadêmica, princípios de citação de dados e práticas de rastreabilidade aplicáveis à pesquisa científica.
Normas ABNT
- ASSOCIAÇÃO BRASILEIRA DE NORMAS TÉCNICAS. ABNT NBR 6023: Informação e documentação — Referências — Elaboração. Rio de Janeiro: ABNT, 2025.
- ASSOCIAÇÃO BRASILEIRA DE NORMAS TÉCNICAS. ABNT NBR 10520: Informação e documentação — Citações em documentos — Apresentação. Rio de Janeiro: ABNT, 2023.
- ASSOCIAÇÃO BRASILEIRA DE NORMAS TÉCNICAS. ABNT NBR 14724: Informação e documentação — Trabalhos acadêmicos — Apresentação. Rio de Janeiro: ABNT, 2024.
Princípios de citação de dados
- FORCE11. Joint Declaration of Data Citation Principles. Disponível em: https://force11.org/info/joint-declaration-of-data-citation-principles-final/. Acesso em: setembro de 2026.
- FORCE11. Data Citation FAQs for Publishers. Disponível em: https://force11.org/group/pages/data-citation-faqs-for-publishers/. Acesso em: setembro de 2026.
Repositórios e documentação de versionamento
- ZENODO. Versioning. Disponível em: https://zenodo.org/help/versioning. Acesso em: setembro de 2026.
- SCIELO DATA. Repositório de dados de pesquisa. Disponível em: https://data.scielo.org/. Acesso em: setembro de 2026.
- SCIELO. Guia de preparação de dados de pesquisa para depósito no SciELO Data. Disponível em: https://wp.scielo.org/wp-content/uploads/Guia_preparacao_pt.pdf. Acesso em: setembro de 2026.
Documentação das fontes utilizadas
Quando a pesquisa utiliza dados provenientes de instituições como IBGE, DATASUS, Banco Mundial ou outros provedores, consulte também a documentação oficial do produto, sistema, pesquisa, indicador ou API efetivamente utilizado.
Essa documentação pode conter informações essenciais sobre:
- metodologia de coleta;
- definições das variáveis;
- códigos;
- mudanças metodológicas;
- atualizações;
- cobertura;
- limitações;
- condições de uso.
Atenção
As recomendações de FORCE11, repositórios científicos e iniciativas de ciência aberta são utilizadas neste guia como referências de boas práticas de citação, identificação, versionamento e proveniência de dados. Elas não devem ser confundidas com normas ABNT nem apresentadas como exigências normativas universais.
Nota editorial
Ao longo do guia, procuramos distinguir quatro níveis que frequentemente são confundidos:
- normas ABNT — estabelecem critérios normativos relacionados à documentação acadêmica;
- orientações institucionais — podem complementar ou operacionalizar a aplicação das normas em universidades, cursos, programas e periódicos;
- recomendações de repositórios e provedores de dados — podem indicar formas específicas de citar ou identificar seus recursos;
- boas práticas científicas — podem ampliar rastreabilidade, transparência, reprodutibilidade e preservação da proveniência.
Elementos como DOI de versão, snapshots, commits, scripts, APIs, registros de extração e documentação detalhada de proveniência podem ser extremamente úteis em determinadas pesquisas.
Isso não significa que todos sejam requisitos universais da ABNT para qualquer dataset.
Da mesma forma, os modelos apresentados neste artigo são estruturas adaptáveis.
Datasets variam amplamente em:
- autoria;
- responsabilidade;
- versionamento;
- identificadores;
- forma de disponibilização;
- granularidade;
- dinâmica de atualização;
- condições de acesso.
Por isso, confira sempre os metadados do objeto real antes de adaptar um exemplo.
Antes da entrega definitiva do TCC, monografia, dissertação, tese ou artigo, consulte também:
- o manual vigente da sua instituição;
- as orientações da biblioteca;
- as exigências do curso ou programa;
- as normas editoriais do periódico, quando aplicável;
- a documentação oficial da fonte de dados utilizada.
Verificação final antes de entregar o trabalho
Depois de revisar referências, citações, metodologia, tabelas e gráficos, faça uma última pergunta:
Um leitor consegue descobrir quais dados utilizei, de onde eles vieram, qual versão ou estado analisei e como esses dados se transformaram nos resultados apresentados?
Se a resposta for sim, existe uma cadeia documental compreensível.
Se a resposta for não, descubra em qual ponto a rastreabilidade foi perdida.
Use esta sequência final:
fonte → objeto → versão ou estado → recorte → tratamento → análise → resultado.
Ela resume a lógica central deste guia e pode ser utilizada como auditoria final sempre que um trabalho acadêmico depender de dados produzidos, disponibilizados ou processados digitalmente.